TPU 与脉动阵列
权重留在格子里,输入从左边流进来,部分和往下传:读一次,用很多次。
向下滚动
能做到什么
第一代 TPU 是 Google 自己设计的芯片,2015 年起在数据中心里给神经网络做推理,也就是用训练好的网络算出结果。它的核心是一块 256 × 256 的矩阵乘法单元:65,536 个 8 位整数乘加器,每秒最多 92 万亿次运算。
2017 年的论文拿它和同一批数据中心里的 Intel Haswell CPU、NVIDIA K80 GPU 比,用的是 Google 自己的六个推理应用。按论文的加权平均,它的速度约是 K80 的 15 倍、Haswell 的 30 倍;不算服务器主机的耗电,每瓦性能是 K80 的约 29 倍、Haswell 的约 83 倍。
台上左边是第一代 TPU 的电路板;右边是它的矩阵乘法单元放大后的样子,一块 8 × 8 的脉动阵列,真的有 256 × 256 格。蓝色的块是输入,红色的是部分和,铜色的板是权重。
第一代 TPU:65,536 个 8 位乘加器 · 每秒 92 万亿次 · 约为同期 GPU 的 15 倍、CPU 的 30 倍
神经网络在做乘法
神经网络的一层是一组“神经元”:每个都把上一层的输出乘上各自的权重,加起来,再过一个非线性函数,比如把负数变成 0。一层里所有神经元的乘加合在一起,就是一次矩阵乘法:输入向量乘权重矩阵。
一次处理一批输入,就是矩阵乘矩阵。全连接层、卷积层、LSTM 的门,最费时的都是这些乘加;非线性函数和池化,在 TPU 上由矩阵单元以外的电路来做。
论文列出 2016 年 7 月部署的 TPU 在跑什么:多层感知机约占 61 %,LSTM 约 29 %,卷积网络约 5 %。论文挑的六个应用,代表了 TPU 工作量的 95 %。
2016 年 7 月部署的 TPU:多层感知机 61 % · LSTM 29 % · 卷积网络 5 %
一个乘加单元
阵列的每一格只做一件事:把流进来的输入 x 乘上自己存着的权重 w,加到从上一格传来的部分和 s 上;然后把 x 传给右边的格子,把新的和传给下面的格子。
第一代 TPU 的乘法是 8 位整数:乘积 16 位,累加用 32 位。论文引用的数据是,8 位整数乘法的能耗和面积,都只有 16 位浮点乘法的约六分之一。
训练用的是浮点数。推理之前先把权重换成 8 位整数,这一步叫量化;论文说,对推理通常够用。
一格:s ← s + x · w · 8 位 × 8 位 → 16 位 · 累加用 32 位
脉动阵列
论文的图 4 是这样画的:权重从上面装进阵列,之后不动;数据从左边流进来;部分和往下走。每过一个时钟,每个数都往前挪一格。这种结构叫脉动阵列,名字来自心脏的收缩:数据随着时钟,一下一下流过格子。
输入要斜着排好再送进去:第二行比第一行晚一拍,第三行再晚一拍。于是一次乘加像一道斜着的波前,从左上扫到右下;每一列的下面,接出一个算完的和,送进累加器。
对软件来说,好像一下子读进 256 个输入,一下子更新了 256 个累加器。台上是 8 × 8 的缩小版,每一拍放慢到半秒多。
权重从上装入 · 数据从左流入 · 部分和向下 · 每个时钟挪一格
读一次,用很多次
论文写道:读一块大的 SRAM 比做算术耗电得多,所以矩阵单元用脉动的方式执行,减少对统一缓冲区的读写。
在 256 × 256 的阵列里,一个输入读进来一次,沿着一行用 256 次;一块权重装进来一次,对一批里的每一行输入都用一次。没有格子之间的传递,每做一次乘加就要取两个数。
以论文里 MLP0 用的批量算,一批 200 行:逐个乘加要取约 2,620 万个数,脉动阵列只读约 11.7 万个,前者约是后者的 225 倍。这是本页按模型算的。
256 × 256,一批 200 行:逐个乘加取约 2,620 万个数 · 脉动阵列读约 11.7 万个
剖开封装
论文照片里的第一代 TPU 装在一块电路板上,能插进服务器里放 SATA 硬盘的槽位,用 PCIe Gen3 x16 和主机相连。中间银色的方块是封装的盖子,散热器压在它上面。
台上把盖子切掉一角:下面是芯片,芯片和盖子之间是导热膏。芯片用 28 纳米工艺,时钟 700 兆赫,热设计功耗 75 瓦,忙的时候实测约 40 瓦。论文没有给芯片面积的数,只说不到 Haswell 芯片(662 平方毫米)的一半。
切开的那一角下面,是芯片右上方的一块:矩阵乘法单元。板子、盖子和芯片的大小,都是按论文的照片估的。
28 纳米 · 700 兆赫 · 热设计功耗 75 瓦,忙时约 40 瓦 · 芯片不到 331 平方毫米
芯片的版图
论文的图 2 是芯片的版图。24 MiB 的统一缓冲区存放中间结果,占约 29 %;矩阵乘法单元约 24 %。两者加起来,接近芯片的三分之二。
下面是 4 MiB 的累加器(6 %)、激活流水线(6 %)、主机接口和 PCIe,两侧是接 DRAM 的端口。控制只占 2 %;论文写道,CPU 和 GPU 里的控制要大得多,也难设计得多。
台上抬起盖子,按论文的配色画出各块:蓝色存数据,黄色做计算,绿色是输入输出,红色是控制。2018 年 CACM 上的版本把矩阵单元写成 29 %,这里用 ISCA 论文的数。
统一缓冲区 29 % · 矩阵乘法单元 24 % · 累加器 6 % · 激活 6 % · 控制 2 %
等权重
权重放在芯片外的 8 GiB DDR3 内存里,论文叫它权重内存:板上芯片上下两排小黑块就是。它每秒只送 34 GB。
权重经过一个四块深的权重 FIFO 进阵列。一块是 256 × 256 个 8 位数,64 KiB,移进阵列要 256 拍;阵列里存两块,一块在算,下一块在装。
要让阵列跑满,每读一个字节的权重要做约 1,350 次乘加。多层感知机和 LSTM 只有 64 到 200 次,所以六个应用里有四个受内存带宽限制,平均 43 % 的时钟,矩阵单元在等权重。论文用性能模型估计,换上 K80 那样的 GDDR5 内存,运算速度能到约三倍。
权重内存:8 GiB DDR3 · 每秒 34 GB · 平衡点:每字节权重约 1,350 次乘加
训练要浮点
第一代只做推理,Google 训练用的是买来的 GPU。训练要反向传播,要更大范围的数、更多内存,还要很多芯片一起算。2017 年的第二代 TPU 为训练设计:每块芯片两个核,每个核一个 128 × 128 的矩阵单元,乘法用 bfloat16,累加用 32 位浮点。
bfloat16 是 16 位的浮点格式:1 位符号、8 位指数、7 位尾数。指数和 32 位浮点一样宽,表示的范围一样大,只是有效数字少。
数据放进芯片旁边的 HBM 显存(第二代 16 GiB,每秒 700 GB),芯片之间用专门的链路连成 256 块的机群。2018 年的第三代每块芯片四个矩阵单元,每秒 123 万亿次 bfloat16 运算,改用液冷,一个机群 1,024 块。
bfloat16:1 位符号 · 8 位指数 · 7 位尾数 · 乘法用 bfloat16,累加用 32 位
4,096 块芯片
TPU v4 于 2020 年投入使用。每块芯片两个核,每个核有四个矩阵单元,都是 128 × 128;一块芯片每秒做 275 万亿次 bfloat16 运算。封装里芯片的旁边是四个 HBM 堆叠,共 32 GiB,每秒 1,200 GB。
64 块芯片连成 4 × 4 × 4 的立方体,64 个立方体再经过 48 台光路开关,连成一台 4,096 块芯片的机器。开关里是微机电(MEMS)镜子,转动镜子就把光纤改接到别的立方体,光在开关里不变成电。论文写道,这些开关和光学部件不到整台机器成本的 5 %、功耗的 3 %。
后来的机群更大。2025 年的 Ironwood,一个机群有 9,216 块芯片,每块有四个矩阵单元,都是 256 × 256。每块每秒 4,614 万亿次的说法,是按 8 位浮点算的;按 bfloat16 算是 2,307 万亿次。
TPU v4:4,096 块芯片 · 64 个 4 × 4 × 4 立方体 · 48 台光路开关
和同时代的比
第一代比的是 2015 年同一批数据中心里的 Haswell CPU 和 K80 GPU,用 Google 的六个推理应用:约 15 倍(对 GPU)和约 30 倍(对 CPU)是加权平均,含主机的开销。逐个应用看,最少是和 K80 一样快(LSTM1),最多是 CPU 的 71 倍(CNN1)。
TPU v4 的论文:在约 32 块芯片的系统上跑 Google 的应用,速度是 TPU v3 的 2.1 倍,每瓦性能是它的 2.7 倍。论文也和 NVIDIA 的 A100 比过,用 MLPerf 训练 2.0 的公开成绩,双方各用约 4,096 块芯片:BERT 上速度是 A100 的 1.15 倍,ResNet 上是 1.67 倍。在 64 块芯片的系统上,A100 的耗电是它的 1.3 到 1.9 倍。
这些倍数都是某一代和它同时代的芯片,在特定的应用和规模上比出来的;拿去和今天的 GPU 比,没有意义。
第一代对 K80、Haswell:约 15、30 倍 · v4 对 v3:2.1 倍 · v4 对 A100:1.15–1.67 倍
它没有说的
TPU 不是什么都快。它为稠密的矩阵乘法设计;矩阵太小填不满阵列,或者权重还没送到,它就闲着。第一代在六个应用上,平均只有 28 % 的时钟在做矩阵运算,有用的乘加只占峰值的 23 %:平均每秒 21.4 万亿次,不是 92 万亿次。
Google 的文档列出不适合 TPU 的程序:分支很多的、逐元素运算很多的、要高精度算术的,以及训练循环里有自定义运算的。它没有缓存、乱序执行这些通用处理器的机关;论文说,这能部分解释它为什么乘加器多、内存大,却相对小而省电。
脉动阵列也不是 Google 发明的:H. T. Kung 和 Charles Leiserson 1978 年在卡内基梅隆大学提出了它。
第一代,六个应用平均:矩阵单元在算 28 % · 有用的乘加 23 % · 每秒 21.4 万亿次
拆开来看
台子拆成几件:电路板,板上的权重内存,封装的基板,芯片,盖子;右边是阵列的格子、后面的权重 FIFO 和前面的累加器。
盖子的底面贴着导热膏,抬起来就是芯片的版图。阵列的每一格,都是一个乘加单元。
板子和芯片的尺寸都是按照片估的,离板的高度放大了 1.5 倍。
电路板 · 权重内存 · 基板 · 芯片 · 盖子 · 乘加单元 · 权重 FIFO · 累加器
实验台
拉杆选一批输入有几行,从 1 到 32;还可以选权重占多大:8 × 8 占满阵列,8 × 4 和 4 × 4 只用一部分格子。按“运行”:权重先从后面一行行移进阵列,再让输入流过,算一次矩阵乘法。
读数数的是这个 8 × 8 的模型:装权重和计算各用几拍,做了多少次乘加,阵列的格子有多少时间在做有用的乘加,从内存读了多少个数(和逐个乘加要取的数比)。
一批越大,装满和排空阵列的那几拍越不显眼。这是模型:真的矩阵单元是 256 × 256,论文说矩阵指令一条接一条流水执行,这几拍可以被下一条指令盖住。
读数:拍数 · 乘加次数 · 利用率 · 读的数
试一试一批只有 1 行输入时,8 × 8 的阵列有多少时间在空等?批量加到 32 呢?权重只占一半的列时又怎样?
模型省略了什么
电路板和芯片按论文的照片和版图画,但论文没有给尺寸:板的大小、零件的大小和芯片的长宽都是估计的,离板的高度放大 1.5 倍;芯片按版图的长宽比、取论文给的面积上限画。盖子切掉一角只是为了看见芯片。阵列是 8 × 8 的缩小版(真的是 256 × 256),每拍放慢到半秒多;数的大小没有画出来,红色的和每加一个乘积就高一截,累加器里的一截是一行结果。真的阵列里权重是整块移进去的,数据和控制都按流水线排好;本页的拍数是一次单独的乘法,不算流水线的重叠。
几个容易误会的地方
TPU 不是什么都比 GPU 快:每个倍数都有条件,比的是同一年代的芯片和 Google 自己的应用。第一代只做推理,不做训练。脉动阵列不是 Google 发明的。8 位整数的“每秒 92 万亿次运算”不能直接和浮点的“每秒多少万亿次浮点运算”比;1,350 这个平衡点数的是乘加,92 万亿次里一次乘加算两次运算。61 %、29 %、5 % 是部署的 TPU 按应用类型分的份额,不是运算量的份额。Ironwood 的 4,614 万亿次是 8 位浮点。光路开关只是改接光纤,芯片并不用光计算。
常见问题 · 5
- TPU 是什么?
第一代 TPU 是 Google 自己设计的芯片,2015 年起在数据中心里给神经网络做推理,也就是用训练好的网络算出结果。
01能做到什么 ↑- 什么是脉动阵列?
论文的图 4 是这样画的:权重从上面装进阵列,之后不动;数据从左边流进来;部分和往下走。
04脉动阵列 ↑- TPU 为什么用脉动阵列?
论文写道:读一块大的 SRAM 比做算术耗电得多,所以矩阵单元用脉动的方式执行,减少对统一缓冲区的读写。
05读一次,用很多次 ↑- bfloat16 是什么格式?
bfloat16 是 16 位的浮点格式:1 位符号、8 位指数、7 位尾数。
09训练要浮点 ↑- TPU 什么都比 GPU 快吗?
TPU 不是什么都快。
12它没有说的 ↑
资料来源
- Jouppi 等(2017):In-Datacenter Performance Analysis of a Tensor Processing Unit,ISCA 2017
- Jouppi、Young、Patil、Patterson(2018):A Domain-Specific Architecture for Deep Neural Networks,Communications of the ACM 61(9)
- Sato、Young、Patterson(2017):An in-depth look at Google’s first Tensor Processing Unit (TPU),Google Cloud 博客
- H. T. Kung、Charles E. Leiserson(1978):Systolic Arrays (for VLSI),卡内基梅隆大学报告 CMU-CS-79-103
- H. T. Kung(1982):Why Systolic Architectures?,IEEE Computer 15(1)
- Norrie 等(2020):Google’s Training Chips Revealed: TPUv2 and TPUv3,Hot Chips 32 报告
- Wang、Kanwar(2019):BFloat16: The secret to high performance on Cloud TPUs,Google Cloud 博客
- Jouppi 等(2023):TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings,ISCA 2023
- Jouppi、Lakshmanamurthy、Young、Patterson(2026):Google’s Training Supercomputers from TPU v2 to Ironwood,IEEE Micro(预印本)
- Google Cloud 文档:TPU architecture
- Google Cloud 文档:Introduction to Cloud TPU
- Google Cloud 文档:TPU7x (Ironwood)
- Vahdat(2025):Ironwood: The first Google TPU for the age of inference,Google 博客
数据
The card follows the photograph of the first TPU’s printed circuit board and the die its floor plan, both in Jouppi et al., “In-Datacenter Performance Analysis of a Tensor Processing Unit” (ISCA 2017), redrawn. The paper gives no dimensions: the card’s size and every part’s are estimates from the photograph, heights are drawn ×1.5, and the die is drawn at the floor plan’s aspect with the paper’s upper bound on its area. The cut through the lid is a drawing choice. The 8 × 8 array, its tokens and the laboratory’s counts are a model of a weight-stationary systolic array (the real matrix unit is 256 × 256), computed by this page (src/topics/tpu/systolic.js, docs/plates/tpu/computed-v1.py). Material presets, parts and the softbox studio of the site’s model kit are ported from AirsupHQ/machine-skill (MIT, © 2026 Air Supply Technologies Inc.).
本页的文字、图片和模型采用 CC BY-NC 4.0 许可:可以免费用于教学和其他非商业用途,可以修改,请注明出自 world.lapla.si。上面列出的第三方素材仍按各自的许可。
引用这幅图版
拉普拉斯的迷你世界,图版 F53《TPU 与脉动阵列》,https://world.lapla.si/zh/tpu/,CC BY-NC 4.0,2026-10-27 更新。
沿这个问题继续
 图版 F51FlashAttention 与显存按标准做法,Transformer 的注意力在 GPU 上慢,多半不是因为算得多,而是要把一张 N × N 的分数矩阵写进显存再读回来。FlashAttention 把计算切成小块,放在芯片上的共享内存里算完,用边走边算的 softmax 得到同一个结果,这张矩阵从不进显存。
 图版 F43大模型量化大语言模型的权重原本每个用 16 位存。量化把它们落到更粗的格子上:8 位、4 位,甚至只剩 −1、0、+1。模型小几倍,读得也快几倍,代价是一点精度。
 图版 F13Transformer 的注意力一个两层、八个头的小 Transformer,在你的浏览器里逐字读一句话,猜下一个字母。每条丝线是一次“注意”,亮度就是它的权重。
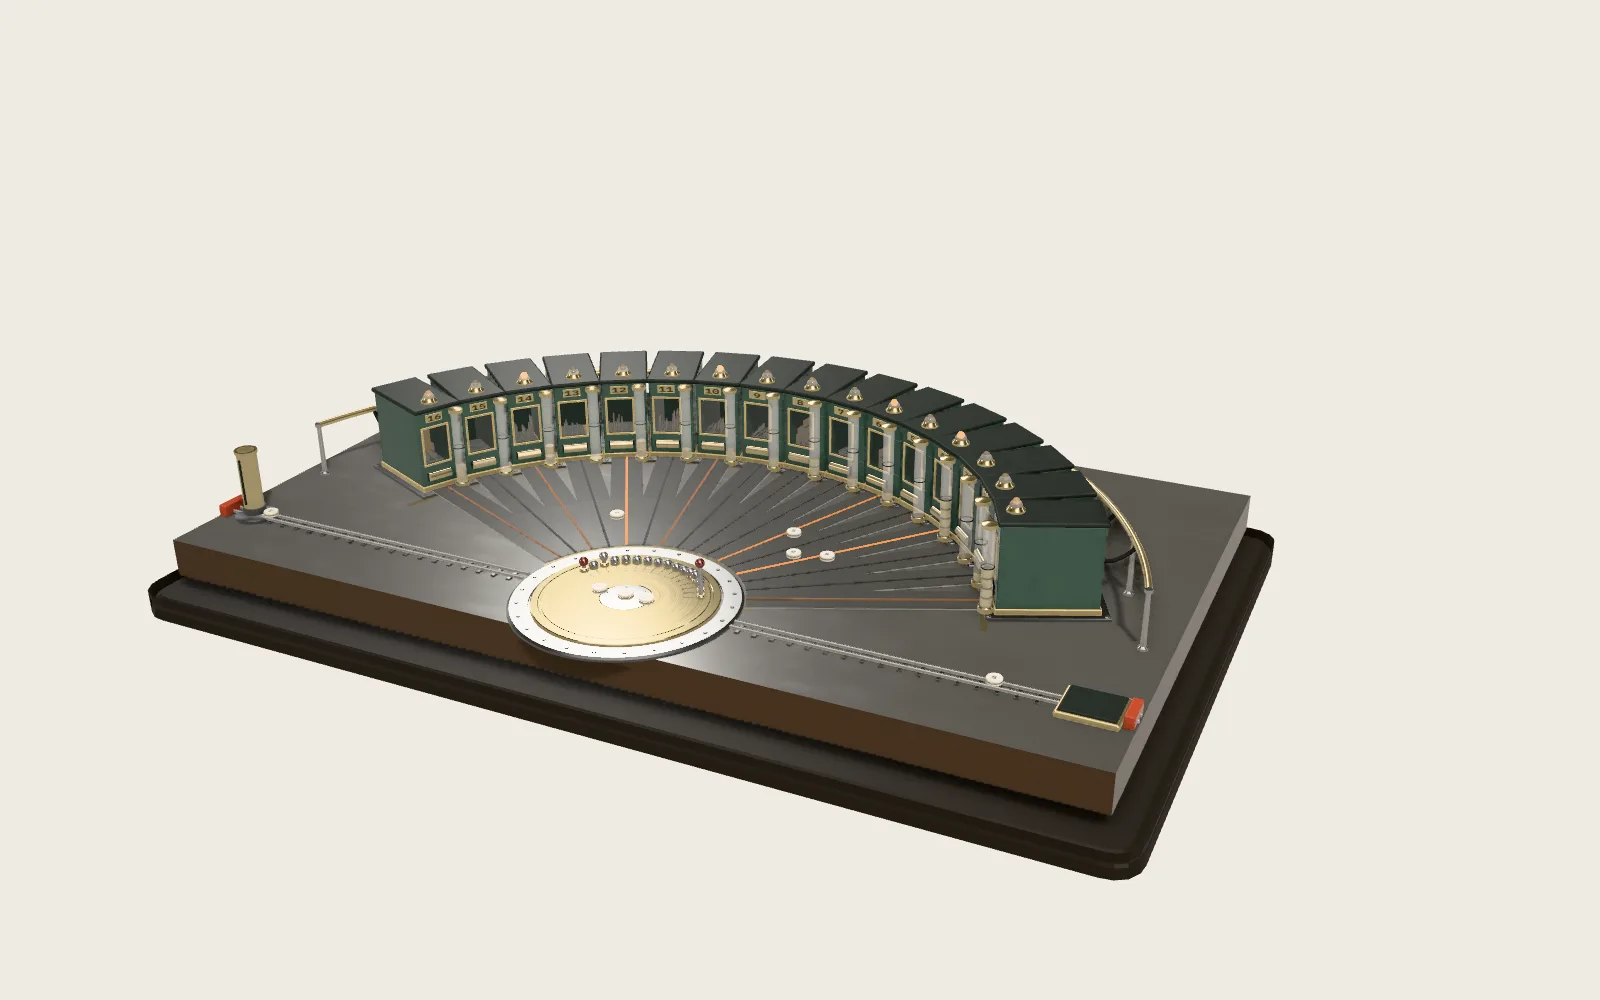 图版 F25混合专家一个模型可以有几千亿个参数,每个词却只动用其中一小部分:路由器给每个词挑出几个“专家”,其余的不动。这里是一个真实训练过的小模型,16 个专家,每个字母只走 2 个。