FlashAttention 与显存
注意力的 N × N 矩阵,不必写进显存。
向下滚动
能做到什么
Transformer 每一层的注意力,要拿序列里每个位置和所有位置比一遍:N 个位置就是一张 N × N 的分数矩阵。标准做法把这张矩阵写进 GPU 的显存(HBM),再读回来做 softmax。2022 年发表的 FlashAttention 算出的是同一个注意力,不是近似,而这张矩阵从不进显存。
论文在 A100 GPU 上量了 GPT-2 medium 的注意力(序列长 1,024,批量 64,前向加反向):读写显存的数据从 40.3 GB 降到 4.4 GB,时间从 41.7 毫秒降到 7.3 毫秒,而运算反而多了约 13 %。它占的显存随序列长度线性增长,而不是平方。
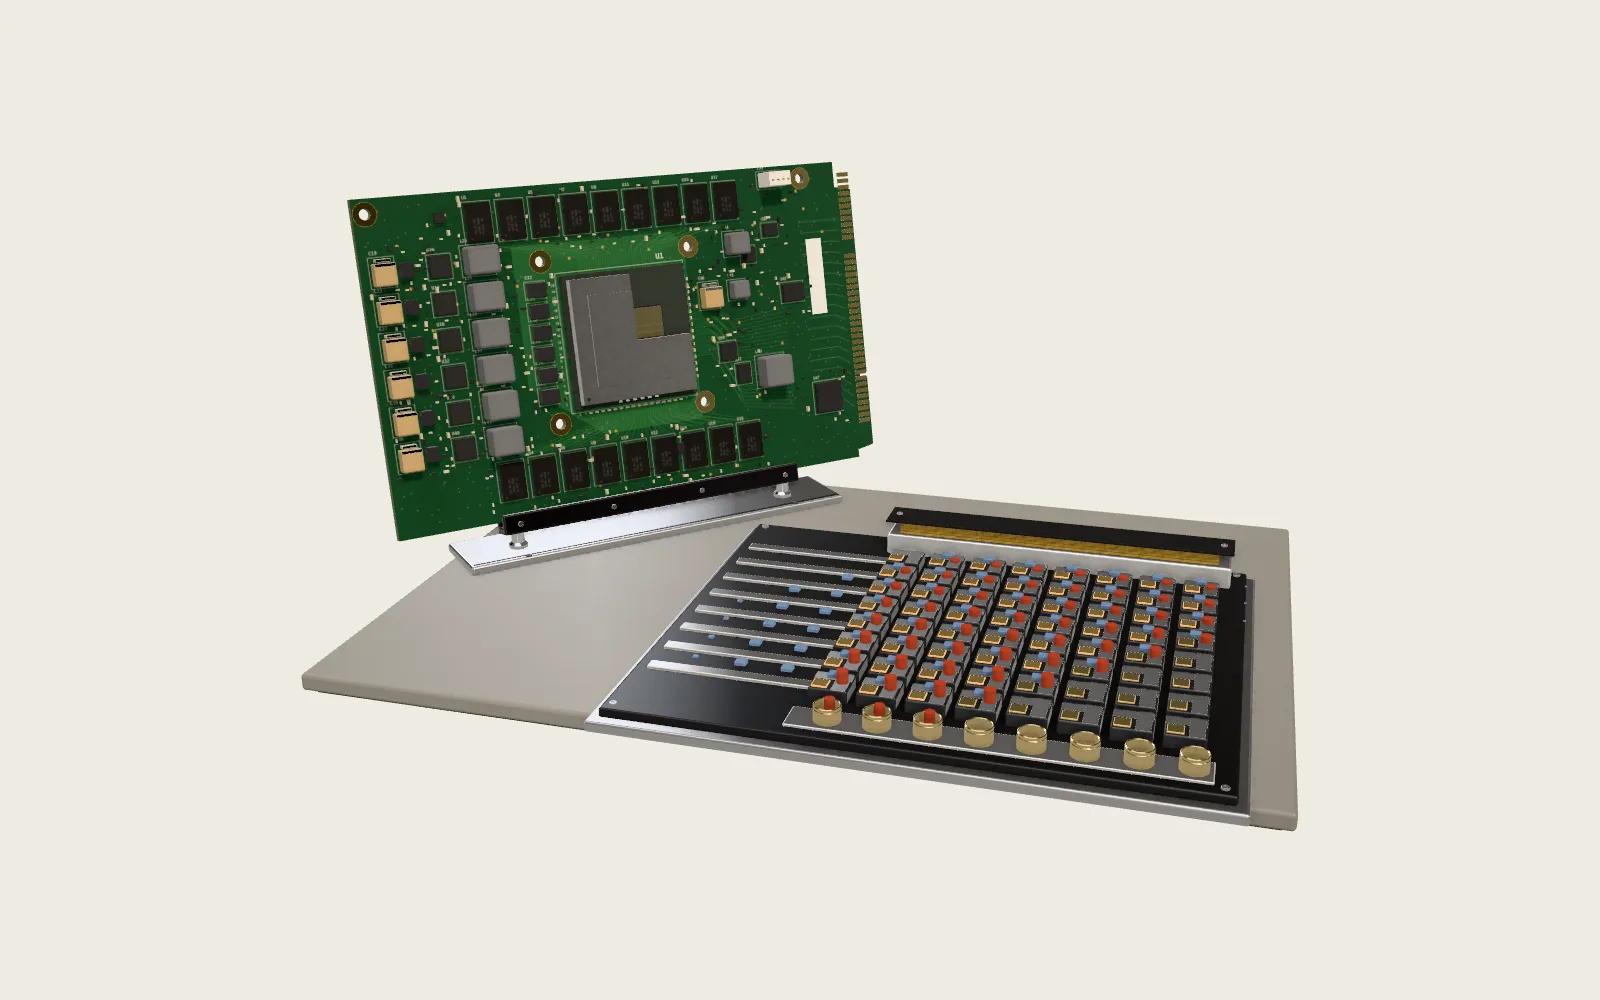
后来的两版更快:第二版(2023)训练 GPT 类模型时,每块 A100 每秒最多做 225 万亿次浮点运算;第三版(2024)在 H100 上前向计算又快 1.5 到 2.0 倍。台上是一块按 NVIDIA H100 SXM5 的布局做的 GPU 封装模型:中间是芯片,两侧是显存堆叠,彩色的小方块是在它们之间搬来搬去的数据。
GPT-2 medium,A100:显存读写 40.3 → 4.4 GB · 41.7 → 7.3 毫秒 · 运算多约 13 %
数据住在哪里
GPU 的存储分几层,越大越慢。以 H100 SXM5 为例:芯片旁边的 HBM 显存共 80 GB,每秒能送 3.35 TB;芯片里的 L2 缓存 50 MB;再往里,132 个流式多处理器(SM)每个有最多 228 KB 的共享内存和 256 KB 的寄存器。
132 个 SM 的共享内存加起来约 30 MB,比显存小两千多倍,但它就在做运算的单元旁边。第三版 FlashAttention 的论文估算,共享内存的总带宽约每秒 31 TB,L2 约每秒 12 TB,都比显存快好几倍。
论文里说的“SRAM”,指的就是这层共享内存和寄存器,不是 L2。台上,芯片两侧的六个方块是显存堆叠的位置:NVIDIA 写明 H100 SXM5 用 5 个 HBM3 堆叠,每个 16 GB,没说第六个位置是什么。中间的大方块是 GH100 芯片,814 平方毫米。
HBM 80 GB · 3.35 TB/s → L2 50 MB → 每个 SM:228 KB 共享内存 · 256 KB 寄存器
算得快,搬得慢
一个运算是快是慢,要看它每搬一个字节做多少次运算。H100 SXM5 的张量核心每秒最多做 989 万亿次 16 位浮点运算,显存每秒送来 3.35 TB:两者相除,每个字节要配约 295 次运算,芯片才不会闲着。
矩阵乘法每读一个数能用很多次,够得上。逐元素和求和类的运算不行,比如 softmax、dropout、掩码:每个数读一次、算几下、写一次,时间都花在搬上。FlashAttention 的论文把这类运算叫作受显存限制(memory-bound)。
按标准做法算(16 位,一个注意力头,头维 d = 128),整个注意力每搬一个字节只做约 62 次运算,离 295 差了近 5 倍;只看 softmax 一步,粗略估算,每个字节大约只有一次。
H100 SXM5:989 万亿次/秒 ÷ 3.35 TB/s ≈ 每字节 295 次 · 标准注意力(d = 128)约 62 次
标准做法:一个来回
标准做法分三步:从显存读入 Q 和 K,算出分数 S = QKᵀ,写回显存;读出 S,算出 P = softmax(S),写回显存;读出 P 和 V,算出 O = PV,写回显存。
以序列长 N = 4,096、头维 d = 128 为例,一个头的 S 是 4,096 × 4,096 个 16 位数,33.6 MB,是 Q 的 32 倍。S 和 P 各写一次、读一次,共 134 MB,在每秒 3.35 TB 的显存上约要 40 微秒;同一个头的两次矩阵乘法,按峰值只要约 8.7 微秒。
训练时,P 还要留到反向传播再读一遍。台上演示的是缩小版,8 × 8 块:红色的分数块飞进显存又飞回来,两次。
N = 4,096,d = 128,一个头:S 33.6 MB · S 和 P 往返 134 MB ≈ 40 微秒 · 矩阵乘法 ≈ 8.7 微秒
剖开封装
显存不在芯片里,在旁边的堆叠里:每个 HBM 堆叠是几层 DRAM 芯片叠在一起,层与层之间用穿过硅片的通孔(TSV)相连。JEDEC 的 HBM3 标准规定 4、8、12 层的堆叠,每层 8 到 32 Gb。H100 的每个堆叠 16 GB,用 16 Gb 的层就是 8 层;NVIDIA 没有写层数,台上画了 8 层。
每个堆叠用 1,024 根数据线和芯片相连。H100 SXM5 的 5 个堆叠共 5,120 位宽,每根线每秒约 5.24 Gb,合起来每秒 3,352 GB,每个堆叠约每秒 670 GB。
在 TSMC 的 CoWoS-S 这类封装里,逻辑芯片和 HBM 并排放在一块大的硅中介层上,由中介层里的高密度连线相连,下面是封装基板和焊球。NVIDIA 没有公布 H100 封装的分层和尺寸,台上按这类封装画出,厚度放大了 4 倍。
HBM3:一个堆叠 1,024 位 · H100 SXM5:5 个堆叠,5,120 位 · 每秒 3,352 GB
芯片里面
GH100 芯片用台积电的 4N 工艺制造,800 亿个晶体管,814 平方毫米。完整的芯片有 8 个图形处理簇(GPC),共 144 个 SM;H100 SXM5 启用其中 132 个。中间是 50 MB 的 L2 缓存(完整芯片 60 MB),两侧是接显存的内存控制器。
每个 SM 有 4 个张量核心,专做小块的矩阵乘法;4 份各 64 KB 的寄存器,共 256 KB;还有 256 KB 的一级缓存兼共享内存,其中最多 228 KB 可作共享内存。FlashAttention 的小块就放在这里。
芯片上方升起的白色铭牌,是 NVIDIA 公布的 GH100 方框图,画在和芯片一样大的板上。它表示芯片由什么组成,不是各部分在芯片上的实际位置。
GH100:814 平方毫米 · 144 个 SM,H100 SXM5 用 132 个 · 每个 SM:4 个张量核心、228 KB 共享内存、256 KB 寄存器
分块
FlashAttention 不把 S 整张算出来。它把 Q 切成每块 B_r 行,K 和 V 切成每块 B_c 行;每次只把一块 Q 和一块 K、V 读进一个 SM 的共享内存,在芯片上算出这一小块分数,马上用掉。
第一版论文按共享内存的大小 M 定块的大小:B_c = ⌈M / 4d⌉,B_r = min(⌈M / 4d⌉, d)。它证明标准做法要 Θ(Nd + N²) 次显存读写,FlashAttention 只要 Θ(N²d²/M):d² 比 M 小得多时,就少很多倍。实际的程序按头维手工挑块,第二版写的是 {64, 128} × {64, 128}。
整个计算融进一个 GPU 程序:读入、矩阵乘法、softmax、掩码、dropout、再乘,最后只把输出 O 写回显存。台上按第二版的顺序:每个 SM 一次处理一块 Q,K、V 一块块飞进来,红色的分数块在芯片上亮一下就没了,算完的 O 块飞回显存。
块:Q 每块 B_r 行,K、V 每块 B_c 行 · 显存读写:标准 Θ(Nd + N²),FlashAttention Θ(N²d²/M)
边走边算的 softmax
softmax 要先知道一整行的最大值和所有指数的和,才能把分数变成权重。切成块以后,一次只看得到一行的一小段。办法是边走边记两个数:到目前为止的最大值 m,和以它为基准的指数和 ℓ。
每来一段,先算这一段的最大值;如果它比 m 大,就把之前的和与之前累积的输出都乘上 e^(m旧 − m新),换到新的基准,再加上这一段。最后一段处理完,结果和一次算整行的 softmax 相同,只差浮点舍入,不是近似。这种在线 softmax 在 2018 年就用来减少 softmax 的显存读写,2021 年用来减少注意力占的内存。
图里是一行 8 个分数,每次 2 个:四步之后 m 是 3.4,ℓ 是 2.170462,输出和直接算的结果相差不到 10⁻¹⁵。
m新 = max(m, m̃) · ℓ新 = e^(m − m新)·ℓ + e^(m̃ − m新)·ℓ̃ · 结果与整行 softmax 相同
反向:重算比读快
训练还要反向传播,它需要 S 和 P。标准做法把 P 存在显存里,到时再读。FlashAttention 只存输出 O 和每行的两个统计量(m 和 ℓ),反向时从 Q、K、V 一块块重新算出 S 和 P;dropout 的掩码也不存,只存随机数发生器的状态,到时重新生成。
这多了运算,却少了搬运。论文在 A100 上量 GPT-2 medium 的注意力(序列长 1,024,头维 64,16 个头,批量 64,前向加反向):运算多约 13 %;显存读写从 40.3 GB 降到 4.4 GB,少约 9 倍;时间从 41.7 毫秒降到 7.3 毫秒,快约 5.7 倍。
所以它额外占的内存只随 N 线性增长:每行只多几个数。
GPT-2 medium,A100,前向 + 反向:运算多约 13 % · 显存读写 40.3 → 4.4 GB · 41.7 → 7.3 毫秒
快了多少,省了多少
省下的显存最明显。在一块 40 GB 的 A100 上(批量 16,8 个头,头维 64),序列长 4,096 时,PyTorch 的标准注意力用了 17,024 MB,FlashAttention 用 836 MB,约少 20 倍。更长的序列,论文的表里标准做法没有数;FlashAttention 到 65,536 时用 13,376 MB。
训练也快了:BERT-large(序列长 512)在 8 块 A100 上比 MLPerf 1.1 的纪录快 15 %;GPT-2(序列长 1K)比 HuggingFace 的实现快约 3 倍,比 Megatron-LM 快约 1.7 倍。每个倍数都有自己的比较对象。
更长的序列也能训练了:在 Path-X(序列长 16K)上,用 FlashAttention 的 Transformer 第一次做到好于瞎猜,61.4 %;更长的 Path-256(64K)用的是分块稀疏的近似版本,63.1 %。
A100 40 GB,N = 4,096:17,024 → 836 MB · BERT-large 快 15 % · GPT-2 比 HuggingFace 快约 3 倍
第二代、第三代
第一版只用到 A100 峰值算力的 25–40 %。第二版(2023)改了三处:减少矩阵乘法以外的运算,因为 A100 的张量核心每秒做 312 万亿次 16 位矩阵运算,普通的 32 位运算只有 19.5 万亿次,每次非矩阵运算贵 16 倍;把一个头的计算也沿序列分给多个线程块,让更多 SM 有活干;在每个线程块里换一种分工,少在线程束之间经共享内存交换结果。结果比第一版快约 2 倍,达到 A100 峰值的 50–73 %。
同样的程序在 H100 上只用到约 35 %。第三版(2024)为 H100 重写:专门的搬运单元(TMA)把块异步地搬进共享内存,一部分线程束(warp)只管搬,另一部分只管算。指数也要错开算:H100 每秒做 989 万亿次矩阵运算,指数这类特殊函数只有 3.9 万亿次,所以一组线程束做 softmax 时,另一组在做矩阵乘法。
结果,前向计算比第二版快 1.5–2.0 倍,16 位最高每秒 740 万亿次,是 989 万亿次峰值的 75 %(NeurIPS 2024 发表的版本是 840 万亿次、85 %;都在头维 256、长序列时);8 位浮点接近每秒 1,200 万亿次(发表版 1,300 万亿次)。
第二版:A100 峰值的 50–73 % · 第三版,H100,前向:740 万亿次/秒(75 %),发表版 840(85 %)
它没有说的
FlashAttention 算的就是原来的注意力,不是近似:结果只差浮点舍入;16 位时误差还比标准实现小,因为中间的 softmax 用 32 位保存。论文里近似的是另一个版本,分块稀疏 FlashAttention。
它没有减少运算:前向一样多,反向因为重算还多一些,运算量仍随 N 的平方增长。它减少的是显存读写,和占用的显存。Q、K、V、O 仍要进出显存,K、V 还要读好几遍。
快多少要看条件:GPU 的显存带宽和共享内存大小、头维、序列长度、有没有掩码和 dropout,都会改变结果;头维 128 时块要变小,加速就少一些。每种注意力的变体都要写新的 GPU 程序,换一代 GPU 也可能要重写。在 TPU 上,一种同类的方法没有看到加速:那里的算力和带宽本来就平衡。
精确,不是近似 · 运算不减,仍随 N² 增长 · 加速随 GPU、头维、序列长度而变
拆开来看
台子分成五件:显存堆叠、GH100 芯片、硅中介层和填满缝隙的模塑料、带电容和焊球的封装基板、展示座。
六个堆叠位置里,H100 SXM5 用了五个,NVIDIA 没说第六个是什么;剖开的那一个画出了 8 层 DRAM 和穿过它们的通孔。
基板上的小方块是电容;切面上能看到基板里的铜层、过孔和下面的焊球。所有厚度都放大了 4 倍。
显存堆叠 · 芯片 · 中介层与模塑料 · 封装基板 · 展示座
实验台
拉杆选序列长度 N,从 512 到 65,536;还可以选头维 d 和块的大小。读数按两种算法数显存读写(16 位,一个头,前向):标准做法读写 Q、K、V、O 各一次,S 和 P 各写一次、读一次;FlashAttention 按第二版的顺序,每块 Q 读一次,每块 Q 都把 K、V 读一遍,O 写一次,不计 L2 缓存的帮助。
块越大,K、V 要读的遍数越少;但一块 Q、K、V 要放进 228 KB 的共享内存,分数块和输出要放进 256 KB 的寄存器。放不下,读数会标出来。
台上的网格是 N × N 的分数矩阵,按块画出,亮的那一块正在 SM 上算。标准做法把整张写进显存,FlashAttention 一块也不写。
读数:S 的大小 · 显存读写(标准 / FlashAttention)· 一块用的共享内存和寄存器
试一试序列长度翻一倍,标准做法的显存读写变成几倍?FlashAttention 呢?头维从 64 换成 128,FlashAttention 省下的倍数变大还是变小?
模型省略了什么
模型不按比例。NVIDIA 只公布了芯片面积 814 平方毫米;芯片的长宽和堆叠、中介层、基板的尺寸都是估计的,厚度放大 4 倍,焊球画得更大、更少。数据只从六个堆叠位置中的五个飞出,剖开的那个不用:NVIDIA 没说哪一个位置空着,也没说第六个是什么,选它只为画图。8 层 DRAM 是按每个堆叠 16 GB、每层 16 Gb 推算的。白色铭牌上是 NVIDIA 的逻辑方框图,不是芯片上的实际布局。飞行的小方块代表矩阵的块:真实的数据在中介层的导线里走,不在空中;块数缩小了(8 × 8),飞得也慢得多。实验台的“放得下”只是粗略的模型:真实的程序还要双缓冲、存别的数,并和别的块共用一个 SM。
几个容易误会的地方
论文里的“SRAM”指 SM 里的共享内存和寄存器,不是 L2 缓存。FlashAttention 不是近似,也不减少运算,它减少的是显存读写;在线 softmax 也不是它首创的。算力数字要分清:NVIDIA 产品页上 16 位的 1,979 万亿次是“使用稀疏”时的数,稠密的是一半,989 万亿次,利用率都相对 989 万亿次。第一版论文的硬件数字(SRAM 19 TB/s、20 MB)是 A100 的估计值,不是 H100 的。每个加速倍数都有自己的模型、GPU、序列长度和比较对象,说明不了“快几倍”这样笼统的话。
常见问题 · 5
- FlashAttention 是近似算法吗?
FlashAttention 算的就是原来的注意力,不是近似:结果只差浮点舍入;16 位时误差还比标准实现小,因为中间的 softmax 用 32 位保存。
12它没有说的 ↑- GPU 每搬一个字节要做多少次运算才不闲着?
H100 SXM5 的张量核心每秒最多做 989 万亿次 16 位浮点运算,显存每秒送来 3.35 TB:两者相除,每个字节要配约 295 次运算,芯片才不会闲着。
03算得快,搬得慢 ↑- 分块算的 softmax 和整行算的一样吗?
最后一段处理完,结果和一次算整行的 softmax 相同,只差浮点舍入,不是近似。
08边走边算的 softmax ↑- FlashAttention 反向传播时存什么?
FlashAttention 只存输出 O 和每行的两个统计量(m 和 ℓ),反向时从 Q、K、V 一块块重新算出 S 和 P;dropout 的掩码也不存,只存随机数发生器的状态,到时重新生成。
09反向:重算比读快 ↑- FlashAttention 能省多少显存?
在一块 40 GB 的 A100 上(批量 16,8 个头,头维 64),序列长 4,096 时,PyTorch 的标准注意力用了 17,024 MB,FlashAttention 用 836 MB,约少 20 倍。
10快了多少,省了多少 ↑
资料来源
- Dao、Fu、Ermon、Rudra、Ré(2022):FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness,NeurIPS 2022
- NeurIPS 2022 论文集页面(FlashAttention)
- Dao(2023):FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning,ICLR 2024
- Shah、Bikshandi、Zhang、Thakkar、Ramani、Dao(2024):FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision(arXiv 版)
- FlashAttention-3,NeurIPS 2024 正式发表版
- Milakov、Gimelshein(2018):Online normalizer calculation for softmax
- Rabe、Staats(2021):Self-attention Does Not Need O(n²) Memory
- flash-attention 代码库(Dao-AILab,BSD 3-Clause)
- NVIDIA:NVIDIA H100 Tensor Core GPU Architecture 白皮书,V1.04
- NVIDIA:H100 产品规格(读于 2026-10-26)
- NVIDIA 技术博客(2022):NVIDIA Hopper Architecture In-Depth
- NVIDIA:Hopper Tuning Guide
- NVIDIA:CUDA C++ Programming Guide 12.6(计算能力 9.0)
- NVIDIA:NVIDIA A100 Tensor Core GPU Architecture 白皮书
- NVIDIA:A100 数据表(2021 年 6 月)
- JEDEC(2022-01-27):HBM3 标准 JESD238 发布
- SK hynix(2022-06-08):为 NVIDIA 供应 HBM3
- TSMC:CoWoS®
数据
The package follows the layout NVIDIA describes for H100 SXM5 (NVIDIA H100 Tensor Core GPU Architecture whitepaper, V1.04): the GH100 die (814 mm², the only published dimension) with six HBM sites beside it, five used. Everything else about its geometry is schematic and not to scale: the die’s sides, the stacks, the interposer and the substrate are estimates after packages such as TSMC’s CoWoS-S, thicknesses are drawn ×4. The plaque carries NVIDIA’s logical block diagram of GH100, redrawn; not the physical layout. The algorithms are those of the FlashAttention papers (Dao et al. 2022; Dao 2023; Shah et al. 2024). The flying blocks, the laboratory’s counts of memory traffic and the online-softmax example are drawn or computed by this page (docs/plates/flashattn/computed.py). FlashAttention’s code is at github.com/Dao-AILab/flash-attention (BSD 3-Clause); none of it runs on this page. Material presets, parts and the softbox studio of the site’s model kit are ported from AirsupHQ/machine-skill (MIT, © 2026 Air Supply Technologies Inc.).
本页的文字、图片和模型采用 CC BY-NC 4.0 许可:可以免费用于教学和其他非商业用途,可以修改,请注明出自 world.lapla.si。上面列出的第三方素材仍按各自的许可。
引用这幅图版
拉普拉斯的迷你世界,图版 F51《FlashAttention 与显存》,https://world.lapla.si/zh/flashattn/,CC BY-NC 4.0,2026-10-26 更新。
沿这个问题继续
 图版 F13Transformer 的注意力一个两层、八个头的小 Transformer,在你的浏览器里逐字读一句话,猜下一个字母。每条丝线是一次“注意”,亮度就是它的权重。
 图版 F26词元与缩放定律大语言模型读的是词元,不是字。模型越大、读的词元越多,误差按一条幂律下降。台上是在浏览器里运行的字节对编码,和一组真实训练过的小模型。
 图版 F33推测解码大模型一次写一个词元,每写一个都要把全部权重从显存里读一遍:慢在读,不在算。推测解码让小模型先猜几个,大模型读一次权重就全部核对完,写出的文字和它自己一个个写的分布完全一样。台上的两个模型和每一个数,都在浏览器里计算。
 图版 F43大模型量化大语言模型的权重原本每个用 16 位存。量化把它们落到更粗的格子上:8 位、4 位,甚至只剩 −1、0、+1。模型小几倍,读得也快几倍,代价是一点精度。