推测解码
一次写一段话时,慢在读权重,不在算。小模型先猜,大模型一次核对,写出的分布一点不变。
向下滚动
一次一个词元
语言模型一次只写一个词元,写下一个之前要先有前一个。每写一个,模型的全部权重都要从显存搬到计算单元过一遍。Llama 3.1 8B 有 8,030,261,248 个参数,用 16 位数存,约 16 GB。
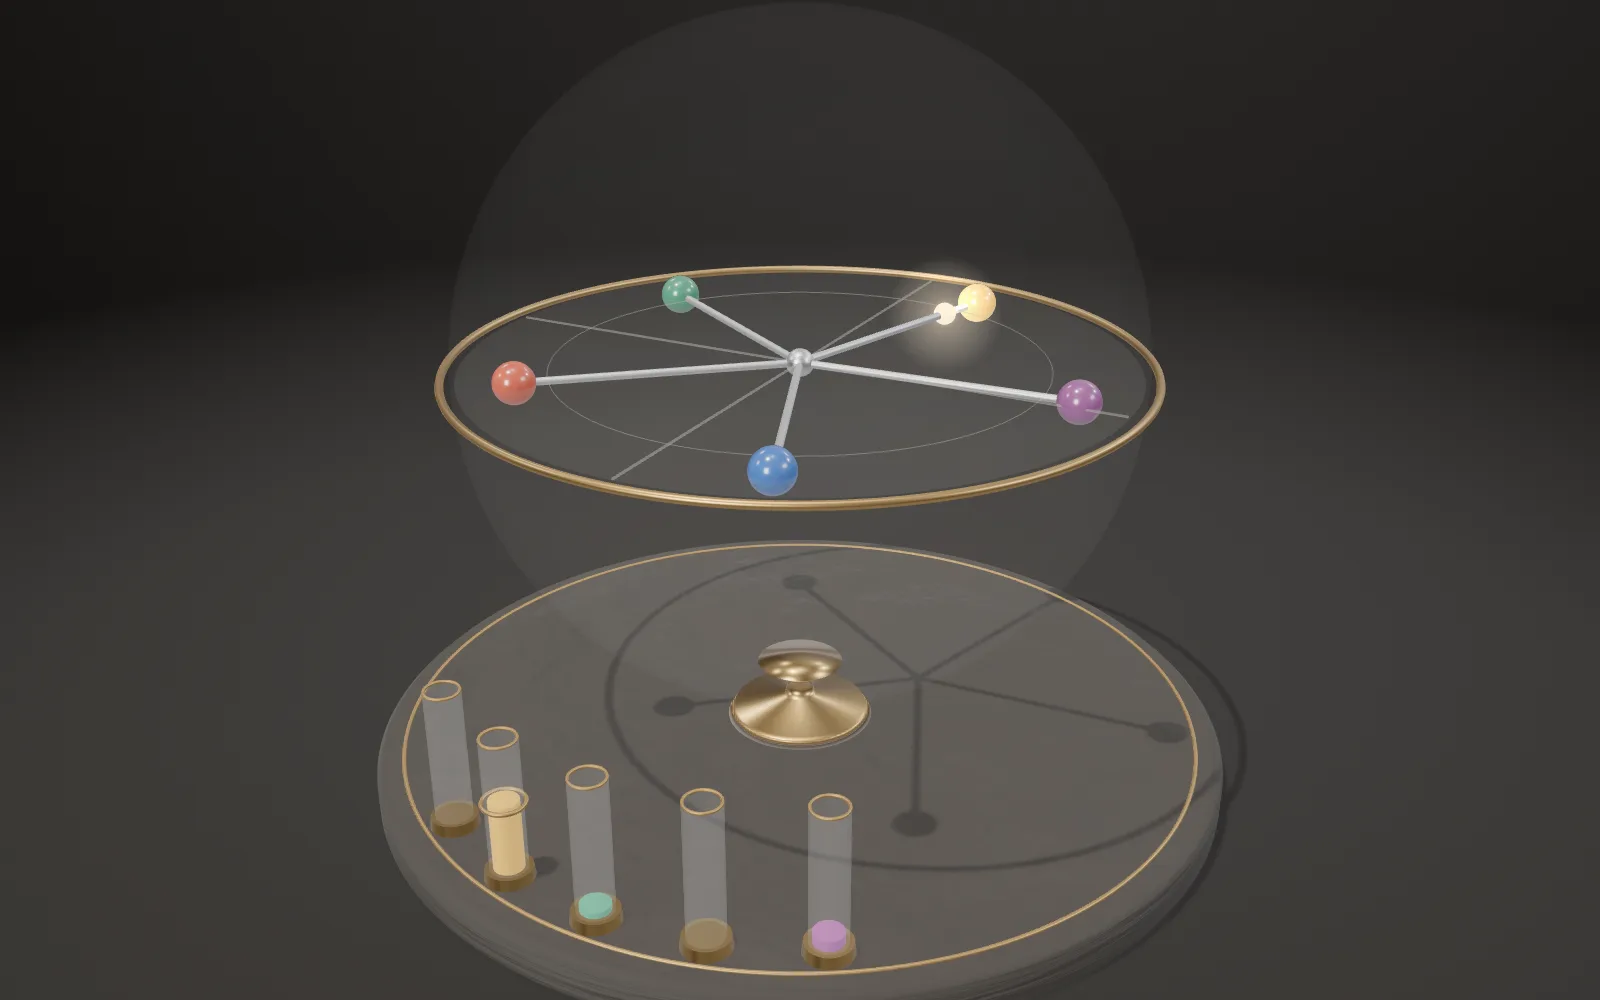
NVIDIA H100 SXM 的显存每秒读 3.35 TB,读完 16 GB 至少要约 4.8 毫秒,所以只写一段话时,每秒最多约 209 个词元。这一步的算术约 160 亿次,按纸面算,H100 不到 0.02 毫秒就做完:算术单元 99.7% 的时间在等数据。台上,大滚筒的钉子就是权重,写一个词元,滚筒要转一整圈。
Llama 3.1 8B · 约 16 GB · H100 每个词元至少 4.8 毫秒(纸面) · 算术只忙 0.3%
几段话一起写
读一遍的权重可以同时给好几段话用:把它们排成一批,每读到一个权重,就为每段各算一次。一批 64 段,读的还是那 16 GB,算术多了 64 倍,按纸面算每秒能写约 13,350 个词元,是一段时的 64 倍。台上,读头点亮几条路,就是一次给几段话算。
H100 每读一个字节能做约 295 次运算,只写一段话时每个字节只用到约 1 次。可每段话还有自己的 KV 缓存要读,这部分不能共用(图版「Transformer 的注意力」讲了缓存是什么):Llama 3.1 8B 每个词元的缓存约 131 KB,每段 4,096 个词元时一批 64 段要多读约 34 GB,每秒约 4,250 个词元。Pope 等人写道,批小、文字短时读权重的时间为主,批大、文字长时读缓存为主。台上右后的柜子一段话一个抽屉:读权重时,每段话的抽屉也要拉开读一遍。
一批 64 段 · 只算权重 22% 的算术在忙 · 加上 4,096 个词元的缓存,每步读约 50 GB
先让小模型猜
只写一段话时,闲着的算术能不能用上?2022 年底到 2023 年初,Google 的 Leviathan 等人和 DeepMind 的 Chen 等人各自给出了同一个办法。一个小得多的模型先往下猜几个词元,大模型再一次把它们全部核对。核对几个词元和写一个几乎一样快:读的是同一遍权重,多出来的只是本来就闲着的算术。先猜后核对的想法更早就有,但只能用于贪心解码;他们的新东西是一条核对规则,随机抽样时写出的分布也一点不变。
台上,小滚筒的钉子约是大滚筒的十分之一,转一圈的时间也是十分之一。它先转 4 圈,铅笔小车在纸带上写下 4 个猜测;大滚筒再转一圈,同时点亮 5 条路:核对这 4 个,再算第 5 个位置。台上的两个模型很小,都从同一本书里数出来(中文页用鲁迅《呐喊》里的五篇):大的看前两个字,小的只看前一个字。推测解码只用到两个模型给下一个词元的概率,所以规则和计数都是真的,只是模型小、句子不通。
小模型猜 γ = 4 个 · 大模型读一次权重,同时算 5 个位置
留下对的,换掉错的
大模型从第一个猜测看起:通过的留下,打字头用墨描一遍;遇到第一个不通过的就停下,换上一个大模型自己定的词元,后面的猜测全部作废,因为它们接在一个错字后面。四个都通过时,这一遍还多送一个:第 5 个位置大模型已经算好了。
所以大模型每读一次权重,至少写下 1 个词元,最多 γ + 1 个。纸带上每个字下面有个小记号:圆点是留下的猜测,菱形是大模型自己写的(换上的或多送的)。
每读一次权重:1 到 γ + 1 个词元 · 圆点 = 留下的猜测 · 菱形 = 大模型写的
通过的规则
怎样算通过?设大模型给这个词元的概率是 p,小模型给的是 q。q ≤ p 时直接留下;q > p 时小模型高估了它,只以 p/q 的概率留下:抽一个 0 到 1 之间的随机数 r,r ≤ p/q 才留下。桥上每个表就是这一次比较:铜色的柱高 p/q,满格是 1,红线是 r。
不通过时,换上的词元不从大模型原来的分布里抽,而从 p 比 q 多出来的部分里抽:max(0, p − q),再归一。小模型猜少了的词元在这里补上,猜多了的不会再来。
留下的概率 min(1, p/q) · 换上的词元来自 max(0, p − q)
和大模型写的一样
合起来,任何一个词元 x 被写下的概率,是小模型提出它并被留下的 min(p, q),加上被拒之后补上它的 p − min(p, q),正好是 p。Leviathan 等人在附录里证明了:不论小模型是什么,写出的文字和大模型一个一个写的分布完全相同。Chen 等人的说法是,在硬件数值的精度以内保持目标模型的分布。
台子左端的试管在做这个实验:开头都是“慢慢”,左管让大模型自己写下一个字,右管用推测解码写,每轮各写 50 次。小模型低估了“地”(0.13 对 0.32),高估了“慢”(0.33 对 0.09);右管里铜珠是留下的猜测,红珠是补上的。每一轮的高度都有随机的起伏,多轮平均下来,两管都落到黑线上,也就是大模型的 p(上方的读数是累计的)。快了,但没有变差,也没有变好:变的只是时间。
min(p, q) + (p − min(p, q)) = p · 大模型的分布,一点不变
接受率 α
一个猜测被留下的概率是 Σ min(p, q):两个模型的分布重合得越多,越常通过。在写出的文字上平均,就是接受率 α。台上这对模型的 α 是 0.642。Leviathan 等人测到,比大模型小两个数量级左右的小模型,α 多在 0.5 到 0.9 之间;一个只看前一个词元的二元模型配 T5-XXL,在英德翻译上 α 约 0.2。
猜 γ 个,大模型每读一次权重平均写下 (1 − α^(γ+1)) / (1 − α) 个词元。α = 0.642、γ = 4 时是 2.49 个;台上数出来是 2.46 个。公式假定每个位置一样好猜,真实的文字有易有难:“孔乙”后面几乎总是“己”,一句话的开头就难猜得多。
α = E[Σ min(p, q)] · 每读一次权重 (1 − α^(γ+1)) / (1 − α) 个词元
快多少
小模型也要时间。设它跑一次是大模型的 c 倍,一步就要 γc + 1,速度提高 (1 − α^(γ+1)) / ((1 − α)(γc + 1)) 倍。猜得太少浪费机会,猜得太多后面的多半作废。台上 c = 0.1、α = 0.642,γ = 3 最好,快 1.78 倍。
论文里的数字:T5-XXL(110 亿参数)配 T5-small(7700 万),一块 TPU v4、一次一段,英德翻译快 3.4 倍(贪心)和 2.6 倍(采样),c 不到 0.05。DeepMind 用一个 40 亿参数的小模型给 700 亿参数的 Chinchilla 猜(每个词元 1.8 毫秒对 14.1 毫秒),γ = 4,快了 1.92 到 2.46 倍;其中两项每秒写出的词元,超过了一个一个写时按带宽算出的上限(模型大小除以总带宽)。
T5-XXL + T5-small · 2.6–3.4 倍 · Chinchilla 70B + 4B · 1.92–2.46 倍
用的是闲着的算术
推测解码不省算术,反而多算:作废的猜测白算了,小模型也要算。Leviathan 等人算过,α = 0.6、γ = 2 时,即使不算小模型的时间和算术,大模型的算术也多 53%,速度快 96%。省下的是读:大模型的权重和 KV 缓存每一步只读一次,而一步平均写下好几个词元。所以它只在算术闲着时划算,作者写明,没有多余算力的配置,它帮不上忙。
批处理用的是同一份闲着的算术,批越大,留给猜测的越少。EAGLE 的作者在 LLaMA2-Chat 70B 上测到,一次一段快 3.01 倍,一批 4 段只快 2.40 倍;SmartSpec 的作者发现,请求多到一定程度,多猜反而更慢。可上下文很长时,读缓存又成了瓶颈,MagicDec 在一批 32 到 256 段时仍测到最多 2.51 倍。这份算术用来让一段话写得快,还是让很多段话写得便宜,是速度和每个词元成本之间的取舍:Pope 等人写道,批越小延迟越低,每个词元的成本越高。
批处理:用闲着的算术换便宜 · 推测解码:用它换快
不要第二个模型
小模型要另外找到或训练、另外部署。后来的方法回到 Stern 等人 2018 年的做法,让大模型自己猜。Medusa(2024)在大模型最后一层的输出(送进输出层之前的那组特征)上加几个小“头”:大模型自己的输出层猜下一个词元,第 k 个头猜再往后第 k 个;几种猜法排成一棵树,一次核对。EAGLE(2024)用的是同一组特征,但让一个很小的草稿网络一格一格地往前推特征(每一步还看一眼上一步抽到的词元),再用原模型的输出层变成猜测,交给原模型核对,LLaMA2-Chat 70B 上快 2.7 到 3.5 倍。前瞻解码(2024)不要草稿网络,用雅可比迭代一次生成几段 n 元组,从存下的 n 元组里挑候选。
它们是否和原模型一样,看核对的规则。EAGLE 在猜测树的每个分叉上用同一条规则,分布不变。前瞻解码的作者也证明了它的采样核对不改变分布;它的代价在算术:按作者在 A100 上选的设定,7B、13B、34B 模型每一步约多做 120、80、56 倍的运算,所以只在算术大量闲着时划算。冻结原模型(Medusa-1)再用上面的规则核对,分布不变,也照样提速,但作者说这条规则不能让它更快,于是另给了“典型接受”;典型接受和一起微调原模型的 Medusa-2 都不再保证和原模型同分布,Medusa-2 快 2.3 到 2.8 倍。
Medusa · 多个头 · EAGLE · 在特征上往前推 · 前瞻解码 · 雅可比迭代
剖开读头
剖开大滚筒下面的读头:每根钢齿压着一根推杆,九条路的轴从所有推杆旁穿过。一颗钉子经过,推杆一动,点亮的几条路都记下一次:读一次,用几次。点亮几条,就是一次算几个词元,一批里的几段话,或者核对的几个猜测。
右边小磨坊的齿轮转多快,算术就有多忙。只亮一条路时它几乎不动;九条全亮,按 H100 的比例也才用到约 3%,要约 295 条,算术才跟得上读。
一颗钉子读一次,几条路一起用 · 九条路 ≈ H100 算术的 3%
拆开来看
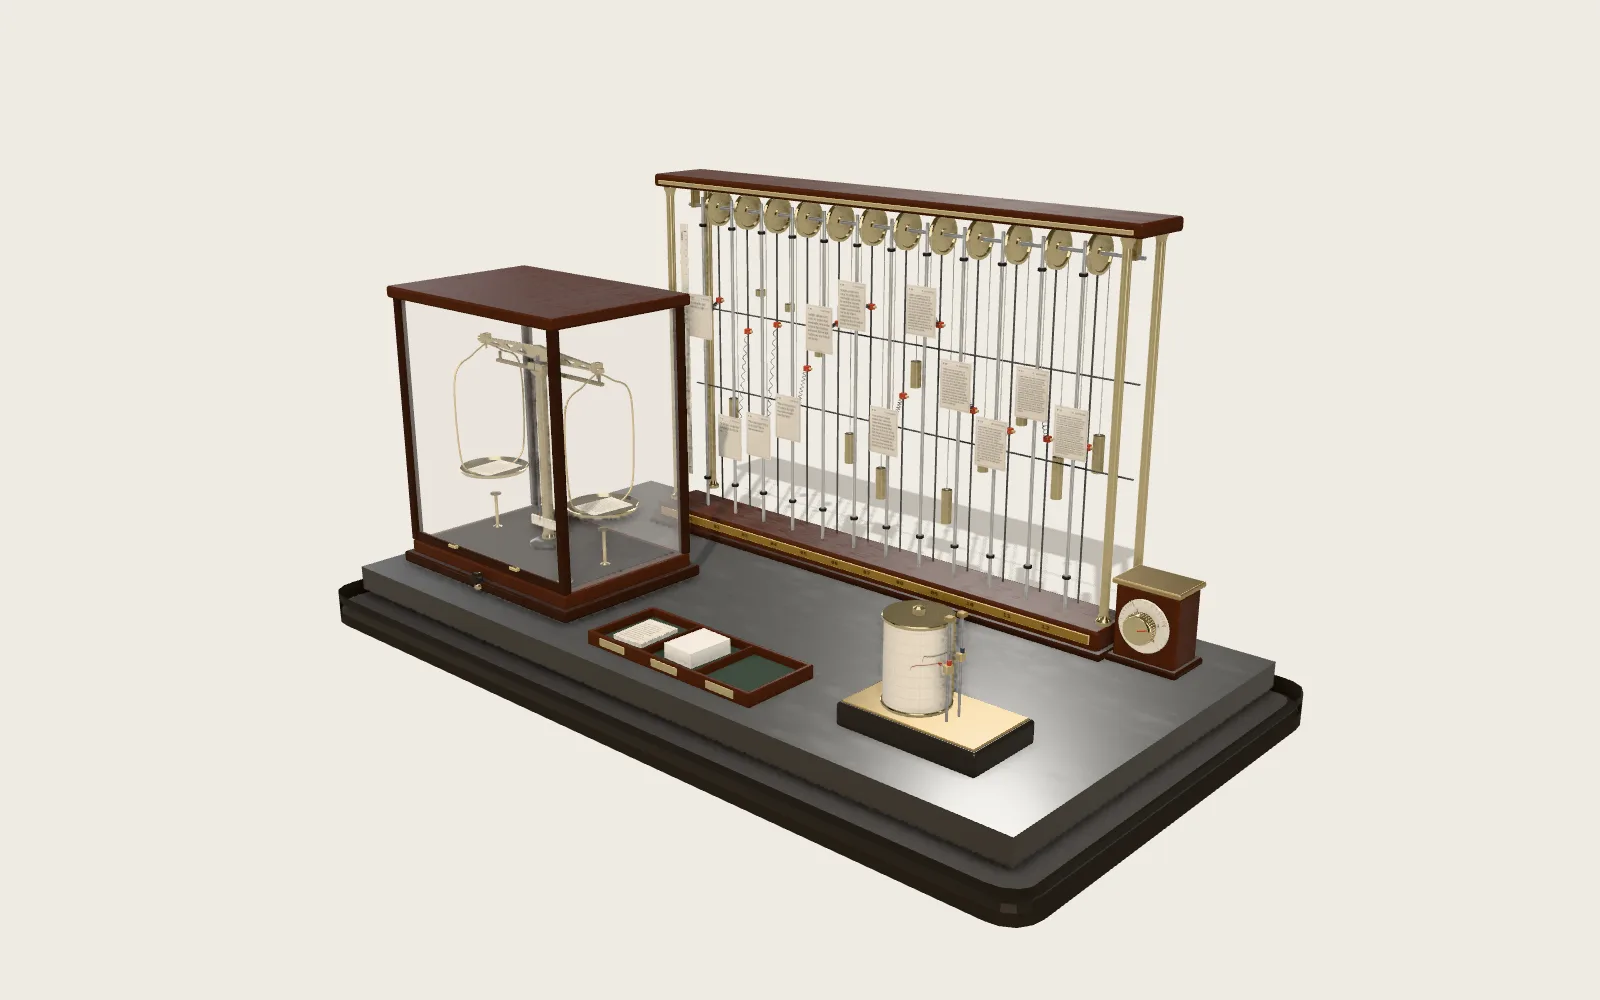
一张铸铁台:左后是大滚筒(大模型)和它的读头,右前是小滚筒(小模型)和铅笔小车;前面的纸带上,打字头写下大模型认的词元,桥上的表核对每个猜测;中间的小磨坊是算术单元,右后的柜子是每段话的缓存,左端的试管收集结果。每一件都可以单独托出来看。
实验台
可以换小模型(看前一个字的、什么都不看的、和大模型一样的),改猜测的个数 γ,改成贪心(每次都取最可能的词元),也可以把批调大,看纸面上的速度怎么变。试管可以清空重来。
试一试把小模型换成“什么都不看”的那个,α 掉到多少?再把 γ 拉到 8:大滚筒每转一圈多写几个,总的快了还是慢了?
模型省略了什么
台上不是神经网络。大小两个模型是从同一本书里数出来的统计:大的看前两个词元,小的看前一个,用 Witten–Bell 平滑;中文页一个字是一个词元,英文页一个词或一个标点是一个词元,真实模型的词元是词的片段(见图版「词元与缩放定律」)。推测解码只用到两个模型对下一个词元的概率,所以规则、α 和台上的计数和真实系统一样,只是模型小。滚筒、钉子、九条路和小磨坊是比喻:真实的权重是显存里的数,读和算在芯片上同时进行。c = 0.1 是台上的设定。H100 的数字按纸面算,只算读权重(批的那一章另算缓存),不算其他开销,真实系统达不到。
一个常见的误解
常有人以为推测解码是用小模型代替大模型,写出的东西会差一点。按 Leviathan 和 Chen 的规则,写出的文字和大模型自己写的分布完全相同:小模型只决定快不快,不改变会写出什么、各有多大可能,它猜得再差,也只是慢。真实硬件上计算的顺序不同,数值有微小差别,即使贪心解码,具体的文字也可能不同,所以 Chen 等人说的是在硬件数值的精度以内保持分布。会改变分布的是放宽了规则的变体,例如 Medusa 的典型接受。
常见问题 · 4
- 为什么大模型生成文字慢?
每写一个,模型的全部权重都要从显存搬到计算单元过一遍。
01一次一个词元 ↑- 推测解码是什么?
一个小得多的模型先往下猜几个词元,大模型再一次把它们全部核对。
03先让小模型猜 ↑- 推测解码会降低输出的质量吗?
Leviathan 等人在附录里证明了:不论小模型是什么,写出的文字和大模型一个一个写的分布完全相同。
06和大模型写的一样 ↑- 推测解码能快多少?
DeepMind 用一个 40 亿参数的小模型给 700 亿参数的 Chinchilla 猜(每个词元 1.8 毫秒对 14.1 毫秒),γ = 4,快了 1.92 到 2.46 倍
08快多少 ↑
资料来源
- Leviathan、Kalman、Matias(2023):Fast Inference from Transformers via Speculative Decoding,ICML 2023,arXiv:2211.17192(规则与附录 A.1 的证明、α、式 1、定理 3.8 与 3.11、表 1 至表 3)
- Chen、Borgeaud、Irving、Lespiau、Sifre、Jumper(2023):Accelerating Large Language Model Decoding with Speculative Sampling,DeepMind,arXiv:2302.01318(Chinchilla 70B 与 4B 小模型、1.8 与 14.1 毫秒、1.92 至 2.46 倍、“硬件数值的精度以内”)
- Pope 等(2022):Efficiently Scaling Transformer Inference,Google,arXiv:2211.05102(每一步读一次权重、每个词元 2N 次运算、读权重与读缓存哪个为主)
- NVIDIA:H100 Tensor Core GPU(H100 SXM:显存带宽 3.35 TB/s;BF16 1,979 TFLOPS 为稀疏值,不稀疏约一半)
- Meta:Llama 3.1 8B(8,030,261,248 个参数);Llama Team(2024):The Llama 3 Herd of Models,arXiv:2407.21783,表 3(32 层、模型宽 4,096、32 个注意力头,所以头宽 128;8 个键值头)
- Williams、Waterman、Patterson(2009):Roofline: An Insightful Visual Performance Model for Multicore Architectures,Communications of the ACM 52(4)(屋顶线模型、运算强度)
- Stern、Shazeer、Uszkoreit(2018):Blockwise Parallel Decoding for Deep Autoregressive Models,NeurIPS 2018,arXiv:1811.03115(只用于贪心的前身)
- Cai 等(2024):Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads,arXiv:2401.10774(多个头、树注意力、典型接受、Medusa-1 与 Medusa-2;Medusa-2 的 2.3 至 2.8 倍见论文摘要与表 1,arXiv 网页摘要写的是 2.3 至 3.6 倍)
- Li、Wei、Zhang、Zhang(2024):EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty,arXiv:2401.15077(倒数第二层特征、LLaMA2-Chat 70B 2.7 至 3.5 倍、表 7 批与速度)
- Fu、Bailis、Stoica、Zhang(2024):Break the Sequential Dependency of LLM Inference Using Lookahead Decoding,arXiv:2402.02057(雅可比迭代、n 元组、采样核对、额外的算术)
- Liu 等(2024):Optimizing Speculative Decoding for Serving Large Language Models Using Goodput(SmartSpec),arXiv:2406.14066 v1(请求多时多猜反而更慢)
- Sadhukhan 等(2024):MagicDec: Breaking the Latency-Throughput Tradeoff for Long Context Generation with Speculative Decoding,arXiv:2408.11049 v5(长上下文、一批 32 至 256 段、最多 2.51 倍)
- Lewis Carroll(1865):Alice’s Adventures in Wonderland,Project Gutenberg 第 11 号(英文页的书,公有领域)
- 鲁迅:《呐喊》,维基文库(《故乡》《社戏》《孔乙己》《一件小事》《风波》,中文页的书,公有领域)
数据
The two models on the bench are counted by the page from one book each: Lewis Carroll, Alice’s Adventures in Wonderland (1865; Project Gutenberg ebook 11, public domain) for English, and five stories from 鲁迅《呐喊》 (1919–1922; Wikisource, public domain) for Chinese (src/topics/specdec/corpus.py, sim.js). Nothing on the bench is the output of a real language model. Material presets, parts and the softbox studio of the site’s model kit are ported from AirsupHQ/machine-skill (MIT, © 2026 Air Supply Technologies Inc.).
本页的文字、图片和模型采用 CC BY-NC 4.0 许可:可以免费用于教学和其他非商业用途,可以修改,请注明出自 world.lapla.si。上面列出的第三方素材仍按各自的许可。
引用这幅图版
拉普拉斯的迷你世界,图版 F33《推测解码》,https://world.lapla.si/zh/specdec/,CC BY-NC 4.0,2026-10-22 更新。
沿这个问题继续
 图版 F13Transformer 的注意力一个两层、八个头的小 Transformer,在你的浏览器里逐字读一句话,猜下一个字母。每条丝线是一次“注意”,亮度就是它的权重。
 图版 F26词元与缩放定律大语言模型读的是词元,不是字。模型越大、读的词元越多,误差按一条幂律下降。台上是在浏览器里运行的字节对编码,和一组真实训练过的小模型。
 图版 F25混合专家一个模型可以有几千亿个参数,每个词却只动用其中一小部分:路由器给每个词挑出几个“专家”,其余的不动。这里是一个真实训练过的小模型,16 个专家,每个字母只走 2 个。
 图版 F29人类反馈强化学习聊天模型在预训练之后,还要用人的偏好再调一遍:人比较两个回答,奖励模型学会打分,模型再对着分数练。台上是这三步的一个小模型,全部在浏览器里计算。