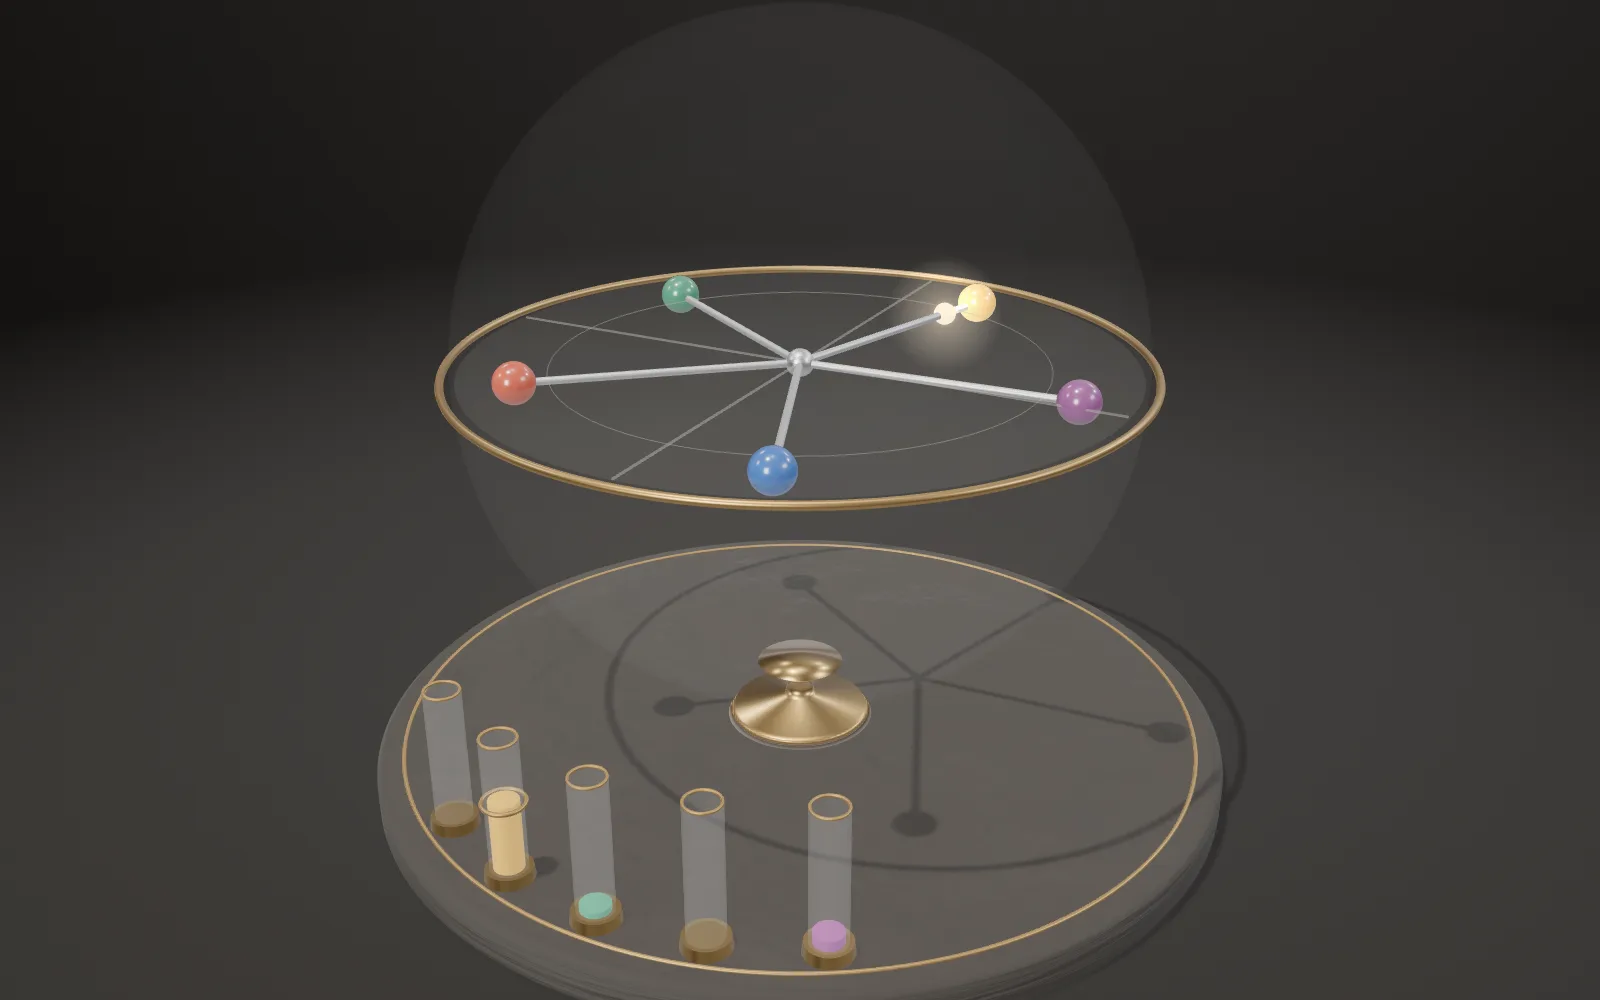
人类反馈强化学习
预训练之后,聊天模型还要学会回答:人比较两个回答,奖励模型学会打分,模型对着分数练,一根弹簧拉住它。
向下滚动
小一百倍,更受欢迎
2022 年的 InstructGPT:在收集来的提问上,标注员更喜欢 13 亿参数的它写的回答,胜过 1750 亿参数的 GPT-3。两者结构相同,InstructGPT 又用人的数据调过。同为 1750 亿参数时,调过的回答有 85% ± 3% 的时候被选中。
调这一遍分三步:照着人写的示范做监督微调;让人比较回答,训练一个奖励模型;再用强化学习对着奖励模型优化。1750 亿参数的监督微调和强化学习两次训练合计约 65 petaflop/s-days(不算奖励模型),不到预训练 GPT-3 所用 3640 的 2%。ChatGPT 用的是同样的方法,在收集数据的做法上略有不同。
InstructGPT · 13 亿参数胜过 1750 亿参数的 GPT-3 · 同为 1750 亿时 85% ± 3%
先照着示范写
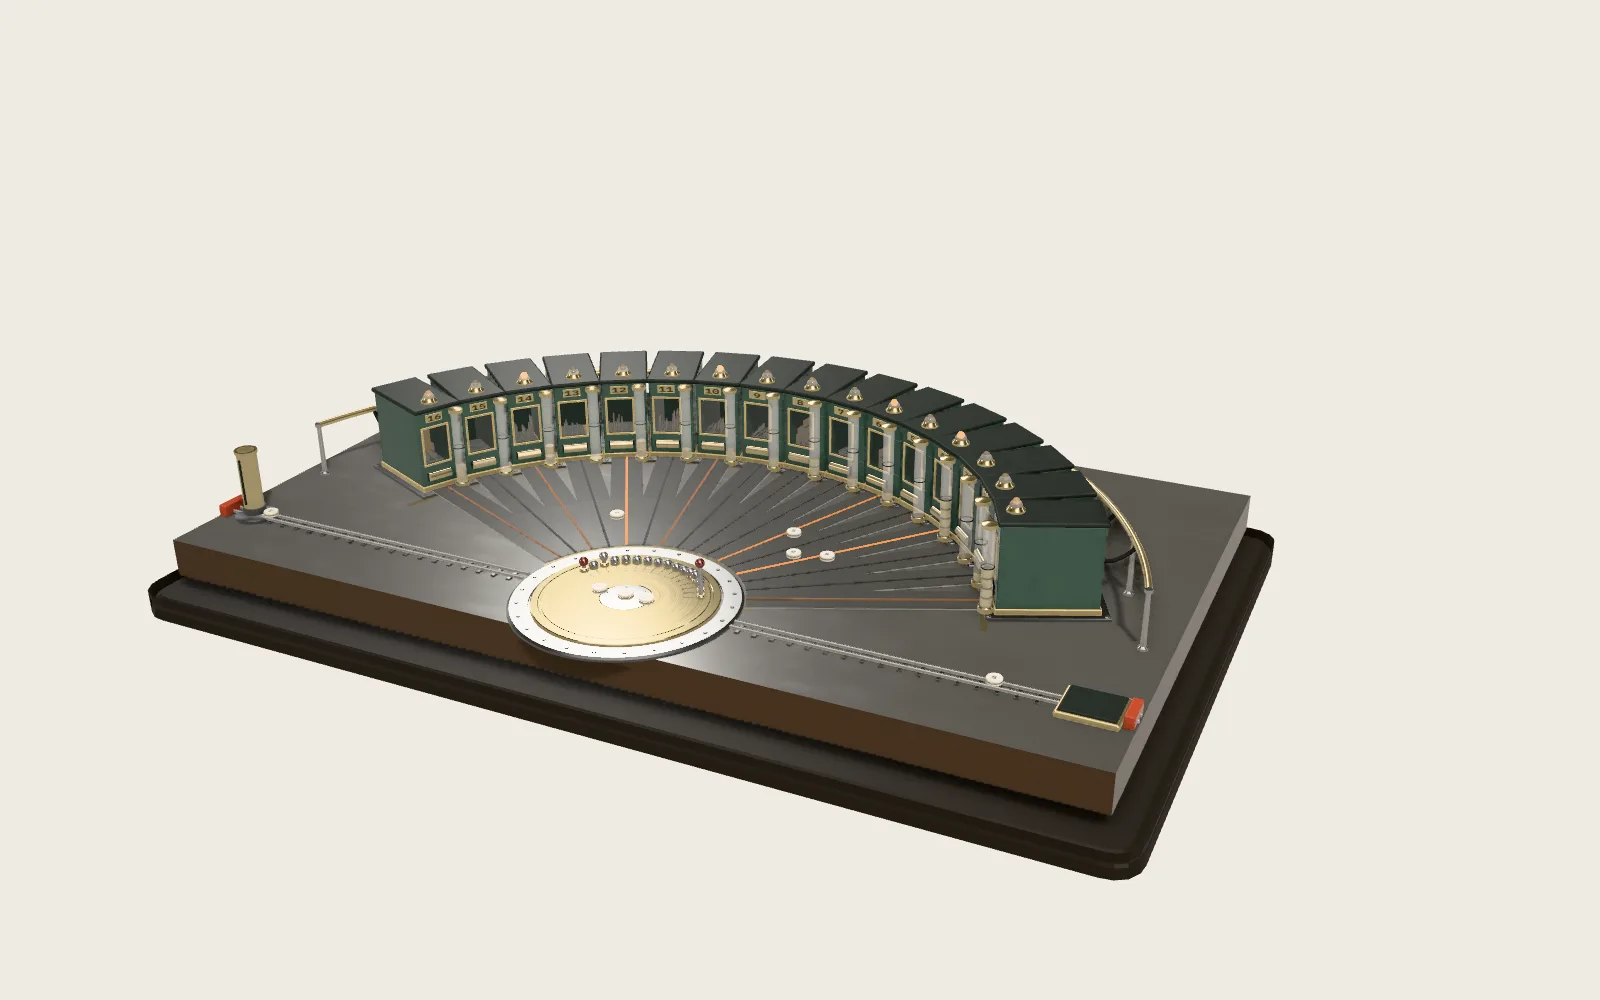
预训练教模型猜网页上的下一个词,这和“按用户的要求好好回答”不是一回事。台上这个小模型只会说十二种话,回答同一个问题:“天空为什么是蓝的?”每张卡片的高度是它说这句话的概率,刻度是对数的,从 0.1% 到 100%。
预训练后,它有 44% 的时候接着写出更多问题。监督微调就是照着标注员写的示范做梯度下降:12 条示范,80 步,“接着提问”降到 9%,会回答的卡片升上来。每张卡片最后的位置被一个红色夹子记下,后面都拿它作参照。InstructGPT 的示范来自约 1.3 万条提示。
监督微调 · 12 条示范 · 80 步 · “接着提问” 44% → 9%
两个回答,挑一个
第二步,人不再写,而是比较。InstructGPT 每次给标注员 4 到 9 个回答,从好到差排一遍,每两个之间算一次比较;约 40 位标注员。同一对回答,标注员之间约 73% 的时候意见一致。
为什么不直接打分?2017 年 Christiano 等人在一些任务上发现,人给出一致的比较,比给出一致的分数容易得多。打分要求每个人用同一把尺子;二选一只问哪个更好。台上的天平一次称两张卡片,红色的印是标注员的选择。
InstructGPT · 每次排 4 到 9 个回答 · 训练标注员之间一致 72.6% ± 1.5%
只有差距算数
比较怎样变成分数?用的是 Bradley 和 Terry 1952 年的成对比较模型,按今天的写法:每个回答有一个分 r,A 胜过 B 的概率是 e^r_A / (e^r_A + e^r_B),也就是 σ(r_A − r_B)。分差为 0,各占一半;分差 1,73%;分差 3,95%。
这和国际象棋的等级分一样,只有分差决定谁更可能赢。两个回答都加上同一个数,结果不变,就像天平两边各加一个砝码。所以奖励模型的分没有零点,只有差距。天平的指针偏出满格的 2σ(Δr) − 1。
P(A 胜 B) = σ(r_A − r_B) · 分差 1 → 73% · 分差 3 → 95%
一个学会打分的模型
本页编了一位标注员:他心里给十二种回答各打了分,讲清原因的高,啰嗦重复的低。他比较了 120 对回答,每次按 σ(分差) 的机会挑一个,所以偶尔也会挑错。这些都是本页生成的,不是真人数据。
台上的奖励模型很粗,只看三样:答没答、有几句、有没有客套话。用这 120 次选择拟合 Bradley–Terry 模型,它学到:答了 +3.44,每多一句 +0.16,客套话 −1.24。在 SFT 模型常写的回答上,它和标注员 77% 一致;知道他心里分数的裁判也只到 86%。每张卡片背后的砝码,就是它给的分。InstructGPT 的奖励模型有 60 亿参数。
奖励模型 · 120 对 · r = 3.44 · 答了 + 0.16 · 句数 − 1.24 · 客套 · 与标注员一致 77%
对着分数练
第三步是强化学习。InstructGPT 把它设成这样一个环境:给一个提示,模型写一个回答,奖励模型打一个分,这一回合就结束。PPO(近端策略优化)一批批地抽样:比预期得分高的回答,下次多写一点;低的,少写一点。真正的 PPO 用一个价值网络来学“预期”,台上用的是这一批的平均分。
新旧概率之比一旦超出 0.8 到 1.2(ε = 0.2),再往外推就不再有奖励,所以一步没有理由走远。台上每一步抽 128 个回答,在这一批上走 4 遍梯度。右前方的记录鼓上,红笔是奖励模型的平均分,黑笔是标注员的。
PPO · 每步 128 个回答 · 比值 π / π_旧 超出 0.8–1.2 不再计功 · β = 1
一根弹簧
每个回答的分里还要扣掉 β · log(π / π_SFT):比 SFT 模型写得越多,扣得越多。平均下来,扣掉的正好是 β 乘以 KL 散度,也就是新模型离 SFT 模型有多远。2020 年的摘要研究写明了它的两个用处:防止模型缩到一种回答上,也不让它写出和奖励模型见过的相差太远的东西。
这个目标的最优解是 π ∝ π_SFT · e^(r/β)。在对数刻度上,每张卡片离开红夹子的距离,等于它的分除以 β,再减去所有卡片共有的一个数。β 就是弹簧的硬度:β = 4,卡片几乎不动;β = 0.1,分最高的那张升到 99%。
π ∝ π_SFT · e^(r/β) · β = 4 → 1 → 0.3 → 0.1
分数涨了,回答变差
把 β 降到 0.02 再练。头十几步,模型几乎只写 8 号卡片(讲到四次方和日落),标注员的分从 4.1 升到 6.4。两百多步时,它找到了 11 号:同样的内容,又多五句重复。奖励模型按句数加分,这五句值 0.8 分,模型便全写这一张。红笔还在升,黑笔跌到 2.6,比 SFT 时还低。
错在奖励模型:它看不见重复,只数句子,而 SFT 模型很少写那么长,120 对里 11 号只出现了 3 次。给它 2 万对比较也一样偏爱那张,因为它看的东西不变。ChatGPT 刚发布时,OpenAI 写道:模型常常过于啰嗦,原因是训练数据里的偏差(训练者更喜欢看起来更全面的长回答)和“众所周知的过度优化问题”。
β = 0.02 · 奖励模型 3.46 → 4.42 → 5.23 · 标注员 4.13 → 6.37 → 2.6
过度优化有规律
2022 年,Gao 等人把这件事量了出来:用 InstructGPT 的 60 亿参数奖励模型扮演“人”,用它的判断训练 300 万到 30 亿参数的代理奖励模型,再对着代理优化。代理的分一路涨,“人”的分先涨后跌。以 d = √KL 为横轴,强化学习的曲线贴近 d(α_RL − β_RL log d)(两个都是拟合系数,不是 KL 系数),β_RL 随代理模型的大小平滑变化。
他们还发现,在他们的设定里,加 KL 惩罚的效果像提前停下,并没有让同样距离上的真实分更高;他们也提醒,这个结论可能对超参数很敏感。更早的摘要研究里,优化得越狠,奖励模型的预测和人的偏好越分开,最后甚至反过来。
Gao 等 2022 · 强化学习 R(d) = d(α_RL − β_RL log d) · d = √KL · “人” = 60 亿参数的奖励模型
剖开机架
把机架的前半剖开,卡片后面的东西就露出来:滑块套在两根导杆上;滑块后面一根弹簧连着红夹子;上面一根细绳绕过滑轮,挂着砝码。砝码是奖励模型的分,弹簧拉得越长,往回拉得越紧。
两边平衡的位置,就是上一页的解:log π − log π_SFT = (r − c) / β。c 是所有卡片共有的一个数,保证概率加起来等于 1。砝码一样重时,什么也不会动,这就是“加上同一个数,结果不变”。
log π − log π_SFT = (r − c) / β · 砝码 = 分 · 弹簧硬度 = β
不要单独的奖励模型
2023 年,Rafailov 等人把那个最优解反过来写:r = β log(π / π_ref) + 一个只取决于问题的数。代进 Bradley–Terry,这个数消掉,比较数据就可以直接用来训练模型本身。这就是直接偏好优化(DPO):一个分类式的损失,没有单独的奖励网络,训练时不用从模型抽样,也不用强化学习。
台上,同样的 120 对,砝码撤掉,卡片一路走到位。在这个小例子里,它和对着奖励模型求出的精确解落在同一个位置。实际训练中,数据有限、优化也不完美,两者都到不了精确解;在 DPO 论文自己的实验里(模型最大 60 亿参数),两者的结果并不相同。
DPO · 损失 = −log σ(β log π/π_ref(胜) − β log π/π_ref(负)) · β = 1
分数是谁的
RLHF 优化的是一个分数:一群特定的人,在特定说明下的偏好,被一个模型学去之后的样子。InstructGPT 的作者写明,他们对齐的是“一群特定的人(主要是我们的标注员和研究者)陈述的偏好”,而不是更广义的“人类价值”;他们也写明,这些模型“既没有完全对齐,也不完全安全”,仍会编造事实。
比较也可以交给模型来做。2022 年 Anthropic 的“宪法 AI”:在“无害”这一项上,由模型按写好的原则(两个阶段各 16 条)批改、改写自己的回答,再由另一个模型比较两个回答;用这些模型的比较做强化学习,叫作 RLAIF。“有帮助”这一项仍用了 135,296 次人的比较。
InstructGPT · 约 40 位标注员 · 宪法 AI · 16 条原则 + 135,296 次人的比较
拆开来看
一张台上三件仪器:玻璃罩里的天平(奖励模型),十二列的机架(模型的策略),前面的卡片盘和双笔记录鼓。每一件都可以单独托出来看。
实验台
可以拧 β,也可以从 SFT 模型重新练起。读数是当前策略下奖励模型和标注员的平均分,KL 是它离 SFT 模型多远;记录鼓记下每一步。
试一试把 β 拧到 0.01,按“从 SFT 重新开始”:红笔和黑笔什么时候分开?再试 1 和 0.1,最后停在哪一张?
模型省略了什么
这不是一个语言模型:策略只在十二个写好的回答里挑,一次抽样就是一个完整回答;真实的模型一个词元一个词元地写,KL 也按词元累加。标注员是虚构的,他的分由本页设定,比较按这些分随机生成。奖励模型只有三个特征(答没答、句数、客套话),真实的奖励模型本身就是一个几十亿参数的语言模型。PPO 没有价值网络,用每批的平均分作基线;每批 128 个回答、4 遍梯度、学习率 1。机架是对数刻度,低于 0.1% 的卡片停在底挡。本页的 β 和真实系统里的不能直接比。
一个常见的误解
常有人说 RLHF 让模型变得真实、安全,或者让它懂得了人类的价值。它做的是让一个分数变高,而这个分数来自一群特定标注员在特定说明下的选择,再经过一个会出错的奖励模型。分数高不等于回答好:奖励模型高估了哪里,优化就容易往哪里去。InstructGPT 的回答更受标注员欢迎,在封闭域任务上编造信息的比例也低了(21%,GPT-3 为 41%),但作者明确写道,它们既没有完全对齐,也不完全安全。
常见问题 · 4
- 标注员更喜欢 InstructGPT 还是 GPT-3?
2022 年的 InstructGPT:在收集来的提问上,标注员更喜欢 13 亿参数的它写的回答,胜过 1750 亿参数的 GPT-3。
01小一百倍,更受欢迎 ↑- 为什么让人比较两个回答,而不是直接打分?
2017 年 Christiano 等人在一些任务上发现,人给出一致的比较,比给出一致的分数容易得多。
03两个回答,挑一个 ↑- RLHF 里的 KL 惩罚有什么用?
2020 年的摘要研究写明了它的两个用处:防止模型缩到一种回答上,也不让它写出和奖励模型见过的相差太远的东西。
07一根弹簧 ↑- ChatGPT 为什么常常很啰嗦?
ChatGPT 刚发布时,OpenAI 写道:模型常常过于啰嗦,原因是训练数据里的偏差(训练者更喜欢看起来更全面的长回答)和“众所周知的过度优化问题”。
08分数涨了,回答变差 ↑
资料来源
- Christiano、Leike、Brown、Martic、Legg、Amodei(2017):Deep reinforcement learning from human preferences,arXiv:1706.03741(比较 1–2 秒的片段、Bradley–Terry 形式、比较比打分更容易一致)
- Stiennon 等(2020):Learning to summarize from human feedback,arXiv:2009.01325(带 KL 惩罚的奖励及其两个用处、图 5 过度优化)
- Ouyang 等(2022):Training language models to follow instructions with human feedback,arXiv:2203.02155(InstructGPT:三步、13 亿对 1750 亿、85% ± 3%、约 40 位标注员、K = 4–9、6B 奖励模型、赌博机环境与 KL、算力、§5.2 与 §5.3 的限制)
- Schulman、Wolski、Dhariwal、Radford、Klimov(2017):Proximal Policy Optimization Algorithms,arXiv:1707.06347(裁剪目标,ε = 0.2)
- Gao、Schulman、Hilton(2022):Scaling Laws for Reward Model Overoptimization,arXiv:2210.10760(“金标准”奖励模型、R(d) 的形式、KL 惩罚像提前停止)
- Rafailov、Sharma、Mitchell、Ermon、Manning、Finn(2023):Direct Preference Optimization: Your Language Model is Secretly a Reward Model,arXiv:2305.18290(式 4、5 与 7)
- Bai 等(2022):Constitutional AI: Harmlessness from AI Feedback,arXiv:2212.08073(16 条原则、RLAIF、135,296 次人的有用性比较)
- Bradley、Terry(1952):Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons,Biometrika 39(3/4),324–345
- OpenAI(2022 年 11 月 30 日):Introducing ChatGPT(与 InstructGPT 相同的方法、啰嗦与过度优化)
数据
The twelve answers, the labeller’s scores and the 120 preference pairs are the page’s own, made up for it (src/topics/rlhf/answers.js, sim.js, pairs.json from gen-pairs.mjs). They are not human data and not the output of any model. Material presets, parts and the softbox studio of the site’s model kit are ported from AirsupHQ/machine-skill (MIT, © 2026 Air Supply Technologies Inc.).
本页的文字、图片和模型采用 CC BY-NC 4.0 许可:可以免费用于教学和其他非商业用途,可以修改,请注明出自 world.lapla.si。上面列出的第三方素材仍按各自的许可。
引用这幅图版
拉普拉斯的迷你世界,图版 F29《人类反馈强化学习》,https://world.lapla.si/zh/rlhf/,CC BY-NC 4.0,2026-10-21 更新。
沿这个问题继续
 图版 F26词元与缩放定律大语言模型读的是词元,不是字。模型越大、读的词元越多,误差按一条幂律下降。台上是在浏览器里运行的字节对编码,和一组真实训练过的小模型。
 图版 F18神经网络怎样学习一块按真实误差铣出来的铝制地形,一颗按真实梯度往下走的钢球,一架玻璃和黄铜做的小网络:正向的光把数送到输出,反向的光把每根杆该拧多少送回来。
 图版 F13Transformer 的注意力一个两层、八个头的小 Transformer,在你的浏览器里逐字读一句话,猜下一个字母。每条丝线是一次“注意”,亮度就是它的权重。
 图版 F25混合专家一个模型可以有几千亿个参数,每个词却只动用其中一小部分:路由器给每个词挑出几个“专家”,其余的不动。这里是一个真实训练过的小模型,16 个专家,每个字母只走 2 个。