混合专家
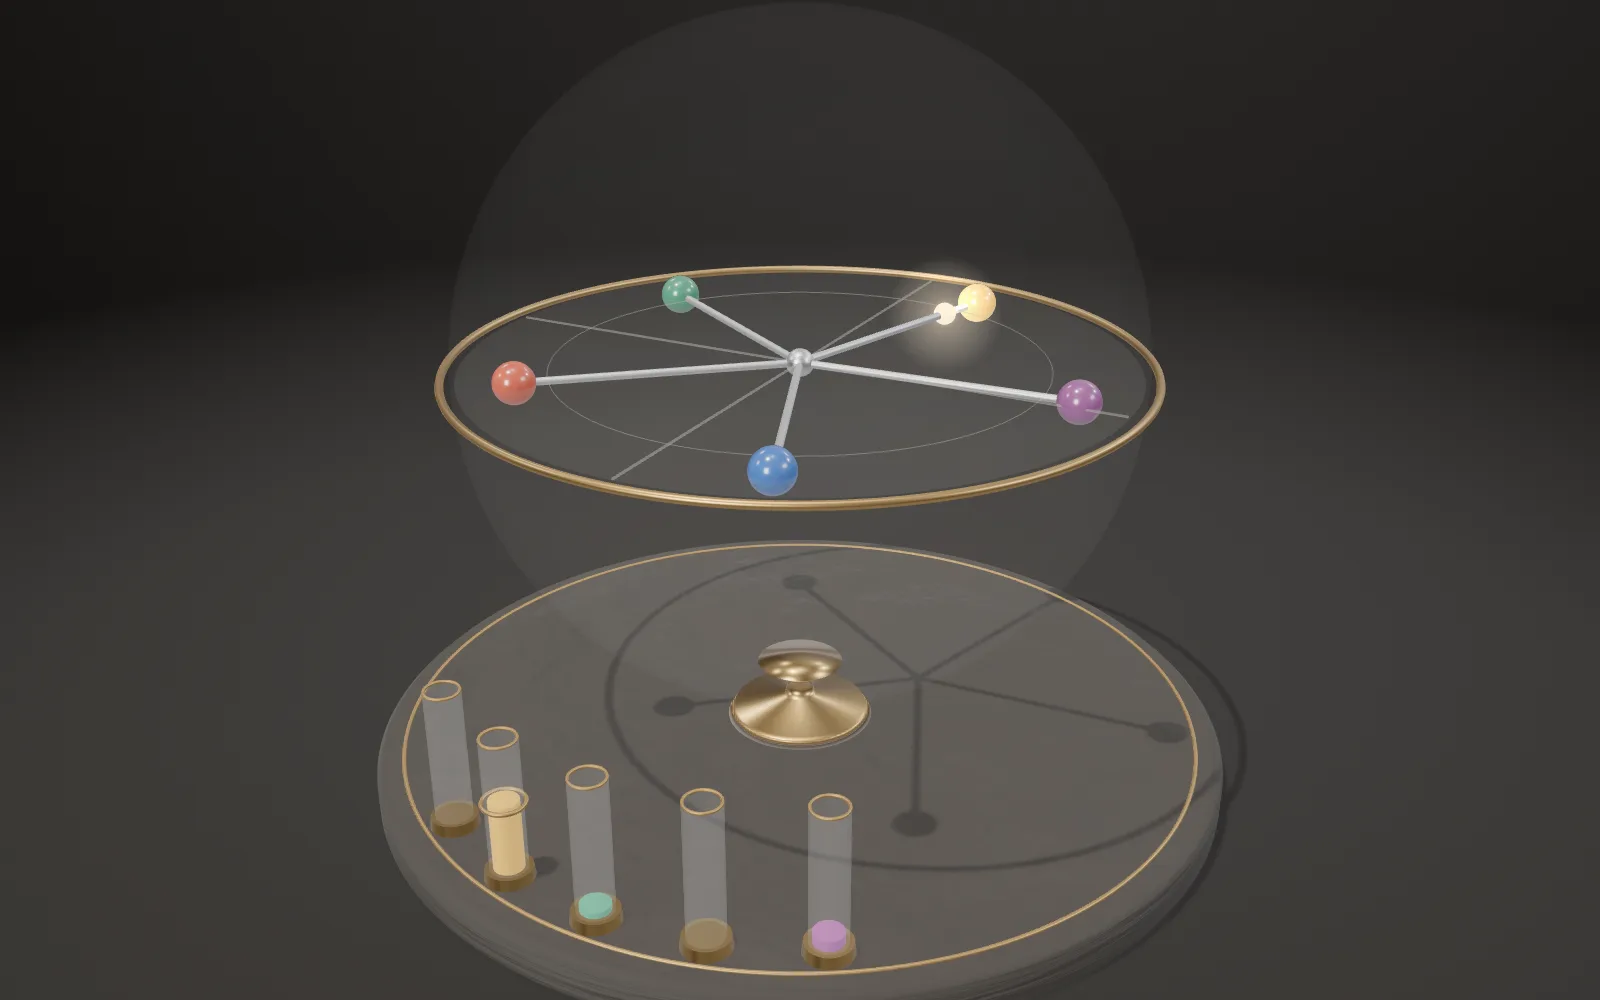
大模型可以有几千亿个参数,处理每个词时却只用到其中一小部分。做法是把一层拆成许多“专家”,由一个路由器给每个词挑出其中几个。这张台上是一个真实训练过的小模型:16 个专家,每个字母只走 2 个,每一次挑选都在本页实时计算。
向下滚动
参数多,计算少
2024 年底发布的 DeepSeek-V3 有 6710 亿个参数,处理每个词元时只用到其中 370 亿个,约 5.5%。Mixtral 8x7B 共有 467 亿个参数,每个词元用到 129 亿个。
台上的模型小得多:16 个专家,共 53,030 个参数,每个字母只用到 8,902 个,约 17%。没被选中的专家停着,灯是暗的。
本页模型:16 个专家 · 每个字母选 2 个 · 用到 8,902 / 53,030 个参数
路由器只开两条线
每个字母先停在中间的转盘上。路由器是一张 48 × 16 的表:字母的 48 个数和它相乘,得到 16 个分数,经过 softmax 变成 16 个概率。转盘边上 16 根针的高度,就是这些概率。
只留下最高的两个分数,对它们再做一次 softmax,得到两个加起来等于 1 的权重。字母被送去这两个专家,回来时两份结果按权重相加。这是 Mixtral 的做法;2017 年提出的稀疏门控还在分数上加一点可学的噪声,2021 年的 Switch Transformer 只选一个。
分数 = 字母 × 路由表 → 留下最高的 k 个 → 权重 = 这 k 个分数的 softmax
其余的都不动
没被选中的专家,这一步什么也不算。所以每个字母的计算量只取决于选几个、一个专家有多大,与专家一共有多少无关。
Mixtral 每层有 8 个专家,每个词元选 2 个。467 亿个参数里,每个词元用到 129 亿个:注意力层和词表人人共用,专家只用到四分之一。
Mixtral 8x7B:8 选 2 · 共 467 亿 · 每个词元 129 亿
专家越多,猜得越准
同样的训练,每个字母都只算两个专家。把专家从 4 个加到 8 个、16 个、32 个,每个字母的计算几乎不变,参数从 1.5 万涨到 10 万。在训练时没见过的 10 万个字母上,猜下一个字母的平均代价(交叉熵,越低越好)从 2.47 比特降到 2.20 比特。
对照是一块普通的前馈网络,宽度是一个专家的两倍,计算量和两个专家相同:2.60 比特,猜中 45.7%;16 个专家猜中 50.6%。2021 年的 Switch-Base 有 70 亿个参数,每段文字的计算量和 2 亿参数的 T5-Base 相同;论文报告,64 个专家的版本用七分之一的时间达到同样的效果。
交叉熵:普通网络 2.60 · 4 个专家 2.47 · 8 个 2.36 · 16 个 2.27 · 32 个 2.20 比特
专家里面是什么
剖开任何一个专家,里面是一块普通的前馈网络:48 个数变成 32 个,负数变成 0,再变回 48 个。柜子里的 32 片钢片就是这 32 个中间值;被点亮的钢片升起多高,就是这个字母此刻的值。
Transformer 的每一层本来就有这样一块前馈网络(见“注意力”一页)。混合专家把它换成许多块并排,只让其中几块工作;注意力照旧共用。2020 年的 GShard 每隔一层换一次。
一个专家:48 → 32(ReLU)→ 48 · 3,152 个参数
越用越偏
路由器和专家一起训练。2017 年提出稀疏门控的论文写道,门控网络往往收敛到总给同样几个专家大权重;这种不平衡会自我强化,因为被偏爱的专家训练得更快,于是更常被选中。
本页训练了一个不加任何平衡措施的版本。在 10 万个字母上,1 号专家接了 18.3% 的活,9 号一次也没被选中,它的 3,152 个参数白白占着位置。柜门旁的玻璃管,记的是每 32 个字母里各个专家接到多少。
不加平衡:最忙的专家 18.3% · 有一个 0% · 变异系数 0.61
一项小小的惩罚
常用的办法是在训练目标里加一项。Switch Transformer 写作 α · N · Σ fᵢ · Pᵢ:fᵢ 是实际派给第 i 个专家的比例,Pᵢ 是路由器给它的平均概率。派得越平均,这一项越小。论文取 α = 0.01。
台上的 16 专家模型加的就是这一项。最忙的专家接 10.4%,最闲的 3.7%,变异系数 0.30。猜字的效果几乎不变:两个版本都是 2.27 比特。
α · N · Σ fᵢPᵢ,α = 0.01 · 最忙 10.4% · 最闲 3.7% · 变异系数 0.30
满了就退回
在许多芯片上并行时,每个专家一批能收多少要事先定好,叫容量:这一批的词元数除以专家数,乘以每个词元选几个,再乘一个容量系数。超出容量的词元在这一层得不到处理,只沿着残差连接原样往下走,叫被丢弃。
这里每 32 个字母算一批,系数 1.0 时每个专家能收 4 个,红环就是这条线。系数 1.0 时,五分之一的派送被退回;1.25 时约十分之一;2.0 时只剩 0.4%,可每个专家要多留一倍的空位。Switch Transformer 的实验里,被丢弃的通常不到 1%;DeepSeek-V3 靠平衡做到训练和推理都不丢弃。
32 个字母一批 · 系数 1.0:容量 4,退回 19.8% · 1.25:10.2% · 2.0:0.4%
专家到底管什么
名字叫“专家”,容易让人想成一个管数学、一个管历史。实际平淡得多。Mixtral 的论文比较了 arXiv 论文、生物学摘要和哲学文章,各个专家被选中的比例几乎一样,看不出按话题分工;看得到的是语法上的规律,比如 Python 里的 self、代码的缩进,常常交给同一个专家。
台上的小模型也是这样,分工落在字母的形状上。10 号和 14 号专家接到的字母,八成以上紧跟在空格后面,也就是一个词的开头;2 号接的多在元音之后,其中一半是 a;13 号最常接 t 后面的那个字母。
10 号:88.6% 在空格之后 · 2 号:82.4% 在元音之后 · 按 10 万个字母统计
省下的只是计算
所有专家都得待在内存里,随时等着被选。Mixtral 的论文说,它的内存开销和 470 亿个参数成正比:按每个参数 2 字节算约 93 GB,而每个词元的计算只相当于一个 129 亿参数的模型。
专家一多,就要分到许多芯片上,词元得在芯片之间来回发送。GShard 用 2048 个 TPU 核训练每层 2048 个专家的模型;DeepSeek-V3 规定每个词元最多发往 4 台机器,以压低通信。训练也更容易不稳:Switch Transformer 把路由器的计算改用 32 位浮点,并把初始权重缩小到十分之一。
内存按全部参数 · 计算按用到的参数 · 跨芯片通信 · 路由不稳
拆开来看
转盘就是路由器。一台专家柜由柜体、顶盖、工作灯、进料滚筒和负载管组成;每个部件都可以单独托出来看。
实验台
这里可以改每个字母选几个专家、专家一共几个、怎样平衡、容量系数多大,也可以换一句话。读数里的交叉熵,是这句话在当前设置下实时算出的。
试一试把容量系数拉到 1.0,再把平衡方式换成“不平衡”,退回的比例变了多少?每个字母选 1 个和选 4 个专家,哪个猜得更准?
模型省略了什么
这是真实训练过的模型,但只有一层:从前 4 个字母猜下一个,没有注意力。每个字母查表得到 12 个数,4 个拼成 48 个;专家是 48 → 32 → 48 的 ReLU 网络(Mixtral 和 DeepSeek-V3 用的是 SwiGLU);路由不加噪声,权重是留下的分数做 softmax(Mixtral 的写法)。偏置平衡的版本仍用 softmax 分数,DeepSeek-V3 用的是 sigmoid 亲和度。容量按 32 个字母一批计算。权重存成 8 位整数。真正的模型有几十层,每层的专家比这里的整个模型大几万倍;一台转盘派送到十几台柜子,只是把这种派送摆在桌面上的样子。
一个常见的误解
“专家”不是按学科分工的。路由器学到的是对降低误差有用的划分,在本页是字母的形状,在大模型里多半是语法和位置上的规律;Mixtral 的论文没有找到按话题分工的迹象。另外,多用几个专家不一定更好:台上的模型按选 2 个训练,推理时改成选 4 个,交叉熵从 2.27 比特变差到 2.34;16 个全用是 2.42。只选 1 个是 2.57。
常见问题 · 3
- 混合专家模型每个词用到多少参数?
2024 年底发布的 DeepSeek-V3 有 6710 亿个参数,处理每个词元时只用到其中 370 亿个,约 5.5%。
01参数多,计算少 ↑- 混合专家的“专家”是按学科分工的吗?
Mixtral 的论文比较了 arXiv 论文、生物学摘要和哲学文章,各个专家被选中的比例几乎一样,看不出按话题分工;
09专家到底管什么 ↑- 混合专家模型省内存吗?
所有专家都得待在内存里,随时等着被选。
11省下的只是计算 ↑
资料来源
- Shazeer 等(2017):Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer,arXiv:1701.06538(带噪声的 top-k 门控、不平衡的自我强化、重要性损失、最多 131,072 个专家、1370 亿参数)
- Lepikhin 等(2020):GShard,arXiv:2006.16668(top-2、每隔一层、专家容量与溢出、6000 亿参数、2048 个 TPU v3 核 4 天)
- Fedus、Zoph、Shazeer(2021):Switch Transformers,arXiv:2101.03961(top-1、容量系数、α · N · Σ fᵢPᵢ、Switch-Base 与 T5-Base、选择性精度)
- Jiang 等(2024):Mixtral of Experts,arXiv:2401.04088(8 选 2、470 亿 / 130 亿、内存、路由分析)
- Mistral AI(2023):Mixtral of experts(46.7B 总参数,每个词元 12.9B)
- DeepSeek-AI(2024):DeepSeek-V3 Technical Report,arXiv:2412.19437(6710 亿 / 370 亿、1 个共享 + 256 个路由专家选 8、无辅助损失的偏置平衡、最多 4 个节点、不丢弃)
- DeepSeek-AI:DeepSeek-V3 代码与权重说明(671B 主模型 + 14B 多词元预测模块)
- Project Gutenberg:训练用的六本公版小说
数据
The models are the site’s own: one sparse layer (16 experts, top-2, and variants) trained with numpy by src/topics/moe/train.py on six public-domain novels from Project Gutenberg (Alice’s Adventures in Wonderland, Pride and Prejudice, The Adventures of Sherlock Holmes, Frankenstein, A Tale of Two Cities, Moby Dick). Routing as in Mixtral (softmax over the kept scores); the balancing loss as in the Switch Transformer; the bias balancing as described for DeepSeek-V3. Material presets, parts and the softbox studio of the site’s model kit are ported from AirsupHQ/machine-skill (MIT, © 2026 Air Supply Technologies Inc.).
本页的文字、图片和模型采用 CC BY-NC 4.0 许可:可以免费用于教学和其他非商业用途,可以修改,请注明出自 world.lapla.si。上面列出的第三方素材仍按各自的许可。
沿这个问题继续
 图版 F13Transformer 的注意力一个两层、八个头的小 Transformer,在你的浏览器里逐字读一句话,猜下一个字母。每条丝线是一次“注意”,亮度就是它的权重。
 图版 F18神经网络怎样学习一块按真实误差铣出来的铝制地形,一颗按真实梯度往下走的钢球,一架玻璃和黄铜做的小网络:正向的光把数送到输出,反向的光把每根杆该拧多少送回来。
 图版 F22嵌入:意思的几何一只黑漆描金的球,上面嵌着小图和黄铜铭牌。每个都是一个小模型给出的方向:图和它的说明,指向几乎同一处。