大模型量化
一个大语言模型,就是几十亿个数。把每个数存得粗一点,模型就小几倍、快几倍。
向下滚动
能做到什么
2025 年 8 月 OpenAI 发布的开放权重模型 gpt-oss-120b 有 1,168 亿个参数。其中九成以上是专家层的权重,用 MXFP4 格式存,每个只占 4.25 位;整个模型 60.8 GiB,放得进一块 80 GB 的 GPU。同样的参数都用 16 位存,要 234 GB。
Llama 3.1 405B 用 16 位存时,一台装 8 块 H100 的机器放不下,要两台、16 块 GPU;Meta 同时给出了 FP8 推理的做法。Gemma 3 27B 的量化感知训练版本把权重从 54 GB 压到 14.1 GB,一块 24 GB 的 RTX 3090 就装得下。BitNet b1.58 2B4T 从头训练时每个权重只取 −1、0、+1,除词嵌入外的权重只占 0.4 GB。
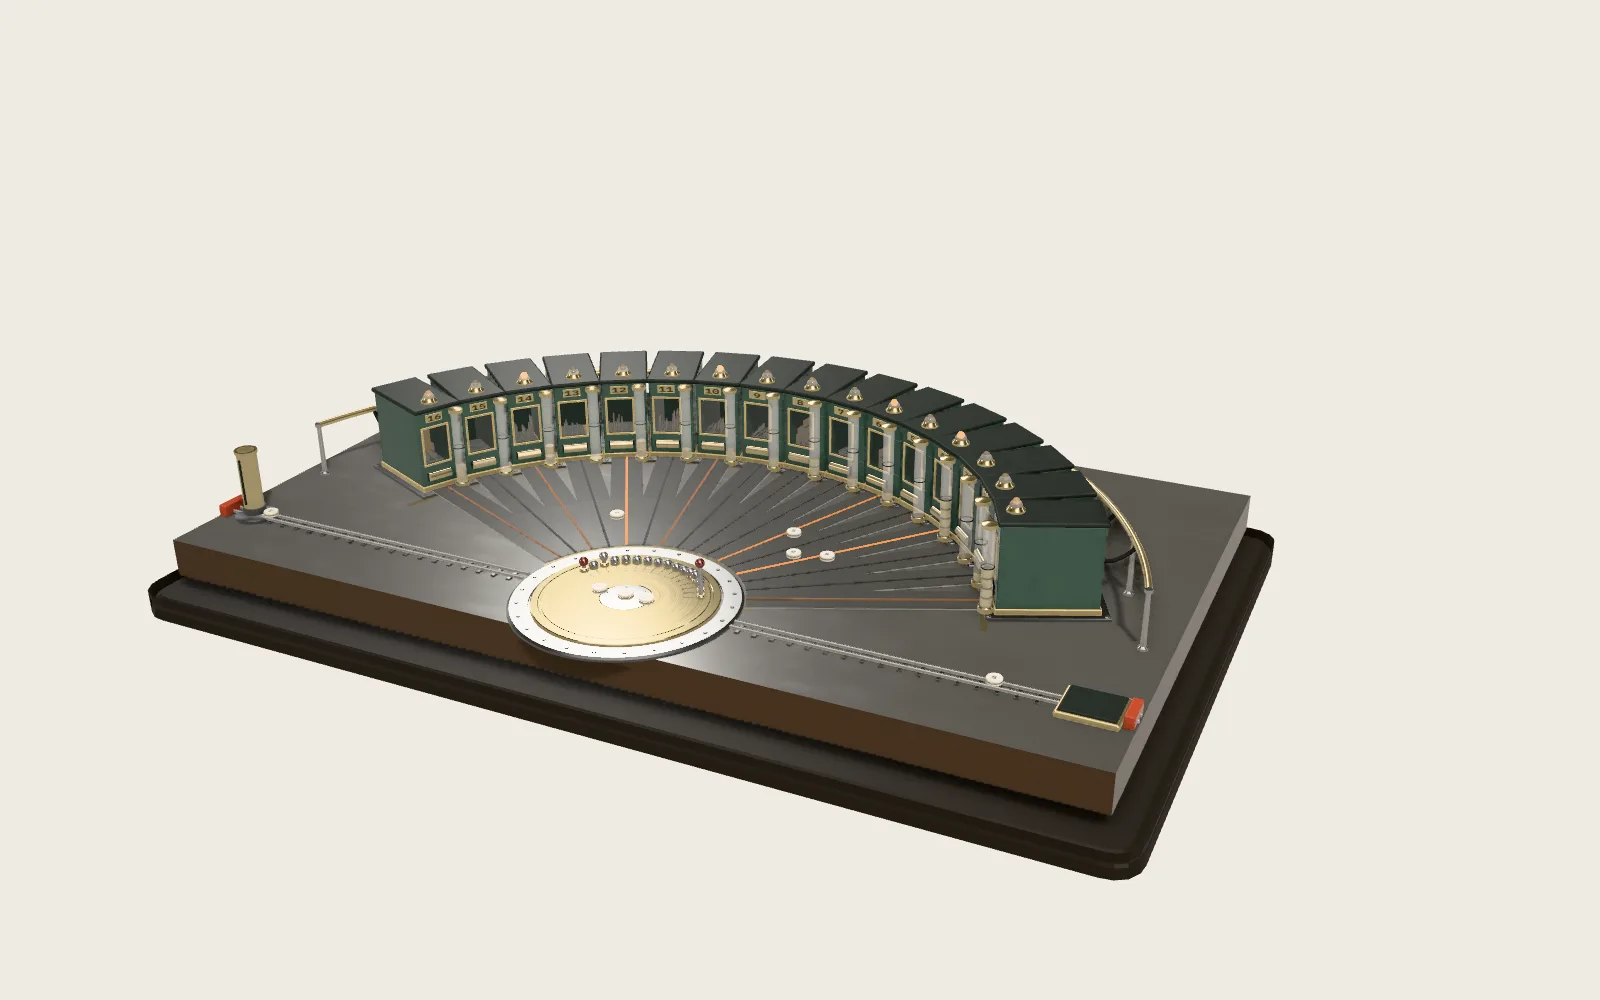
台上是一块真实的权重:Qwen2.5-7B 第 14 层注意力输出矩阵(3,584 × 3,584)中的 24 × 48 个数,按发布的 BF16 原样读出。每根钢柱是一个权重,高度是它的大小,亮的是正数,暗的是负数。
gpt-oss-120b:MXFP4,4.25 位,60.8 GiB · Llama 3.1 405B:16 位要 16 块 GPU · Gemma 3 27B:54 → 14.1 GB · BitNet b1.58:−1 / 0 / +1
权重占满显存
一个模型有多大,基本就是参数的个数乘每个参数占的字节。Qwen2.5-7B 有 7,615,616,512 个参数,每个用 16 位、也就是 2 个字节存,共 15.2 GB。Llama 3.1 70B 是 141 GB,405B 是 812 GB;一块 H100 有 80 GB 显存。
右边的量表就是这笔账:一块钢板代表每个权重的 1 位,16 块叠起来是 16 位。百分表读出这摞钢板的高度;内圈换算成每 10 亿个权重占多少 GB,16 位正好 2 GB。
生成文字时,模型每写一个词元,都要把全部权重从显存读一遍。所以每个权重少一半的位数,不只是省一半的地方,每一步要搬的数据也少一半。
内存 = 参数 × 每个参数的字节 · Qwen2.5-7B:15.2 GB(16 位)· 一块 H100:80 GB
一个数用几位
训练神经网络常用 32 位浮点数:1 位符号、8 位指数、23 位尾数。BF16 保留 8 位指数、只留 7 位尾数,范围和 32 位一样,只是粗一些;FP16 是 5 位指数、10 位尾数,最大只到 65,504。Qwen2.5-7B 和 Llama 3.1 都以 BF16 发布。
再往下,FP8 有两种:E4M3(4 位指数、3 位尾数,最大 448)和 E5M2(最大 57,344),推荐权重和激活用前者、梯度用后者。DeepSeek-V3 训练时,计算量大的运算大多用 FP8,而且一律是 E4M3。整数格式 INT8、INT4 没有指数,只是一把等距的尺子,要另配一个缩放系数。
4 位的浮点数 FP4(E2M1)只能表示 0、0.5、1、1.5、2、3、4、6 和它们的负数。MXFP4 让 32 个这样的数共用一个 8 位、2 的幂次的缩放系数,平均每个 4.25 位;NVIDIA 的 NVFP4 让 16 个数共用一个 FP8 的系数,比 FP16 小约 3.5 倍。
FP32 1-8-23 · BF16 1-8-7 · FP16 1-5-10 · FP8 E4M3 / E5M2 · FP4 E2M1:0、0.5、1、1.5、2、3、4、6
落到格子上
把一个数存成 4 位整数,就是把它放到一把只有 15 格的尺子上:−7 到 +7。一格多宽由缩放系数决定。最常见的做法是让绝对值最大的数正好落在 ±7 上;其余的数除以一格的宽度,四舍五入,存下整数,用的时候再乘回去。
台上先把这 1,152 个权重放在同一把尺子上。红色的那根是其中最大的一个,0.118,它定下了格子:一格是 0.118 ÷ 7 ≈ 0.017。后面玻璃上刻的是钢柱现在能落到的 8 个高度,从 0 格到 7 格;正负另由颜色记着。
代价是误差:每个数最多偏差半格。这块权重里一半的数小于 0.015,比一格还小,于是 31 % 的权重被取成了 0,整块的相对误差约 21 %。少数几个大数把尺子撑宽,小数就没了分辨率。
q = round(w ÷ s),s = 最大绝对值 ÷ 7 · 4 位整数:−7 … +7 · 台上:31 % 的权重变成 0
每组一把尺子
办法是多配几把尺子。每一行(一个输出通道)一把,叫逐通道;一行里每 g 个数一把,叫分组。AWQ 的论文用每组 128 个,GPTQ 的论文试过 128 和 1,024;llama.cpp 的 Q4_0 是每 32 个一组,配一个 16 位的缩放系数。
台上的钢条把每一行切成 3 组、每组 16 个;黄铜片和本组最大的钢柱一样高,那就是这一组的尺子。同样是 4 位,一把尺子管整块时相对误差约 21 %,每行一把降到 11 %,每 16 个一把降到 8 %。
尺子也占地方。每 16 个数配一个 16 位的系数,平均每个权重多出 1 位;每 128 个一组只多 0.125 位。一项 3.5 万多次实验的研究发现,在总位数不变时,能稳定改善结果的办法几乎只有两个:把参数切成小块分别量化,以及换数字格式。
整块 / 每行 / 每 16 个一把尺子:21 % → 11 % → 8 %(台上,4 位)· 尺子的开销:16 ÷ g 位
几个特别大的数
权重大多平缓,难的是送进这一层的输入,也就是激活。2022 年的 LLM.int8() 发现,输入里有些维度的数比别处大到 20 倍;模型到 67 亿参数前后,每一层都有了,集中在约 6 个固定的维度上,只占全部特征的 0.1 % 左右。把这几维置零,困惑度变差 600 % 到 1000 %。
LLM.int8() 把这几维单独拿出来用 16 位算,其余 99.9 % 用 8 位,1,750 亿参数的模型也不掉精度,显存省一半。SmoothQuant 换了个办法:大数总出现在固定的通道里,就把每个通道的输入除以 s、对应那一列权重乘以 s,乘积不变;s = 输入最大值^α ÷ 权重最大值^(1 − α),α 常取 0.5。这样权重和输入都能用 8 位,最多快 1.56 倍、显存省一半。
台上前沿的黄铜柱是这一层的 48 路输入,其中两路特别大;这组输入是本页编的,权重是真的。平滑之后,这两路矮了下去,对应的两列钢柱高了起来:难处从输入挪到了权重上。用 8 位时,普通的输入原来只用到 255 格里的 41 格,平滑后用到 109 格。
LLM.int8():约 0.1 % 的维度用 16 位 · SmoothQuant:x ÷ s,w × s,α = 0.5 · 台上的输入是本页编的
边取整,边改正
最简单的做法是每个数各自四舍五入,叫 RTN。GPTQ 一列一列地取整:每取整一列,就把这一列造成的误差,按输入之间的相关程度,摊到还没取整的列上,让这一层的输出尽量不变。它用的是输入的二阶统计(一个海森矩阵的逆),校准只要 128 段、每段 2,048 个词元的文本。
它在一块 GPU 上约 4 个小时,就把 1,750 亿参数的模型压到 3 或 4 位。OPT-175B 的困惑度(越低越好)原来是 8.34;4 位时 RTN 是 10.54,GPTQ 是 8.37;3 位时 RTN 崩到几千,GPTQ 是 8.68。
台上的桥架从左往右扫,每过一列,那一列就落到格子上,右边还没取整的钢柱跟着微调(这里的输入是本页编的)。4 位、每 16 个一组时,权重本身的误差从 8 % 升到 14 %,这一层输出的误差却从 8 % 降到 5 %。AWQ 走另一条路:它发现按输入的大小挑出的约 1 % 的权重通道最要紧,于是按每个通道输入的平均大小把权重放大、输入缩小,再量化。
GPTQ · OPT-175B:16 位 8.34,4 位 RTN 10.54,GPTQ 8.37 · 台上:输出误差 8 % → 5 %
只剩 −1、0、+1
前面的做法都是训练完再量化。另一条路是在训练时就让模型适应更少的位数,叫量化感知训练。Gemma 3 的 QAT 版本多训了约 5,000 步,压到 4 位时,困惑度的损失少了 54 %。
走得最远的是 BitNet b1.58:从头训练时,每个权重只能是 −1、0 或 +1。先除以整块权重绝对值的平均数 γ,再四舍五入,截在 −1 到 1 之间。三种取值合 log₂3 ≈ 1.58 位。论文里 30 亿参数的这种模型困惑度 9.91,同样数据训练的 16 位模型是 10.04;显存少 3.55 倍,每个词元快 2.71 倍。
台上的钢柱也这样取整:γ = 0.0177,所有钢柱只剩一种高度,约三分之一落到底,量表剩下 1.58 块钢板。但这是把训练好的权重直接硬压,误差约 56 %;BitNet 是带着这个约束训练出来的。实际存储时,四个三值数装进一个字节,每个占 2 位。
W̃ = RoundClip(W ÷ γ, −1, 1) · log₂3 ≈ 1.58 位 · BitNet b1.58 3B:显存 ÷ 3.55,每个词元快 2.71 倍
KV 缓存也能压
生成文字时,模型还要记住前面每个词元在每一层的键和值,叫 KV 缓存。每个词元每层存两份,每份是 KV 头数 × 每头的大小个数。Qwen2.5-7B 有 28 层、4 个 KV 头、每头 128 个数,16 位时每个词元 56 KiB;131,072 个词元就是 7.5 GB,相当于权重的一半。
上下文越长,KV 缓存越成为大头。KIVI 发现键要按通道量化、值要按词元量化,压到 2 位几乎不掉质量:峰值显存少 2.6 倍,批量能大 4 倍,吞吐量高 2.35 到 3.47 倍。KVQuant 用 3 位,困惑度损失不到 0.1,让 LLaMA-7B 在一块 80 GB 的 A100 上处理 100 万个词元。
KV 头少本身也是为了省缓存:Llama 3 的 8B 模型 32 个注意力头只配 8 个 KV 头,131,072 个词元的缓存是 17 GB;若每个头都有自己的键和值,要 69 GB。
每个词元:2 × 层数 × KV 头 × 头大小 × 字节 · Qwen2.5-7B,131,072 个词元:7.5 GB(16 位)→ 0.94 GB(2 位)
丢了什么
困惑度衡量模型读到真实文本时有多“意外”,越低越好。在 LLaMA3-8B 上(WikiText2,16 位是 6.1),每组 128 个的 4 位量化:RTN 8.5,GPTQ 6.5,AWQ 6.6。3 位:RTN 27.9,GPTQ 和 AWQ 都是 8.2。2 位时都崩溃了:GPTQ 210,AWQ 约 170 万。
一项横跨 1,900 万到 1,760 亿参数、3.5 万多次实验的研究发现:模型的总位数相同时,4 位几乎总是最好的;到 3 位,这个规律就反过来了。另一项在 17 亿参数以内的模型上的研究发现,预训练的数据越多,事后量化的损失越大。
平均分接近,不等于行为相同。一项研究发现,准确率只差 2 % 以内时,仍可能有 5 % 以上的答案从对变错或从错变对;Meta 也写道,标准基准没有充分反映 FP8 的影响,他们改为比较 10 万条回答的奖励模型打分。
LLaMA3-8B(16 位 6.1)· 4 位:RTN 8.5 / GPTQ 6.5 / AWQ 6.6 · 3 位:RTN 27.9 · 2 位:崩溃
换来什么
先换来内存。Gemma 3 27B 从 54 GB 到 14.1 GB;gpt-oss-120b 从 16 位的 234 GB 到 65 GB;Llama 3.1 405B 的 FP8 版本约 487 GB,小于一台 8 块 H100 的 640 GB 显存。
再换来速度。一次只生成一个词元时,芯片的算力用不满,瓶颈是把权重从显存搬上来:RTX 4090 每秒能搬 1 TB,而这一步每搬一个字节只做大约一次运算。所以每秒词元数大致有个上限:带宽 ÷ 权重的字节数。Qwen2.5-7B 在每秒 614 GB 的 M5 Max 上,16 位最多约 40 个词元每秒,4 位约 143 个。
实测比上限低,但方向一致:GPTQ 让 3 位的 OPT-175B 在一块 A100 上每个词元 71 毫秒,16 位的要 5 块 A100、230 毫秒;AWQ 的推理框架在桌面和移动 GPU 上平均快 3.2 到 3.3 倍。
每秒词元 ≤ 带宽 ÷ 权重字节 · Qwen2.5-7B,614 GB/s:约 40(16 位)→ 约 143(4 位)
在哪儿跑
在自己的电脑上跑模型,最常见的是 llama.cpp 和它的 GGUF 文件:一个文件装下权重和全部元数据,能直接映射进内存。它的量化格式有一长串:Q8_0 每 32 个数一组配一个 16 位系数,合 8.5 位;Q4_K_M 在不同的张量上混用几种块,Llama 3.1 8B 平均 4.89 位、4.58 GiB,16 位是 14.96 GiB。
苹果的 MLX 默认每 64 个一组、4 位,也支持 MXFP4 和 NVFP4。BitNet 有自己的 CPU 推理库,在 ARM 上比 16 位快 1.37 到 5.07 倍。量化让 130 亿参数的模型能在 8 GB 显存的笔记本 GPU 上跑,让 Llama-2-70B 跑在 64 GB 内存的 Jetson Orin 上。
本页的速度都是各家自己的测量,硬件和设置各不相同,不能横着比;能比的是同一张表里的比值:在同一台机器上,Q4_K_M 比 16 位小 3.3 倍,生成快 2.5 倍。
GGUF · Q8_0:8.5 位 · Q4_K_M:4.89 位(Llama 3.1 8B)· MLX:每 64 个一组 · MXFP4 / NVFP4
拆开来看
台子分成八件:钢柱盘(权重,带分组钢条、黄铜尺片和前沿的输入柱)、刻线玻璃(格子)、桥架和它的两条导轨(逐列取整)、钢板量表、百分表和表架、位数旋钮,以及花岗岩平台前面的铭牌。
钢柱粗 5.7 毫米、间距 6.8 毫米;高 1 毫米代表权重 0.00116。1,152 根柱子是同一个矩阵里相邻的 24 行、48 列,左边刻着行,前沿刻着列的编号(416 到 463)。
量表一块钢板 3.6 毫米,16 块是 16 位;百分表一圈 300°,从 0 到 16 位。
钢柱盘 · 刻线玻璃 · 桥架 · 导轨 · 钢板量表 · 百分表 · 位数旋钮 · 铭牌
实验台
实验台上量化的是整块 32 × 512 = 16,384 个真实权重,钢柱盘显示其中 24 × 48 个;右上角是全部权重的分布,红线是第一组的格子。
位数可以从 16 调到 2,或 1.58(三值);每组可以是 16、32、64、128 个,一整行(512 个),或整块一把尺子。读数是相对误差、被取成 0 的比例、算上缩放系数后每个权重的位数,以及按这个位数存时 Qwen2.5-7B 有多大。
缩放系数按 16 位算;格子是对称的,按每组的最大绝对值定;三值按每组的平均绝对值定。这些都是最简单的取整,不是 GPTQ 或 AWQ。
整块 16,384 个权重 · 读数:误差、0 的比例、每个权重的位数、模型大小
试一试把位数调到 3,再把每组从 16 个放宽到整块:误差变了多少?被取成 0 的权重多了多少?
模型省略了什么
钢柱盘只是一个矩阵里的 1,152 个数(实验台是 16,384 个),而 Qwen2.5-7B 有 76 亿个;钢柱的高度是权重的绝对值,正负用颜色区分。“整块一把尺子”指的是台上这一块,真实的逐张量量化管的是整个 3,584 × 3,584 矩阵。前沿的输入和 GPTQ、SmoothQuant 用的校准输入是本页编的随机数(带两路特别大的通道);GPTQ 按论文的算法逐列计算,省去了它为加速而成批更新的写法。桥架是示意,不过 GPTQ 每一步确实是一整列同时取整。平滑一章里,钢柱的高度整体缩小了一些,好让变高的两列放得下。实验台只做最简单的取整(对称、按最大值定格子),浮点格式只在正文里讲。
几个容易误会的地方
特别大的数出现在激活(输入)里,不在权重里;AWQ 说的“重要的权重”,是按输入的大小挑出来的。1.58 位是一个三值数的信息量,实际存储多是每个 2 位。Q4_K_M 不等于每个权重 4.5 位,在 Llama 3.1 8B 上平均 4.89 位。每秒词元数的“带宽 ÷ 字节”是上限,还没算 KV 缓存和其他开销。不同论文的困惑度用的数据和设置不同,不能横着比;同一张表里的才可比。量化感知训练和训练完再量化是两回事:BitNet 的结果来自从头训练,不能拿来说明任意模型都能事后压到 1.58 位。
常见问题 · 4
- 大语言模型的权重占多少显存?
一个模型有多大,基本就是参数的个数乘每个参数占的字节。Qwen2.5-7B 有 7,615,616,512 个参数,每个用 16 位、也就是 2 个字节存,共 15.2 GB。
02权重占满显存 ↑- 把权重量化成 4 位是怎么算的?
把一个数存成 4 位整数,就是把它放到一把只有 15 格的尺子上:−7 到 +7。一格多宽由缩放系数决定。
04落到格子上 ↑- BitNet b1.58 的 1.58 位是什么意思?
走得最远的是 BitNet b1.58:从头训练时,每个权重只能是 −1、0 或 +1。先除以整块权重绝对值的平均数 γ,再四舍五入,截在 −1 到 1 之间。三种取值合 log₂3 ≈ 1.58 位。
08只剩 −1、0、+1 ↑- 大模型量化到 4 位会损失多少?
在 LLaMA3-8B 上(WikiText2,16 位是 6.1),每组 128 个的 4 位量化:RTN 8.5,GPTQ 6.5,AWQ 6.6。
10丢了什么 ↑
资料来源
- Qwen 团队:Qwen2.5-7B 模型权重与配置(Apache 2.0;修订 d1497293)
- OpenAI(2025):gpt-oss-120b & gpt-oss-20b Model Card
- Llama Team, AI @ Meta(2024):The Llama 3 Herd of Models
- Google(2025-04-18):Gemma 3 QAT Models: Bringing state-of-the-Art AI to consumer GPUs
- Ma 等(2025):BitNet b1.58 2B4T Technical Report
- Ma 等(2024):The Era of 1-bit LLMs: All Large Language Models are in 1.58 Bits
- Micikevicius 等(2017):Mixed Precision Training,ICLR 2018
- Kalamkar 等(2019):A Study of BFLOAT16 for Deep Learning Training
- Micikevicius 等(2022):FP8 Formats for Deep Learning
- Open Compute Project(2023):OCP Microscaling Formats (MX) Specification v1.0
- NVIDIA(2025-06-24):Introducing NVFP4 for Efficient and Accurate Low-Precision Inference
- Dettmers 等(2022):LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale,NeurIPS 2022
- Xiao 等(2022):SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models,ICML 2023
- Frantar 等(2022):GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers,ICLR 2023
- Lin 等(2023):AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration,MLSys 2024
- Dettmers、Zettlemoyer(2022):The case for 4-bit precision: k-bit Inference Scaling Laws,ICML 2023
- Liu 等(2024):KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache,ICML 2024
- Hooper 等(2024):KVQuant: Towards 10 Million Context Length LLM Inference with KV Cache Quantization
- Huang 等(2024):An empirical study of LLaMA3 quantization: from LLMs to MLLMs
- Dutta 等(2024):Accuracy is Not All You Need,NeurIPS 2024
- Kumar 等(2024):Scaling Laws for Precision,ICLR 2025
- DeepSeek-AI(2024):DeepSeek-V3 Technical Report
- NVIDIA:H100 规格
- Apple:Mac Studio 技术规格
- ggml-org:llama.cpp 的 quantize 说明(MIT)
- ggml-org:GGUF 文件格式说明(MIT)
- MLX:mlx.core.quantize 文档
- Wang 等(2024):1-bit AI Infra: Part 1.1, Fast and Lossless BitNet b1.58 Inference on CPUs
数据
The weights on the tray are real: a 24 × 48 window (the bench: 32 × 512) of one weight matrix of Qwen2.5-7B (Apache 2.0; layer 14, attention output projection), read as the published BF16 bits (docs/plates/quant/weights.py). The rounding, the errors and GPTQ’s sweep are computed by the page (src/topics/quant/science.js). The layer’s inputs on the tray’s front wall, with their two large channels, and the calibration inputs GPTQ and SmoothQuant use here are made up by the page. Material presets, parts and the softbox studio of the site’s model kit are ported from AirsupHQ/machine-skill (MIT, © 2026 Air Supply Technologies Inc.).
本页的文字、图片和模型采用 CC BY-NC 4.0 许可:可以免费用于教学和其他非商业用途,可以修改,请注明出自 world.lapla.si。上面列出的第三方素材仍按各自的许可。
引用这幅图版
拉普拉斯的迷你世界,图版 F43《大模型量化》,https://world.lapla.si/zh/quant/,CC BY-NC 4.0,2026-10-24 更新。
沿这个问题继续
 图版 F26词元与缩放定律大语言模型读的是词元,不是字。模型越大、读的词元越多,误差按一条幂律下降。台上是在浏览器里运行的字节对编码,和一组真实训练过的小模型。
 图版 F33推测解码大模型一次写一个词元,每写一个都要把全部权重从显存里读一遍:慢在读,不在算。推测解码让小模型先猜几个,大模型读一次权重就全部核对完,写出的文字和它自己一个个写的分布完全一样。台上的两个模型和每一个数,都在浏览器里计算。
 图版 F13Transformer 的注意力一个两层、八个头的小 Transformer,在你的浏览器里逐字读一句话,猜下一个字母。每条丝线是一次“注意”,亮度就是它的权重。
 图版 F25混合专家一个模型可以有几千亿个参数,每个词却只动用其中一小部分:路由器给每个词挑出几个“专家”,其余的不动。这里是一个真实训练过的小模型,16 个专家,每个字母只走 2 个。