KV 缓存与分页注意力
前面每个词元的键和值都要存着,越写越多。分成一样大的小块存放,像操作系统的内存页,写到哪里拿到哪里。
向下滚动
能做到什么
语言模型一次写一个词元。写每个新词元,注意力都要用到前面每个词元的键和值;把它们存着、不再重算,这份存储叫 KV 缓存。服务一个模型时,很多段话同时在写,各有各的缓存,都放在 GPU 的显存里。
2023 年的 vLLM 论文测得:在它之前的服务系统里,留给 KV 缓存的显存只有 20.4 % 到 38.2 % 真正存着词元的键和值。它提出的分页注意力(PagedAttention)把这个比例做到 96.3 %;在同样的延迟下,吞吐量是 FasterTransformer 和 Orca 的 2 到 4 倍。
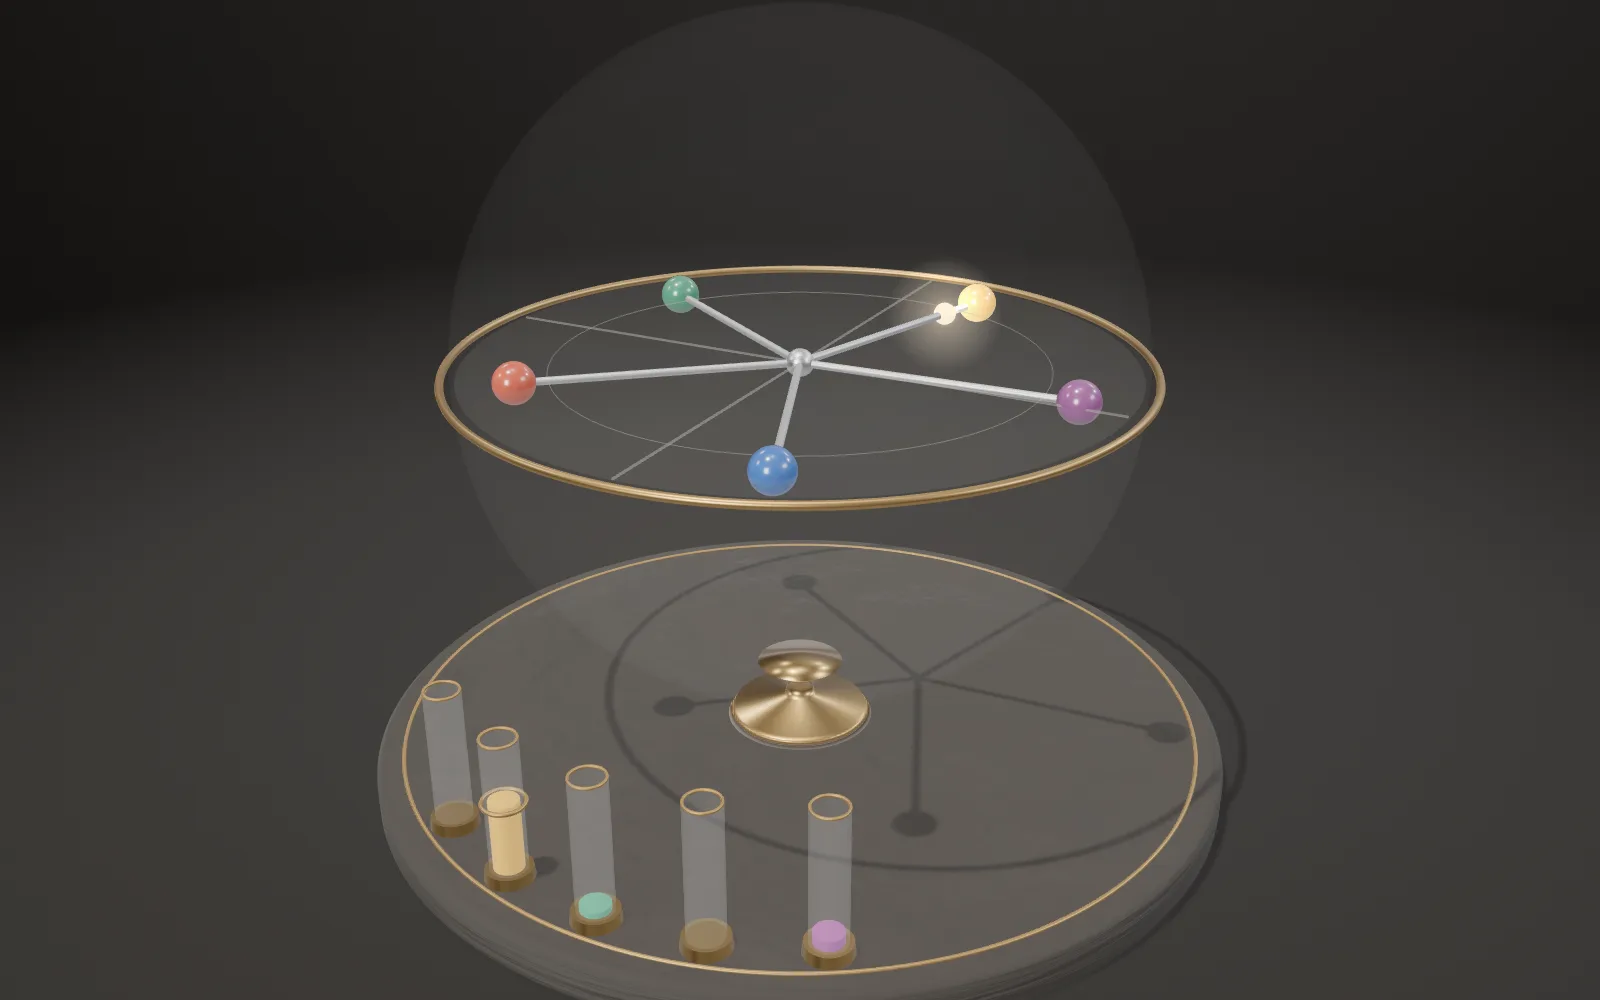
台上中间是留给缓存的那块显存,做成一台有 44 个格位的机器:一个格位是一块,装 4 个词元;一个词元是一对针,圆头的是键,方头的是值,颜色表示它属于哪一段话。后面是块表,前面是每段话已经写出的字。
之前的系统:存着词元的只有 20.4–38.2 % · 分页注意力:96.3 % · 同样延迟下吞吐量 2–4 倍
一次写一个词元
论文把生成分成两步。先是提示词阶段:整段提示一次算完,同时得到每个提示词元的键和值。然后是生成阶段:每一轮只进一个词元,算出它自己的键和值,再和前面所有的键、值做注意力,得到下一个词元。(键和值是什么,见图版「Transformer 的注意力」。)
前面词元的键和值,在后面的轮次里不会再变,所以算一次就存起来,每一轮只算新的那一个。论文写道,生成阶段一轮只算一个词元,用不满 GPU 的算力,受内存的限制,一段话的延迟大多花在这里。
台上每一轮,在写的每段话先把自己的针亮一遍:读它全部的缓存;再落下一对新针,前面的字模也多一个。新来的一段话,整段提示的针一次落下。
提示词阶段:整段一次 · 生成阶段:一轮一个词元 · 每一轮只算新词元的键和值
一个词元 800 KB
每个词元在每一层都有一个键、一个值。论文的例子 OPT-13B 有 40 层,每层的键和值各 5,120 个数,每个数用 2 字节的 16 位浮点。一个词元就是 2 × 5,120 × 40 × 2 = 819,200 字节,论文写作 800 KB。OPT 一段最长 2,048 个词元,一段话的缓存可以多到 1.6 GB。
论文的图 1:在一块 40 GB 的 NVIDIA A100 上跑 13B 的模型,权重占 26 GB,约 65 %;缓存约 30 %,按论文的表 1 是 12 GB,能放约 15,700 个词元的键和值。每段话都按 2,048 个词元算,只够 7 段。
台上切开一角:盖板下面是 40 层薄板,一层代表模型的一层。一对针从顶上一直穿到底,一个词元的键和值,每一层都有一份。
OPT-13B:2 × 5,120 × 40 × 2 字节 ≈ 800 KB 一个词元 · 2,048 个词元 ≈ 1.6 GB
先占好最长的位置
在 vLLM 之前,服务系统把一段话的缓存存成一整块连续的内存:深度学习框架里的运算,大多要求张量在内存里是连续的。一段话最后写多长,事先不知道,于是按它可能的最大长度,比如 2,048 个词元,一开始就留够。
论文在实验里重做了 Orca 的三种留法。全按最大长度留的那种,OPT-13B 在 40 GB 的 A100 上平均一次只能同时写 7.00 段话,正是 12 GB 除以 2,048 个位置的结果。
台上换成这种做法:每段话一开始就占下连续的一整排格位,从头往后填。块表用不上了,翻牌都是空的。
一段话一整块连续的内存 · 按最大长度先留够 · 12 GB 里只放得下 7 段 2,048 个词元
三种浪费
论文把这种留法的浪费分成三种。预留:给还没写出的词元留着的位置,最后会用上,可在这段话写完之前,别人也用不了。内部碎片:按最大长度多留、到写完也没用上的位置。外部碎片:分配器在各段之间留下的空隙,太小,放不进新的一段。
外部碎片一开始就知道用不上;内部碎片要等一段话写完才知道。论文测得,三种 Orca 的缓存里存着词元的只有 20.4 %(按最大长度留)、26.8 %(最多多留一倍)和 38.2 %(假设事先知道每段写多长,实际做不到)。
台上:针是写好的词元;浅色的环是预留,暗色的环是内部碎片,灰色的环是外部碎片。
存着词元的只有 20.4–38.2 % · 其余是预留、内部碎片、外部碎片
像内存分页
分页注意力借的是操作系统的办法:虚拟内存和分页。操作系统把内存切成一样大的页;程序看来连续的页,可以落在不连续的物理内存里,也不用事先全部留好。论文的比方是:块就是页,词元就是字节,请求就是进程。
每段话的缓存切成块,一块装固定个数词元的键和值。在一段话自己看来,它的块是连续的,叫逻辑块;它们实际放在显存的哪里都行,叫物理块。块都一样大,所以没有外部碎片。
vLLM 默认一块装 16 个词元(论文 2023 年的设定,今天的 v0.32.0 仍以 16 为默认)。台上一块画 4 个,和论文的插图一样。一段话的针,散在各处的格位里。
块是页 · 词元是字节 · 请求是进程 · vLLM 默认一块 16 个词元,台上画 4 个
块表
每段话有一张块表。论文写道,表里每一项记下一个逻辑块对应的物理块,和这一块已经填了几个位置。台上后面的翻牌板就是块表:一行一段话,一格一个逻辑块,翻出来的数是物理块的编号,下面四个小点是填了几个。
新的物理块,只在前面的块都填满时才分配。所以一段话浪费的,最多是它最后一块里没填的位置,不到一块。论文的图 2 里,vLLM 的缓存有 96.3 % 存着词元。
注意力也按块来算:内核照着块表一块块取出键和值,块和块在显存里不必相邻。一段话写完,它的块就还回去,给别的话用。
块表一项:物理块编号 · 已填几个 · 前面的块填满了才分配新块
放不下的时候
请求太多、块不够时,vLLM 先来先服务:最早到的先写,最晚到的先让出位置。一段话的块要么全留,要么全让,因为写下一个词元要用到它全部的缓存。
让出的块,论文给了两种办法:搬到 CPU 的内存里,轮到时再搬回来;或者干脆丢掉,轮到时把提示和已经写出的词元当成一段新的提示,一次重新算出缓存。论文测得,块很小时搬来搬去更慢;16 到 64 个词元一块时,两种做法差不多。
今天的 vLLM 去掉了论文里搬到 CPU 的那种做法,让出的请求重算。台上来的话比格位多:最晚开始的一段让出全部格位,等别的写完,再一次把针全部落回去。
先来先服务 · 一段话的块全留或全让 · 搬到 CPU,或者丢掉重算
快了多少
论文在 A100 上测了 OPT-13B、66B、175B 和 LLaMA-13B,按 ShareGPT 和 Alpaca 两个数据集里输入、输出的长度造出请求。同样的延迟下,vLLM 的吞吐量是 FasterTransformer 和 Orca 的 2 到 4 倍;序列越长、模型越大、解码方法越复杂,差得越多。
快在同时能写的段数。OPT-13B,ShareGPT 数据,每秒 2 个请求:vLLM 平均同时写 30.42 段话,按实际长度留的 Orca 13.62 段,最多多留一倍的 9.81 段,按最大长度留的 7.00 段。
也有差得不多的时候:OPT-175B 用 8 块 GPU 跑 Alpaca,显存宽裕、句子短,按实际长度留和最多多留一倍的 Orca 也能同时写很多段,瓶颈变成了算力。
OPT-13B,ShareGPT,每秒 2 个请求:同时 30.42 段 · 13.62 段 · 9.81 段 · 7.00 段
后来的做法
很多请求开头相同,比如同一段系统提示。论文里,服务方可以为预先定好的前缀留出一组块,让请求直接共用。今天的 vLLM 默认自动做前缀缓存:每个写满的块按它的词元和它前面的全部内容算一个散列,新请求开头相同,就用现成的块。文档说,它只省下处理提示的时间,不加快生成新词元。SGLang 用基数树管理这些缓存。
也有办法让每个词元本身小一点:让几个注意力头共用一组键和值。Falcon-7B 所有头共用一组,一个词元 8 KB;Llama 2 的 70B 模型 64 个头只配 8 组键和值,一个词元 320 KB,模型大得多,缓存却是 OPT-13B 的五分之二。
还可以把缓存存得粗一点:vLLM 支持用 8 位浮点存,每个数 1 字节,同样的显存放下约两倍的词元。(缓存的量化,见图版「大模型量化」。)
前缀缓存:相同的开头只存一份 · 每个词元:OPT-13B 800 KB · Llama 2 70B 320 KB · Falcon-7B 8 KB
它没有说的
分页省下的是浪费,不是每个词元的大小:一个词元的键和值还是那么多,缓存还是随着词元一个个变长。KV 缓存也不让模型能读更长的文字,能读多长是训练定的:Llama 2 的上下文从上一代的 2,048 个词元加到 4,096 个,靠的是训练。
按块去找也有代价。论文的测试里,vLLM 的注意力内核比 FasterTransformer 的慢 20 % 到 26 %;这只是注意力一个运算,整体上 vLLM 仍然快得多。论文也写道,训练,以及受算力限制、不是大语言模型的服务,用不上这套办法,反而可能更慢。
同一个词出现在不同位置,键和值不同,不能共用;能共用的只有完全相同的开头。
每个词元的大小不变 · 能读多长由训练决定 · 注意力内核慢 20–26 %(论文的测试)
拆开来看
台子拆成几件:带格位的盖板,44 块插板,一对对的针,40 层薄板,底座;后面是块表的翻牌板,前面是字模和字盘。
一块插板就是一个物理块,4 个孔位各插一对针。块表的每一格翻牌,指向一块插板。
盖板 · 插板 · 键和值 · 40 层 · 底座 · 块表 · 字模
实验台
拉杆选怎么分配:一块装 1、2、4、8 或 16 个词元,或者不分块,每段话一来就按最长 20 个词元占好一整排(“最长”)。另一个选项是一共来多少段话。每按一次“运行”都从头开始:一段段话陆续到来,写完就离开,放不下的要等。
读数:同时在写的最多几段,留出的内存里平均有多少存着词元,全部写完用了几轮。
这是本页的模型:44 块、176 个格,一段话最多 20 个词元,长短是随机定的,不是论文的测量。块越大,最后一块空着的越多;块小到一个词元,几乎不浪费,可论文说,块太小时 GPU 一次读得太少,反而慢。
读数:同时最多几段 · 存着词元的比例 · 用了几轮
试一试一块装 1 个词元时,留出的内存里存着词元的比例是多少?装 16 个呢?一段话都先占好 20 个位置时,同时能写几段?
模型省略了什么
台上的机器是一个模型,不是 GPU 的样子。显存画成 44 块,一块 4 个格,一共 176 个词元的位置;论文里 A100 上留给缓存的 12 GB 能放约 15,700 个,vLLM 默认一块 16 个词元。40 层薄板是 OPT-13B 的层数,台上一块里放着这 4 个词元在全部 40 层的键和值;vLLM 实际按层、按头分开存,论文说两种做法性能没有差别。一个字模算一个词元,真实的分词切法不同。每一轮放慢到一秒多;针亮起来,只是表示这一轮的注意力读到了哪些键和值。论文的 KB、GB 按 1,024 进位。
几个容易误会的地方
20.4 % 到 38.2 % 是留给 KV 缓存的那部分显存里的比例,不是整块显存的;比较的三种 Orca 是作者按论文自己重做的(Orca 没有公开),其中按实际长度留的一种要事先知道每段写多长,实际做不到。“浪费不到 4 %”是 vLLM 博客的说法,论文写的是“接近零浪费”,图 2 里是 96.3 %。2 到 4 倍是同样延迟下的吞吐量,在论文的模型和数据上测得。分页不让每个词元变小,也不让模型能读更长的文字。同一个词出现在不同位置,缓存不同,不能共用。搬到 CPU、按请求复制共用块这些做法,今天的 vLLM 已经改了:共用改由自动前缀缓存来做。
常见问题 · 5
- KV 缓存是什么?
写每个新词元,注意力都要用到前面每个词元的键和值;把它们存着、不再重算,这份存储叫 KV 缓存。
01能做到什么 ↑- 分页注意力之前,KV 缓存的显存用上了多少?
2023 年的 vLLM 论文测得:在它之前的服务系统里,留给 KV 缓存的显存只有 20.4 % 到 38.2 % 真正存着词元的键和值。
01能做到什么 ↑- OPT-13B 一个词元的 KV 缓存有多大?
一个词元就是 2 × 5,120 × 40 × 2 = 819,200 字节,论文写作 800 KB。
03一个词元 800 KB ↑- 分页注意力为什么叫“分页”?
分页注意力借的是操作系统的办法:虚拟内存和分页。
06像内存分页 ↑- KV 缓存的写时复制是什么?
轮到一个回答往共用的块里写时,系统先把这一块复制一份,写进副本,原来那块的计数减一;这叫写时复制,操作系统复制进程时也这样做。
08共用,写时复制 ↑
资料来源
- Kwon、Li、Zhuang、Sheng、Zheng、Yu、Gonzalez、Zhang、Stoica(2023):Efficient Memory Management for Large Language Model Serving with PagedAttention,SOSP 2023(arXiv 版)
- 同一篇论文,SOSP 2023 论文集(ACM)
- Kwon、Li 等(2023):vLLM: Easy, Fast, and Cheap LLM Serving with PagedAttention,vLLM 博客
- vLLM 文档:Automatic Prefix Caching(设计说明)
- vLLM 文档:Automatic Prefix Caching(功能说明)
- vLLM 文档:Metrics(KV Cache Offloading 一节)
- vLLM 源代码 v0.32.0:vllm/config/cache.py
- vLLM 文档:Quantized KV Cache
- Zhang 等(2022):OPT: Open Pre-trained Transformer Language Models
- facebook/opt-13b 的模型配置(Hugging Face)
- Vaswani 等(2017):Attention Is All You Need
- Pope 等(2022):Efficiently Scaling Transformer Inference
- Shazeer(2019):Fast Transformer Decoding: One Write-Head is All You Need
- Ainslie 等(2023):GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints,EMNLP 2023
- Touvron 等(2023):Llama 2: Open Foundation and Fine-Tuned Chat Models
- tiiuae/falcon-7b 的模型配置(Hugging Face)
- Zheng 等(2023):SGLang: Efficient Execution of Structured Language Model Programs
- NVIDIA:A100 Tensor Core GPU 数据手册
数据
The machine is a model of the bookkeeping in Kwon et al., “Efficient Memory Management for Large Language Model Serving with PagedAttention” (SOSP 2023): 44 blocks of 4 token slots (vLLM’s default block is 16 tokens; the paper’s figures draw 4), 40 layer plates for OPT-13B’s 40 layers. Its requests, their lengths and every count the page shows from the machine come from the page’s own simulation, not from measurements. The text on the type: eight quatrains of Tang poetry (Chinese page) and the openings of public-domain novels and the Gettysburg Address (English page), one character or one word to a token. Material presets, parts and the softbox studio of the site’s model kit are ported from AirsupHQ/machine-skill (MIT, © 2026 Air Supply Technologies Inc.).
本页的文字、图片和模型采用 CC BY-NC 4.0 许可:可以免费用于教学和其他非商业用途,可以修改,请注明出自 world.lapla.si。上面列出的第三方素材仍按各自的许可。
引用这幅图版
拉普拉斯的迷你世界,图版 F55《KV 缓存与分页注意力》,https://world.lapla.si/zh/kvcache/,CC BY-NC 4.0,2026-10-28 更新。
沿这个问题继续
 图版 F13Transformer 的注意力一个两层、八个头的小 Transformer,在你的浏览器里逐字读一句话,猜下一个字母。每条丝线是一次“注意”,亮度就是它的权重。
 图版 F51FlashAttention 与显存按标准做法,Transformer 的注意力在 GPU 上慢,多半不是因为算得多,而是要把一张 N × N 的分数矩阵写进显存再读回来。FlashAttention 把计算切成小块,放在芯片上的共享内存里算完,用边走边算的 softmax 得到同一个结果,这张矩阵从不进显存。
 图版 F33推测解码大模型一次写一个词元,每写一个都要把全部权重从显存里读一遍:慢在读,不在算。推测解码让小模型先猜几个,大模型读一次权重就全部核对完,写出的文字和它自己一个个写的分布完全一样。台上的两个模型和每一个数,都在浏览器里计算。
 图版 F43大模型量化大语言模型的权重原本每个用 16 位存。量化把它们落到更粗的格子上:8 位、4 位,甚至只剩 −1、0、+1。模型小几倍,读得也快几倍,代价是一点精度。
 图版 F26词元与缩放定律大语言模型读的是词元,不是字。模型越大、读的词元越多,误差按一条幂律下降。台上是在浏览器里运行的字节对编码,和一组真实训练过的小模型。