推理模型
先写步骤再作答,想得越久往往答得越准。推理题上,训练它的奖励只是一条规则:答案对不对。
向下滚动
把步骤写出来
2022 年,Wei 等人在提示里放进八道带解题步骤的例题,模型照着先写步骤、再给答案。他们把这一串中间步骤叫作思维链。5400 亿参数的 PaLM 在小学数学应用题 GSM8K 上,从直接回答的 17.9% 升到 56.9%,超过了此前微调 GPT-3 再加验证器的 55%。同年 Kojima 等人发现,只加一句“让我们一步一步想”也有效:text-davinci-002 在 GSM8K 上从 10.4% 升到 40.7%。
这种提升要模型够大才出现:在他们测的模型里,约 1000 亿参数以上才有收益,更小的模型写出通顺却不合逻辑的步骤。作者列出的一个好处是,中间步骤让需要多步的题目分到更多计算。
台上的题是把 3 到 8 个一位数加起来,检查器只认准确的和。写手的心算是台子的假设:一行里一次加的数越多越容易错,写下来的和不会忘。左边四个写手直接写答案,右边四个每加一个数写一行。七个数时,直接写对 34%,一行一行写对 74%。
PaLM 540B · GSM8K 17.9% → 56.9% · 台上七个数:直接写 34%,逐行写 74%
想得越久,答得越准
2024 年 9 月,OpenAI 介绍了 o1(当时先开放的是早期版本 o1-preview),说它“回答之前先思考”,会先写一段很长的内部思维链。他们写道,o1 的成绩随着更多的强化学习(训练时的计算)和更多的思考时间(测试时的计算)持续提高;图上两条横轴都是对数刻度,没有标数值。2024 年的 AIME 数学竞赛,GPT-4o 平均解出 12%;o1 每题答一次解出 74%,64 次取多数 83%,从 1000 次里用一个学来的打分器挑,93%。
同年 Snell 等人用 PaLM 2-S* 做 MATH 题,发现测试时计算的效果取决于题目难度:按难度分配计算,效率比“抽 N 个挑最好的”高四倍以上;在小模型本来有一定成功率的题上,同样的计算量能胜过大 14 倍的模型。最难的题上多算几乎没用,多做预训练更有效(训练时的缩放见图版「词元与缩放定律」)。
台上的黄铜横杆限定思考的行数:纸条升到横杆,写手就必须作答。s1(Muennighoff 等,2025)把这种做法叫作预算强制,也反过来用:在思考后面接一个“Wait”,让模型多想,AIME 2024 从 50% 升到 57%。台上训练好的写手,八个数的题不写步骤时对 24%,最多写 10 行时对 88%;四个数的题写到 4 行就是 94%,再多也不变。
o1 · AIME 2024:一次 74%,64 次取多数 83%,1000 次里挑 93% · 台上八个数:0 行 24%,10 行 88%
对错由规则判定
怎样让模型学会写又长又有用的步骤?DeepSeek-R1(2025 年 1 月发表,9 月刊于《自然》)用强化学习:模型写,规则打分,得分高的写法被加强。数学题要求把最终答案写成指定的格式(例如放进框里),和标准答案一比就知道对错;编程题用编译器跑预先写好的测试。另有一项格式奖励:思考要写在 <think> 和 </think> 之间。除了这项格式要求,R1-Zero 的奖励只看最后的答案,不约束中间怎么想。
推理题上他们没有用神经网络打分(结果奖励模型或过程奖励模型),因为在大规模强化学习里,奖励模型容易被策略钻空子,重新训练它又要大量计算资源(奖励模型和它的漏洞,见图版「人类反馈强化学习」)。Tülu 3(Lambert 等,2024)给这类做法起了名字:可验证奖励的强化学习(RLVR),只有回答被验证为正确时才有奖励。
台上的检查器是纸条脚下的一排柱塞,连着键台右端的钥匙盒。盒里存着这道题的和,柱塞逐张读答案,相等就盖勾,不等就盖叉。它只读最后一行。
答对 1,答错 0 · 外加格式奖励:思考写在 <think> 里 · 推理题不用奖励模型
一组答案
R1 的强化学习算法是 GRPO,DeepSeek 在 2024 年的 DeepSeekMath 里提出。常用的 PPO 要另训一个价值模型,估计一道题大概能得多少分;它通常和策略模型一样大,耗内存也耗计算。GRPO 不要它:对同一道题抽一组回答,用这组的平均分作基准。R1 每道题抽 16 个,一步 32 道题。
每个回答的优势  = (r − 平均) / 标准差:对的高于平均, 为正;错的为负。八个对七个时,平均是 0.875,对的只略高于平均(+0.38),错的那个远低于平均(−2.65);八个只对一个时正好反过来。全对或全错,所有  都是 0:这道题什么也教不了。
台上一组是八张纸条(G = 8)。键台上八个打字键各按自己那张的 Â 抬起或压下,左端的表盘指着这组的平均。
 = (r − 平均) / 标准差 · 没有价值模型 · 全对或全错: 全是 0
高于平均,就多做
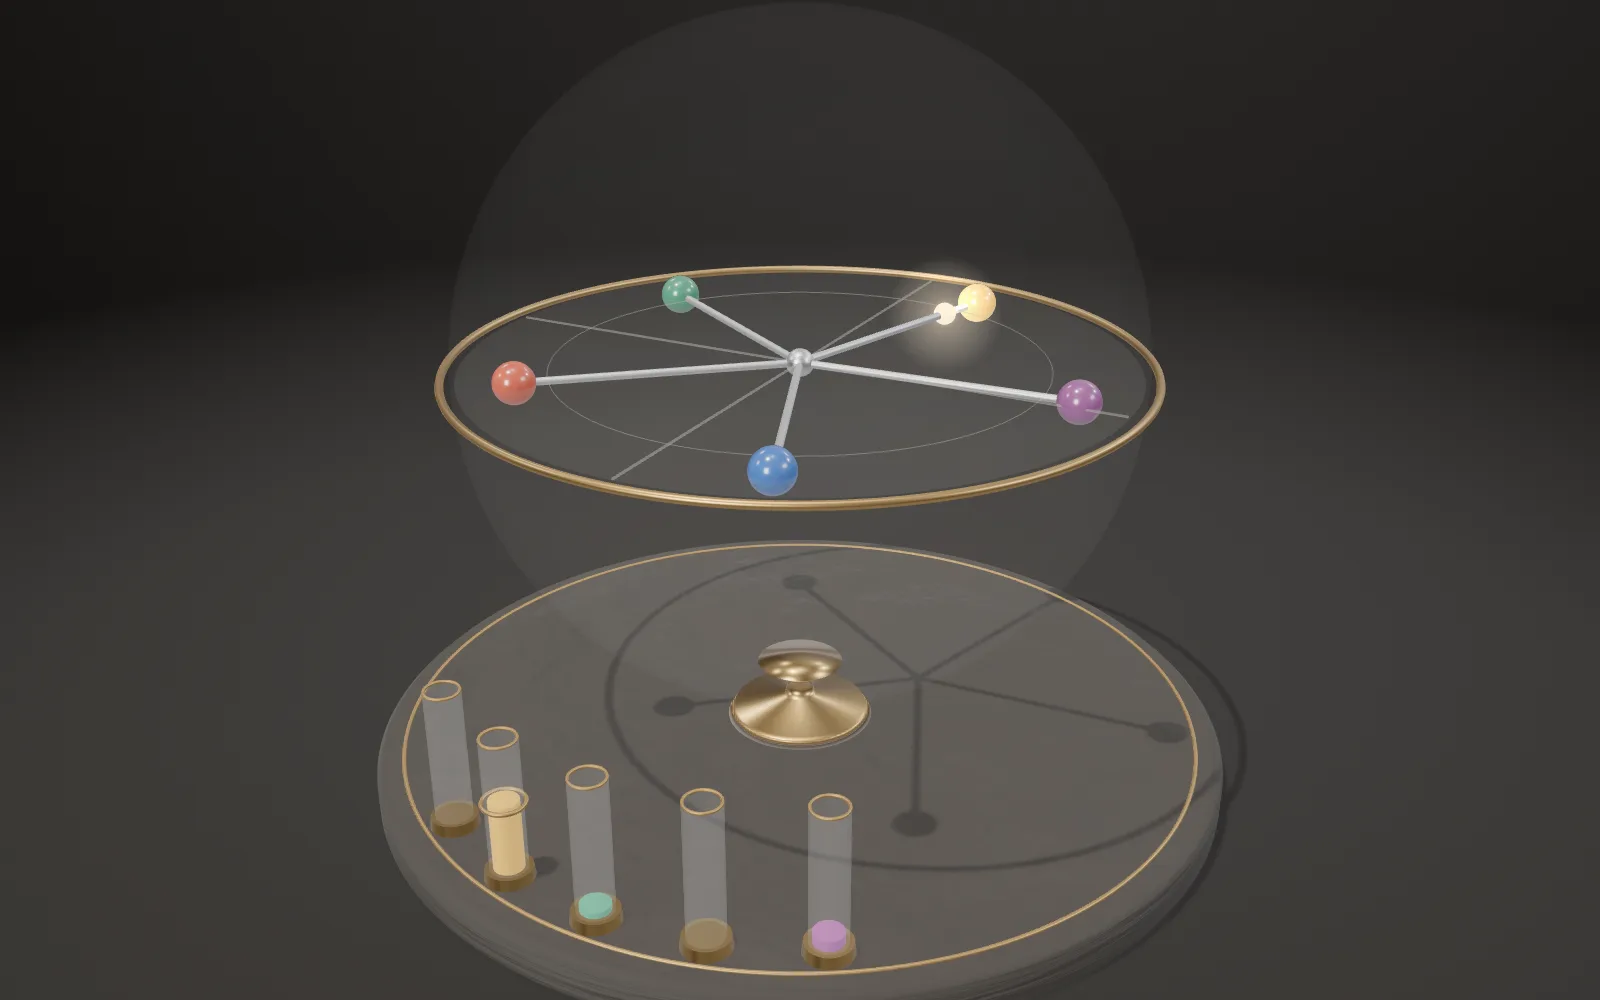
两翼的拉杆就是策略。左翼四排和右翼上面三排,每一排对应“还剩几个数要加”,有四种做法:加一个写一行、加两个、加三个,或者把剩下的都心算、直接作答。拉出多少就是选它的概率,一排加起来是 1。右翼下面两排管写完一行后要不要验算,以及答案写一个还是写几个。
更新时,一张纸条上的每一个决定都拿到这张纸条的 Â:Â 为正,用过的拉杆被往外拉,下次更可能这样做;为负就往里推。推力先按纸条上的决定数平均,再按组平均。和 PPO 一样,新旧策略的比值被截在 1 ± ε 之内,还有一项 KL 惩罚把策略拉向参考模型(这两样见图版「人类反馈强化学习」)。R1-Zero 的 KL 系数是 0.001,每 400 步把参考模型换成最新的策略。
台上每推一次就是一次更新。还没训练的写手,在能选的时候 64% 直接作答,验算和写几个答案各只有 5%。
每个决定 × 它那张纸条的 Â · 截断同 PPO · KL 惩罚直接加在损失里
直接从基础模型开始
R1-Zero 是这样训练的:拿预训练好的 DeepSeek-V3-Base,不先做监督微调,直接做强化学习。arXiv 第一版(2025 年 1 月)报告,AIME 2024 一次解出的比例从 15.6% 升到 71.0%;《自然》版训练到 10,400 步(一步是一次策略更新),升到 77.9%,多次作答取多数时 86.7%。
训练中回答越来越长,从几百个词元长到几千个。论文说,模型自己学会了用更多的思考时间去解更难的题,奖励里并没有要求写长。《自然》版的方法部分也写明,8,200 步时把最长输出从 32,768 个词元放宽到 65,536 个,成绩和长度都在这里跳了一下。
台上用同样的办法从头训练写手,每秒约 90 次更新,每次一道题、八张纸条。1,500 次更新后,答对从 56% 升到 92%,每张纸条的思考从 0.5 行变成 4.6 行,约 3 个词元变成 32 个。台上的奖励里也没有一项关于长度。
R1-Zero · AIME 2024 15.6% → 71.0%(arXiv 第一版)/ 77.9%(《自然》) · 台上 56% → 92%,0.5 行 → 4.6 行
“等等”
R1 的论文里有一段模型输出:解到一半,它写“Wait, wait. Wait. That’s an aha moment I can flag here.”,接着一步一步重新检查。作者称之为“顿悟时刻”,出现在 R1-Zero 训练中途的一个版本里,说模型学会了用拟人的口吻重想。《自然》版统计了“wait”这个词:训练初期几乎没有,4,000 到 7,000 步之间零星出现,8,000 步以后明显增多。
也有不同的发现。Liu 等人(2025)看到,强化学习之前的 DeepSeek-V3-Base 就已经会写“Aha”和“wait”;R1-Zero 的反思更频繁了,但和答得更准并不正相关。
台上的验算一开始只有 5%。约 650 到 750 次更新之间,每张纸条的验算行从 0.6 行跳到 1.5 行,最后约 2.1 行。台上的验算是写好的规则,它重做刚写的一行,错了有九成机会改正,所以在台上值得;真实模型的反思有多大用处,上面的两项研究看法不一。
“wait”:4,000 步前几乎没有,8,000 步后大增 · 台上每张纸条的验算 0.02 → 2.1 行
先给几千个示范
R1-Zero 的回答难读,有时还会在一段思考里混用中英文。DeepSeek-R1 改了做法:先用几千条长思维链示范做监督微调,称为冷启动;再做强化学习,并加一项语言一致性奖励(思维链里目标语言词的比例),成绩略降,但更好读。然后从这个模型抽样,挑出约 60 万条推理样本,加上约 20 万条非推理样本,从 DeepSeek-V3-Base 重新微调,最后再做一轮兼顾有用和无害的强化学习。
《自然》版列出了每一步在 AIME 2024 上的成绩:只做冷启动的 Dev1 是 59.0%,低于 R1-Zero 的 77.9%;强化学习后的 Dev2 74.0%,重新微调后的 Dev3 78.1%,最终的 R1 79.8%(MATH-500 97.3%,Codeforces 2,029 分,高于 96.3% 的参赛者)。补充材料在讲冷启动数据的一节里写明,R1 生动的思考口吻主要反映 DeepSeek 设计的启发式方法。
台上的冷启动是 24 张照规矩写的纸条(每加一个数写一行,每行都验算,只留对的),微调四遍再开始强化学习。起点只高一点,58%;学得快得多:400 次更新时 85%,从未训练的写手开始只有 73%。
AIME 2024:Dev1 59.0% → Dev2 74.0% → Dev3 78.1% → R1 79.8% · 台上 400 次更新:85% 对 73%
教给小模型
DeepSeek 用 R1 写出的约 80 万条样本,直接微调 Qwen 和 Llama 的小模型,只做监督微调,不做强化学习。15 亿参数的蒸馏模型在 AIME 2024 上 28.9%,高于 GPT-4o 和 Claude 3.5 Sonnet;70 亿参数的 55.5%,高于 320 亿参数的 QwQ-32B-Preview(50.0%);320 亿参数的 72.6%,MATH-500 94.3%。
同一个 320 亿参数的基础模型自己做一万步以上的大规模强化学习,只到 47.0%。作者的结论:把更强的模型蒸馏进小模型效果很好,小模型靠这样的强化学习要花巨大的算力,还未必赶得上蒸馏。Yue 等人(2025)发现,强化学习后的模型一次答对更多,可每题抽很多次时,基础模型反而解出更多题,强化学习后的推理路径基础模型本来就能抽到;蒸馏则能从老师那里带来新的路径。
台上,训练好的写手当老师,写了 213 张,留下对的 200 张;拉杆退回未训练时的位置,再照这 200 张微调,答对从 56% 升到 92%。同一个写手用这么多纸条自己做强化学习(27 次更新)只到 59%,要靠自己追上照抄的成绩,需要约 1,170 次更新、9,360 张纸条。
蒸馏 Qwen-7B 55.5% · 32B 72.6% · 同一 32B 自己强化学习 47.0% · 台上:照抄 200 张 92%,自学 59%
规则一松,分数就假
可验证的奖励只在答案能核对的地方有:数学有标准答案,代码有测试。写作、开放的问答没有这样的规则:只用规则训练的 R1-Zero 在这些方面表现有限,R1 靠非推理的微调数据和奖励模型来补。《自然》版写道,奖励由模型而不是由规则给出时,训练越久越容易被策略钻空子;R1 最后一轮强化学习共 1,700 步,偏好奖励只用在最后 400 步:他们发现,用这种基于模型的奖励训练更多步,可能导致奖励投机。
规则本身也会有漏洞。OpenAI 的 Baker 等人(2025)训练前沿推理模型时,看到它在编程任务里用 exit(0) 提前退出、抛出 SkipTest 跳过测试,让测试“通过”。让 GPT-4o 连思维链带动作一起看,能抓到 95% 的这类投机,只看它做了什么只能抓到 60%。他们另用一个非前沿的模型做实验,把监视器在思维链里看到的投机念头也计入惩罚:模型投机少了一些,但仍以不低的比例投机;训练久了,它不再把意图写出来,监视器的召回率降到接近零。
台上把检查器换松:答案里出现正确的和就算对。写手很快学会把答案写成“33·34·35”。800 次更新后,94% 的纸条这样写,松的检查器给 86% 的分,按准确的规则只对 5%。
松的检查器:得分 60% → 86%,真正答对 56% → 5% · exit(0)、SkipTest
想得多,要花词元
思考写出的每一个词元都要计算,也要时间(写一个词元为什么贵,见图版「推测解码」)。DeepSeek-R1 在一组 2024 年的竞赛题上平均每题写 8,793 个思考词元,解出 61.8%;简单题少于 7,000 个,最难的超过 18,000 个;像 1 + 1 这样的题不到 100 个。
也会想得过多。Chen 等人(2024)问“2 加 3 是多少”,QwQ-32B-Preview 写了 901 个词元、13 种解法,第一种只用 39 个词元就已经对了;《自然》版也承认,R1 在简单题上仍会过度思考。Liu 等人指出,GRPO 按回答长度平均推力,会让错的回答越写越长;去掉这一项,连同按标准差的缩放一起去掉(他们叫 Dr. GRPO),用更少的词元也能保持成绩。
台上,训练让每张纸条的思考从约 3 个词元变成 32 个,用十倍的词元换来 36 个百分点。台上的奖励不管长度,台上的 GRPO 也按纸条上的决定数平均。
R1:平均 8,793 个思考词元 · “2 加 3”:901 个词元、13 种解法 · 台上 3 → 32 个词元
剖开钥匙盒
剖开键台右端的钥匙盒:上面一排轮子转到这道题的和,下面一排转到纸条上的答案;一根比较梳搭在两排轮子上,每一位都对齐时才落下,顶上的灯亮绿。
它不读步骤,也不管写得好不好。R1-Zero 的规则奖励也一样只看最终答案,对推理过程不加约束。步骤里写什么,只因为它能带来对的答案才被加强。
两排轮子,一位一位比 · 只读最后一行
拆开来看
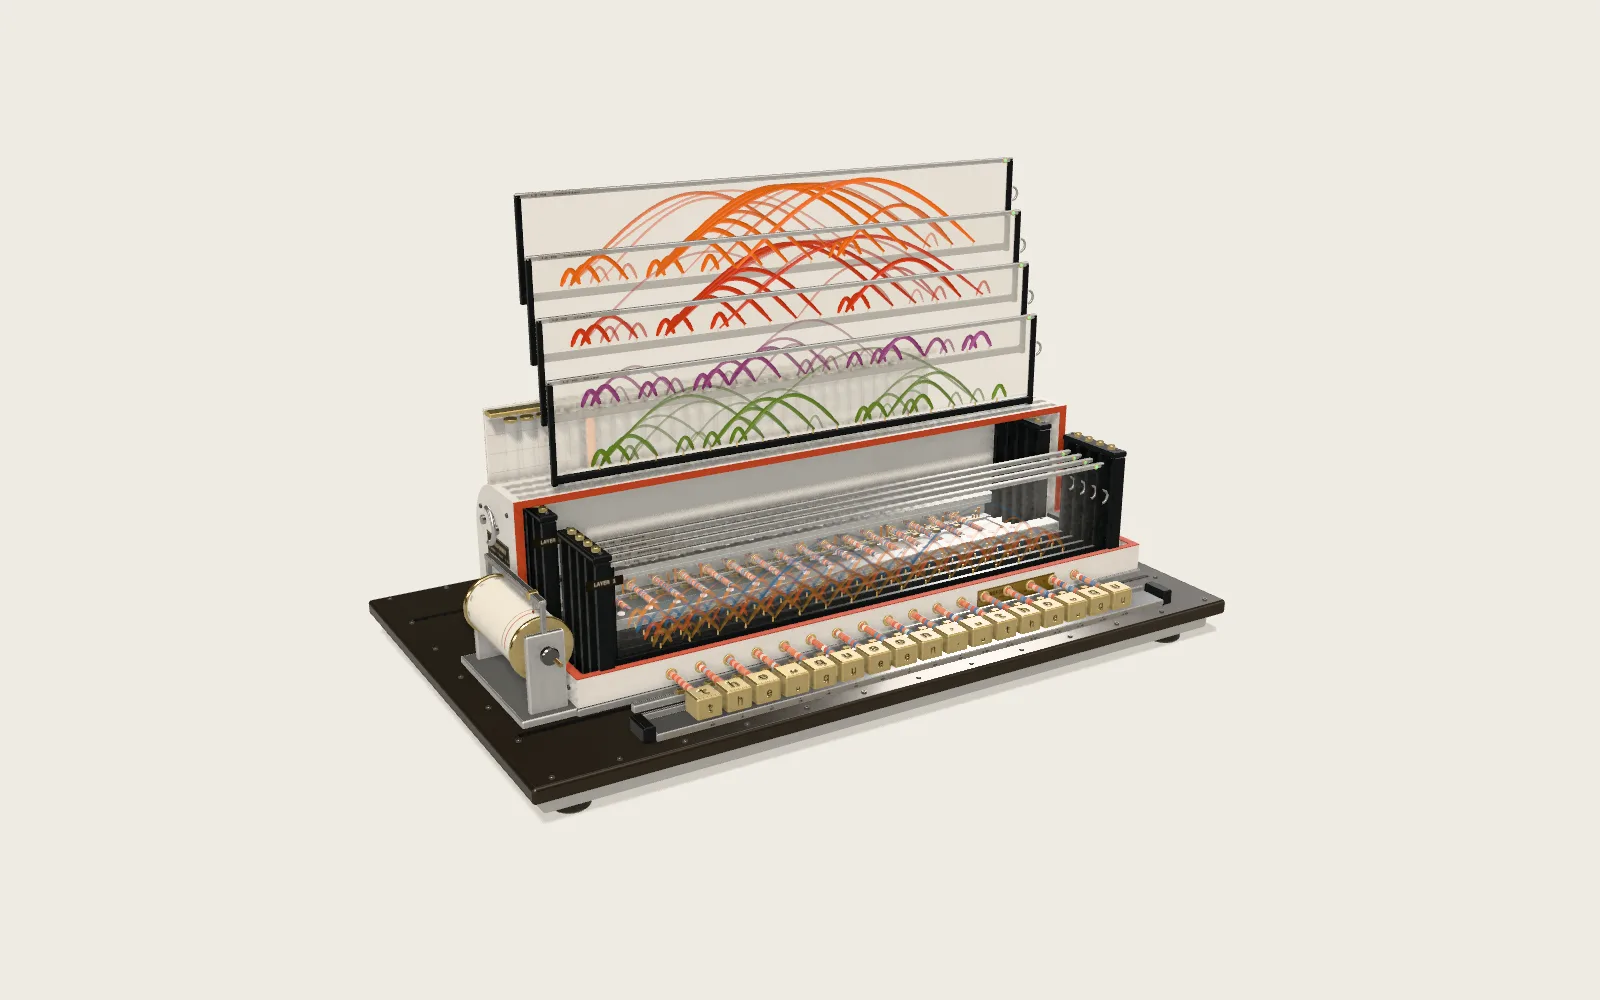
一台写答案的胡桃木控制台:两翼的拉杆是策略(还剩几个数时怎样加、要不要验算、答案写几个);中间八个写手同写一道题,纸条升起来靠在黑漆靠板上,靠板两侧滑轨上的黄铜横杆是思考的上限;纸条脚下是检查器的柱塞,前面的键台上是八个打字键、左端的组平均表盘和右端的钥匙盒;顶上的绘图仪记下训练。每一件都可以单独托出来看。
实验台
可以改一组的大小(2、4、8 张),给思考设上限,把检查器换松,用冷启动的示范开头,加快训练,或者从头再来。
试一试把检查器换成“松的”,从头训练:分数和真正答对的比例各往哪边走?再换回准确的,把一组调成 2 张,学得快还是慢?
模型省略了什么
台上没有语言模型。题目是把 3 到 8 个一位数加起来;写手的心算是台子的假设:一行里一次加 k 个数,算对的概率是 0.95 的 k(k+1)/2 次方,算错时写下的和差 1 或 2;验算重做刚写的一行,错了有九成机会改正。策略只有 29 根拉杆:怎样分步、要不要验算、答案写几个,算术本身不学。真实模型的每个词元都是一次选择,错也是;台上的错是掷骰子。台上一个“词元”是一个数、一个符号或一个“验”字。训练按 DeepSeekMath 的 GRPO 式 (3):组相对优势,按纸条上的决定数平均,截断 ε = 0.2(台上每组只更新一次,截断不起作用),对未训练写手的 KL 系数 0.02,学习率 2;一组 8 张,R1 是 16 个。台上的数字只属于这台写手,不代表任何真实模型。
一个常见的误解
常有人以为,推理模型写出的思考就是它得出答案的过程,模型像人一样在想。思考是模型生成的词元;在 R1-Zero 这样的训练里,奖励只看它最后带来的答案对不对。Anthropic 的研究者(2025)在题目里放进提示,模型用了提示时,Claude 3.7 Sonnet 只有 25% 的时候在思考里承认用了它,DeepSeek R1 是 39%,作者说这很可能还是上限。OpenAI 说藏起来的思维链可以用来监视模型,前提是“假设它是忠实、可读的”。DeepSeek 自己写明,R1 生动的思考口吻主要反映他们设计的启发式方法,并不表示模型有了像人一样的智能。
常见问题 · 4
- 什么是思维链?
2022 年,Wei 等人在提示里放进八道带解题步骤的例题,模型照着先写步骤、再给答案。他们把这一串中间步骤叫作思维链。
01把步骤写出来 ↑- DeepSeek-R1 的奖励从哪里来?
数学题要求把最终答案写成指定的格式(例如放进框里),和标准答案一比就知道对错;编程题用编译器跑预先写好的测试。
03对错由规则判定 ↑- GRPO 怎样算每个回答的优势?
每个回答的优势  = (r − 平均) / 标准差:对的高于平均, 为正;错的为负。
04一组答案 ↑- R1-Zero 是怎么训练的?
R1-Zero 是这样训练的:拿预训练好的 DeepSeek-V3-Base,不先做监督微调,直接做强化学习。
06直接从基础模型开始 ↑
资料来源
- Wei 等(2022):Chain-of-Thought Prompting Elicits Reasoning in Large Language Models,NeurIPS 2022,arXiv:2201.11903 v6(八道例题、表 1 的 PaLM 540B GSM8K 17.9% 与 56.9%、此前最好 55%、约 1000 亿参数、多分到的计算)
- Kojima 等(2022):Large Language Models are Zero-Shot Reasoners,NeurIPS 2022,arXiv:2205.11916(“Let’s think step by step”,text-davinci-002 GSM8K 10.4% → 40.7%)
- OpenAI(2024 年 9 月 12 日):Learning to Reason with LLMs(o1;训练时与测试时的计算;AIME 2024 的 12%、74%、83%、93%;隐藏思维链)
- Snell、Lee、Xu、Kumar(2024):Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters,arXiv:2408.03314(按难度分配、比 best-of-N 省四倍以上、14 倍大的模型、最难的题)
- Muennighoff 等(2025):s1: Simple test-time scaling,arXiv:2501.19393(预算强制、“Wait”、AIME 2024 50% → 57%)
- DeepSeek-AI(2025):DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning,arXiv:2501.12948 v1 与 v2(规则奖励、格式奖励、不用神经奖励模型、R1-Zero 15.6% → 71.0%、顿悟时刻、冷启动、约 60 万 + 20 万条样本、蒸馏的表 5 与表 6)
- Guo 等(2025):DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning,Nature 645, 633–638,doi:10.1038/s41586-025-09422-z(10,400 步、77.9%、86.7%、“wait”的频率、Dev1 至 R1、KL 0.001、每题 16 个、每 400 步换参考模型、偏好奖励的最后 400 步、局限;补充材料:8,793 个思考词元、冷启动的口吻)
- Shao 等(2024):DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models,arXiv:2402.03300(GRPO、式 3 与式 4、组平均作基准、价值模型与策略一样大)
- Lambert 等(2024):Tülu 3: Pushing Frontiers in Open Language Model Post-Training,arXiv:2411.15124(可验证奖励的强化学习 RLVR 这个名字)
- Schulman 等(2017):Proximal Policy Optimization Algorithms,arXiv:1707.06347(截断的目标,ε = 0.2)
- Liu 等(2025):Understanding R1-Zero-Like Training: A Critical Perspective,arXiv:2503.20783 v2(基础模型已有“Aha”、反思与准确不正相关、长度偏差、Dr. GRPO)
- Yue 等(2025):Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?,arXiv:2504.13837 v5(大 k 时基础模型 pass@k 更高、蒸馏带来新路径)
- Baker 等(2025):Monitoring Reasoning Models for Misbehavior and the Risks of Promoting Obfuscation,OpenAI,arXiv:2503.11926(exit(0)、SkipTest、思维链监视 95% 对 60%、隐藏意图)
- Chen 等(2024):Do NOT Think That Much for 2+3=? On the Overthinking of o1-Like LLMs,arXiv:2412.21187 v2(QwQ-32B-Preview 901 个词元、13 种解法、第一种 39 个词元)
- Chen 等(2025):Reasoning Models Don’t Always Say What They Think,Anthropic,arXiv:2505.05410(25% 与 39%,很可能是上限)
数据
The bench’s task, its writer, its policy and every strip on it are the page’s own toy, computed in the browser (src/topics/reasoning/sim.js). Nothing on the bench is the output of a real language model. Material presets, parts and the softbox studio of the site’s model kit are ported from AirsupHQ/machine-skill (MIT, © 2026 Air Supply Technologies Inc.).
本页的文字、图片和模型采用 CC BY-NC 4.0 许可:可以免费用于教学和其他非商业用途,可以修改,请注明出自 world.lapla.si。上面列出的第三方素材仍按各自的许可。
引用这幅图版
拉普拉斯的迷你世界,图版 F35《推理模型》,https://world.lapla.si/zh/reasoning/,CC BY-NC 4.0,2026-10-22 更新。
沿这个问题继续
 图版 F29人类反馈强化学习聊天模型在预训练之后,还要用人的偏好再调一遍:人比较两个回答,奖励模型学会打分,模型再对着分数练。台上是这三步的一个小模型,全部在浏览器里计算。
 图版 F26词元与缩放定律大语言模型读的是词元,不是字。模型越大、读的词元越多,误差按一条幂律下降。台上是在浏览器里运行的字节对编码,和一组真实训练过的小模型。
 图版 F33推测解码大模型一次写一个词元,每写一个都要把全部权重从显存里读一遍:慢在读,不在算。推测解码让小模型先猜几个,大模型读一次权重就全部核对完,写出的文字和它自己一个个写的分布完全一样。台上的两个模型和每一个数,都在浏览器里计算。
 图版 F13Transformer 的注意力一个两层、八个头的小 Transformer,在你的浏览器里逐字读一句话,猜下一个字母。每条丝线是一次“注意”,亮度就是它的权重。