Mamba 与状态空间模型
每个词元都存着,内存越用越多。换成一个大小固定的状态,由读到的词元决定留下什么。
向下滚动
能做到什么
语言模型读一段文字,每读一个词元都要留下点什么,才能接着往下写。Transformer 的注意力把前面每个词元的键和值都存着,越读越多(见图版「KV 缓存与分页注意力」)。状态空间模型换了个办法:把读过的内容压进一个大小固定的状态,每读一个词元更新一次。
2023 年的 Mamba 论文(Gu 和 Dao)让这次更新随每个词元而变。论文报告:生成文字时,吞吐量是同样大小的 Transformer 的 4 到 5 倍;用同样的数据训练,28 亿参数的 Mamba 在六项零样本测试上平均 63.3 分,同样大小的 Pythia 是 59.1,大一倍多的 Pythia-6.9B 是 61.7。
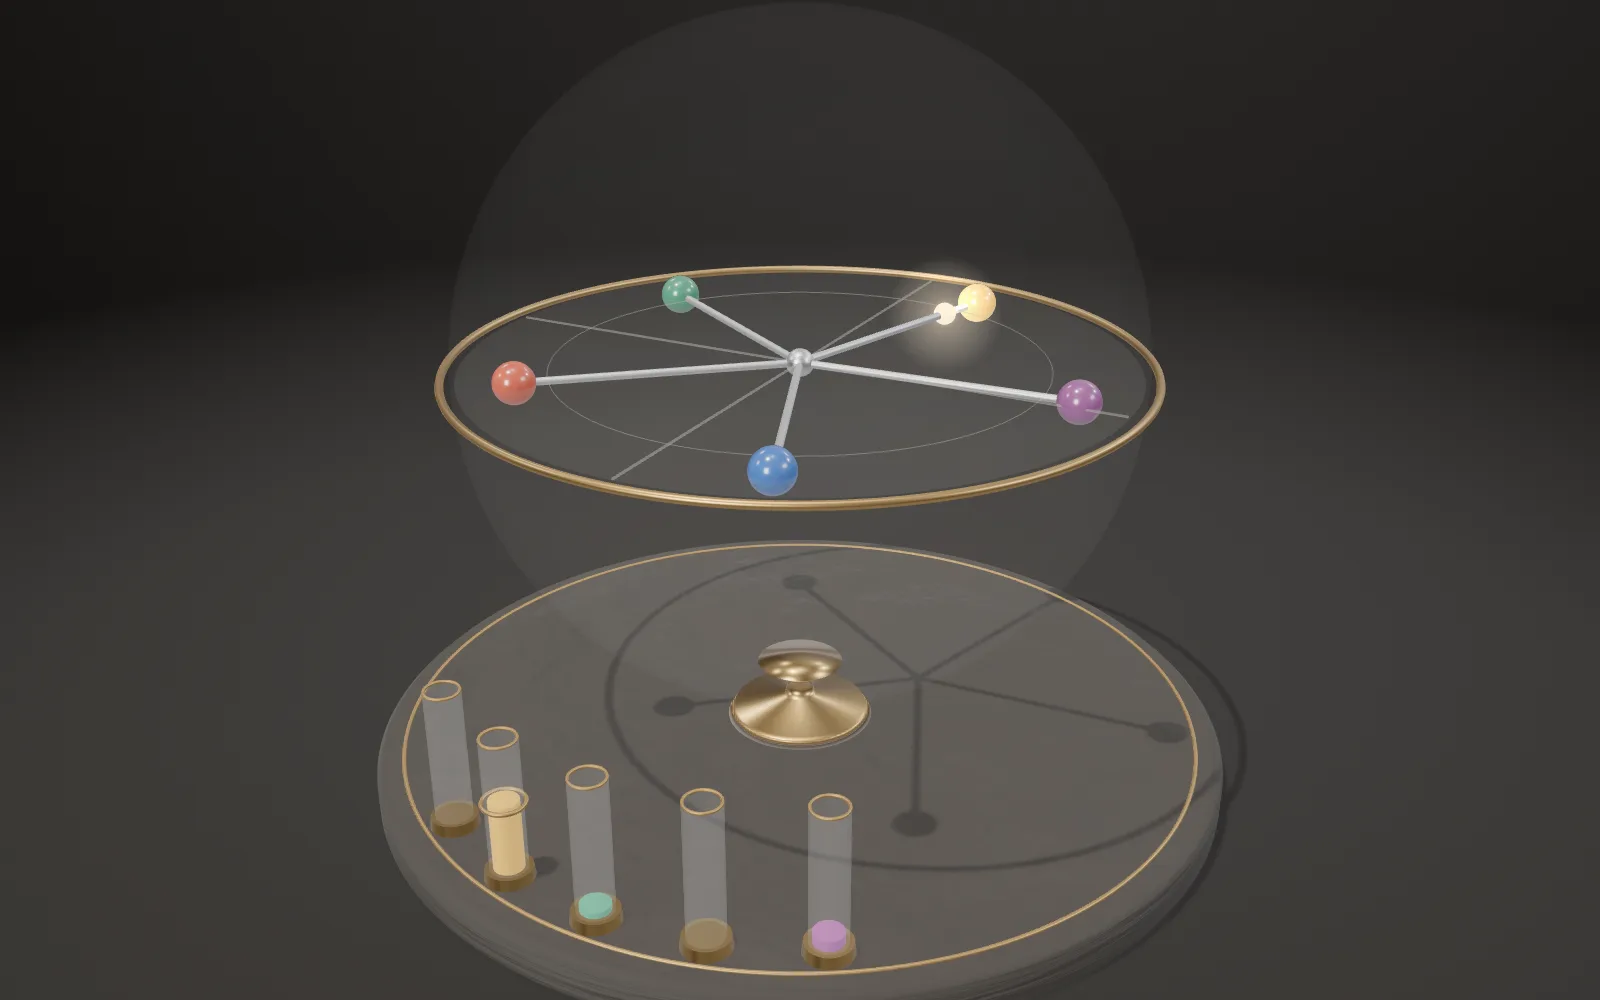
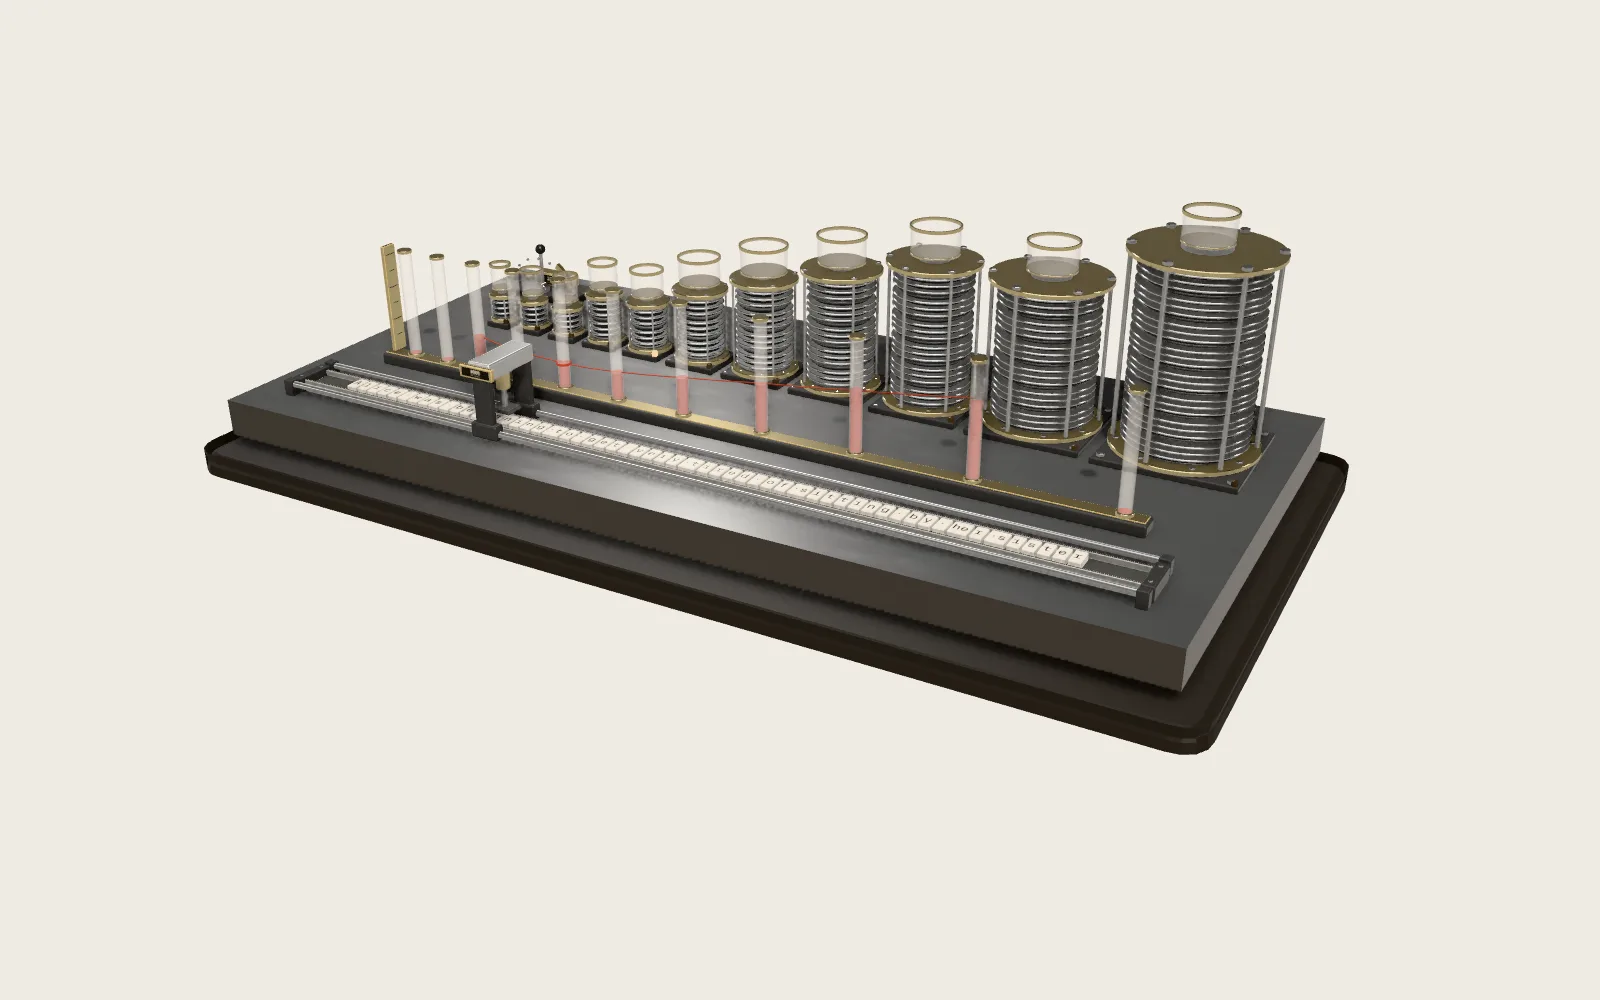
台上是一台读字的机器。前面一条纸带印着要读的词元,从右边的卷盘经过读头,卷到左边。读头后面是状态:8 行 × 16 根杆,杆的高低就是状态里的数,从头到尾不多也不少。最后面半透明的架子,是注意力要存的东西:每读一个词元,多插一对针。
生成吞吐量:同样大小的 Transformer 的 4–5 倍 · 平均分:Mamba-2.8B 63.3,Pythia-2.8B 59.1,Pythia-6.9B 61.7
越读越长的缓存
注意力写每个新词元,都要用到前面每个词元的键和值,所以全部存着,这就是 KV 缓存。读过多少词元,它就有多长。
Mamba 论文拿来比较的是 Pythia-2.8B:32 层,每层的键和值各 2,560 个数,每个数 16 位。一个词元要存 2 × 32 × 2,560 × 2 = 327,680 字节;读到它训练时最长的 2,048 个词元,一段话的缓存是 671 MB。
台后的架子就是这份缓存:每读一个词元,落下一对针,圆头是键,方头是值。一段文字读完,架子清空,下一段从头再来。前面的状态一直是那 128 根杆。
Pythia-2.8B:一个词元 327,680 字节 · 2,048 个词元 671 MB · 读多少存多少
固定大小的状态
状态空间模型来自控制和信号处理。一个系统有一组内部的数,叫状态 h;每来一个输入 x,状态更新一次:h ← Ā·h + B̄·x,再读出 y = C·h。Ā 决定旧的状态留下多少,B̄ 决定输入怎样写进去,C 决定从状态里读出什么。
不管读了多少词元,状态的大小都不变。Mamba-2.8B 的状态一段话一共 6,553,600 个数,16 位时 13.1 MB,读第 1 个词元和读第 100 万个词元时一样大。它有 64 层,每层 5,120 个通道,每个通道 16 个数,另有一个短卷积存着最近的 4 个输入。Pythia-2.8B 的缓存读到第 40 个词元就超过了它,到 2,048 个词元时是它的 51 倍。
台上的状态是 8 行 × 16 列,一共 128 根杆。一行是一个通道,一列是状态里的一个数;16 正是 Mamba 默认的状态大小,真实的一层有几千个通道。杆高于中线是正,低于中线是负。
Mamba-2.8B:6,553,600 个数,13.1 MB,不随长度变 · Pythia-2.8B 的缓存:第 40 个词元超过它,2,048 个词元时 51 倍
每一步都一样
Mamba 之前的结构化状态空间模型,比如 S4(Gu、Goel、Ré,ICLR 2022),对每个词元都用同一组 Δ、A、B、C。Mamba 论文把这叫作线性时不变:模型的动力学不随时间改变。
时不变有它的好处:整段的输出可以写成输入和一个固定卷积核的卷积,训练时一次算完;生成时再换成逐个词元的递推,每步的工作量不变。代价是它不能看内容取舍:要记住的词元和无关的词元,写进状态的方式完全一样,旧的内容也按同样的速度淡去。
台上换成这种做法:每个词元,右边的阀门都开在同一个位置。杆下的弹簧是 A,把每根杆拉回中线,越往右拉得越紧:A 从 −1 到 −16,这是 Mamba 的初始值。
每个词元同样的 Δ、A、B、C · 可以当作一次卷积来训练 · 不能按内容取舍
挑着记
Mamba 论文用两个人造任务说明时不变模型缺什么。选择性复制:长 4,096 的序列里,16 个要记的词元散在噪声词元中间,位置随机,最后按顺序说出来。归纳头:前面有过“Harry Potter”,后面再见到“Harry”,就要接上“Potter”。
两层的小模型做选择性复制,单用 S4 的准确率 18.3 %,把 S4 换成可选择的版本(论文叫它 S6)97.0 %,放进 Mamba 的块里 99.8 %。归纳头:在长 256 的序列上训练,Mamba 一直测到 1,048,576 个词元,也就是 4,096 倍长,都全对;论文测的注意力模型到 1,024 个词元时已降到 26.6 % 到 67.6 %,更长的因内存不够没有测。
台上的纸带换成这样一段:一个要记住的“月”,后面跟着一串点。按 Mamba 的规则,“月”写进去的那些杆一直是红的。
选择性复制:S4 18.3 % · S6 97.0 % · Mamba 99.8 % · 归纳头:训练长 256,测到 1,048,576 全对
由词元决定
Mamba 的改动在于:Δ、B、C 不再是固定的参数,而是从当前的词元算出来,各是一个小的线性投影。A 仍然固定,但旧状态留下多少是 exp(Δ·A),Δ 一变,留多少也跟着变。
论文这样解释 Δ:Δ 大,状态被重置,注意力放在当前的输入上;Δ 小,状态保持,当前的输入被忽略。B 决定一个词元写不写进状态、怎样写,C 决定状态怎样读到输出里。状态只有一个数时,这个更新就是循环神经网络的门,h ← (1 − g)·h + g·x(论文的定理 1)。
台上右边一排红色手轮是每一行的 Δ,升得越高,这一步越长;前面的梳子是 B,后面的是 C,每读一个词元都换一次。论文的消融实验(约 3.5 亿参数):Δ、B、C 都随词元变时困惑度 8.71,只有 Δ 随词元变时 9.81,都不变时 10.93。
Δ 大:重置,读进当前的词元 · Δ 小:保持,让它过去 · 状态只有一个数时就是门
在芯片上扫过去
Δ、B、C 随词元变了,整段就不能再写成一次卷积,只能一步步递推。直接这样算,每个词元、每个通道的整个状态都要写进 GPU 的显存,比输入和输出大 N 倍(N 是状态大小)。
Mamba 用了三个老办法。把几步合进一个内核:Δ、A、B、C 从显存读进芯片上很快的 SRAM,在那里离散化、递推,只把输出写回显存。递推用并行扫描。训练时反向传播要用的中间状态不存,到时候重新算一遍。显存和 SRAM 的区别见图版「FlashAttention 与显存」。
论文测得,这个扫描比没有融合内核的 PyTorch 实现快 20 到 40 倍;只比这一个运算,序列长于 2K 时比 FlashAttention-2 快(A100 80GB,批量为 1)。训练时的内存,和用 FlashAttention 的同样大小的 Transformer 差不多。
不把完整的状态写出去 · 在 SRAM 里离散化和递推 · 比 PyTorch 的扫描快 20–40 倍
快了多少,好了多少
生成:在一块 A100 80GB 上,先读 2,048 个词元的提示,再生成 128 个。Mamba 1.4B 每秒最多生成 1,814 个词元(批量 128),同样大小的 Transformer 1.3B 最多 364 个(批量 32,再大就内存不够)。批量为 1 时是 140 对 79,快 1.8 倍。论文写作 4 到 5 倍:没有 KV 缓存,可以用大得多的批量。
质量:Mamba 和 Pythia 用同样的分词器、同样的 Pile 数据,各训练 3,000 亿个词元。28 亿参数时,六项零样本测试平均 63.3 对 59.1,Pile 上的困惑度 6.22 对 6.73。
论文也写明了界限:它评估的模型都不大,训练过的最大是 28 亿参数;到更大的规模 Mamba 是否仍然占优,还有待评估。
生成:每秒最多 1,814 对 364 个词元 · 批量 1:140 对 79 · 平均分 63.3 对 59.1(同样的数据)
Mamba-2:两种算法
2024 年的 Mamba-2(Dao 和 Gu,ICML 2024)把 A 限定为一个数乘单位矩阵。这时一层对整段输入做的事,可以写成乘一个下三角矩阵:第 i 行第 j 列,是 C 在第 i 步、B 在第 j 步,乘上两步之间的全部衰减。论文把这叫作状态空间对偶。
同一个矩阵有两种算法。一行行递推,就是状态空间模型,工作量随长度线性增长;整块相乘,形如带掩码的注意力,C 像查询,B 像键,输入像值,没有 softmax,工作量是平方的。Mamba-2 把序列切成小块:块内用矩阵乘法,这是 GPU 的张量核心最擅长的;块与块之间只传递状态。
论文测得,这一层比 Mamba 的扫描快 2 到 8 倍,序列长于 2K 时比 FlashAttention-2 快,状态也可以大得多:发布的模型每个通道的状态有 128 个数,Mamba 是 16 个。论文也写明,这种对偶不包括带 softmax 的标准注意力。
一层 = 乘一个下三角矩阵 · 一行行递推,或分块相乘 · 状态大小 16 → 128
混合着用
固定大小的状态有代价。Jelassi 等人(ICML 2024)证明,状态的比特数不够时,复制一段随机的长串就会出错;在 Pile 上训练的模型查“电话簿”,电话簿有 70 条以上时,4.1 亿参数的 Pythia 胜过 28 亿参数的 Mamba。NVIDIA 2024 年用同样的数据训练了几个 8B 模型,纯 Mamba 和纯 Mamba-2 也在五样本 MMLU 和电话簿上落后。
于是有了混合模型:大部分层是 Mamba,少数是注意力。AI21 的 Jamba(2024)每 8 层有 1 层注意力,一共 520 亿参数,每个词元用 120 亿。论文的表 1:读 256K 个词元,KV 缓存 4 GB,Mixtral 32 GB,Llama-2 7B 128 GB。NVIDIA 的 Nemotron-H-8B 一共 52 层,其中 24 层是 Mamba-2,4 层是注意力。
Mamba-2 论文自己的实验也一样:2.7B 的模型 64 层里有 6 层换成注意力,Pile 上的困惑度从 6.09 降到 5.95。论文的猜想是,注意力层负责直接查回前面的词元,不必把一切都压进状态。
Jamba:1 层注意力配 7 层 Mamba · 读 256K 个词元的 KV 缓存:4 GB 对 Mixtral 32 GB
它没有说的
状态大小固定,不等于能记住无限长的文字。它只留下更新规则选中的东西,而且是压缩过的;读过去的词元,不能回头再看。论文的语言模型是在 2,048 个词元长的序列上训练的;100 万个词元的结果,来自两层的人造任务和 DNA、音频。
线性时间也不等于处处更快。读提示时,两种模型都是整段一起算;省下的是生成时每个词元的工作和内存。在批量为 1 时,Mamba 1.4B 比 Transformer 1.3B 快 1.8 倍,不是 5 倍。
选择性也不是处处都好。论文写道,它补上了时不变模型在文字、DNA 这类离散数据上的短处,却可能拖累它们擅长的连续信号,比如音频。
状态固定,也有损失 · 读过去不能回头 · 省下的是生成时的每一步
拆开来看
机器拆成几件:纸带和两个卷盘,读头,128 根杆和杆下的弹簧,框架,右边的 Δ 阀门,前面的 B 梳和后面的 C 梳,左边的输出;最后面是注意力要存的架子。
读头读一个词元,算出 Δ、B、C;阀门、两把梳子和杆跟着动一次,就是一步。
纸带 · 读头 · Δ 阀门 · B 梳 · 杆 · 弹簧 A · 框架 · C 梳 · 输出 y · 键和值的架子
实验台
纸带上先是几个普通的字,然后是要记住的“月”,接着是一串点,最后一个问号要把它读出来。拉杆选中间隔多少个点;另一个选项是规则:选择性(Δ、B、C 由词元决定),或固定(每个词元同样的 Δ、B、C)。每按一次“运行”都从头开始。
读数:状态里“月”还剩多少(和它刚写进去时比),读了几个词元,注意力这时要存几对键和值。状态始终是 128 个数。
这是本页的模型:Δ、B、C 是按论文对它们的解释手设的,不是训练出来的;固定规则的 Δ 是 0.15。Δ 再小一些,“月”能留得久一点,可每个词元都只写进去一点点,前面的字也一样留着:固定的规则没法对不同的词元区别对待。
读数:“月”还剩多少 · 读了几个 · KV 缓存几对 · 状态 128 个数
试一试中间隔 64 个点时,选择性的规则还留下多少“月”?换成固定的规则呢?这时注意力要存几对键和值,状态又是多少个数?
模型省略了什么
台上的机器是一个模型,不是芯片的样子。状态画成 8 行、16 列:16 是 Mamba 默认的状态大小,真实的 Mamba-2.8B 每层 5,120 个通道、一共 64 层,Mamba-2 的发布模型每个通道 128 个数。规则是论文的:h ← exp(Δ·A)·h + Δ·B·x,y = C·h,B̄ 按官方代码的简化写成 Δ·B;A 用 Mamba 的初始值 −1 到 −16。Δ、B、C 由本页从每个词元算出(伪随机),不是训练出来的。真实的 Mamba 块在这一层前后还有投影、短卷积和门,这里都省略了。纸带上一个字或一个词算一个词元,真实的分词切法不同。架子上的针只表示注意力每读一个词元存一对键和值,不按比例:在 Pythia-2.8B 里一对是 327,680 字节。每一步放慢到一秒左右。MB 按 10⁶ 字节算;Jamba 论文的 GB 按 2³⁰ 字节。
几个容易误会的地方
“5 倍”是生成的吞吐量,两种模型各取最好的批量,Transformer 用的是 Hugging Face 的标准实现;批量为 1 时是 1.8 倍。“20 到 40 倍”是扫描这一个运算和没有融合内核的 PyTorch 实现比,不是和 Transformer 比。“和大一倍的 Transformer 相当”,指的是和 Pythia-6.9B、GPT-J、OPT-6.7B 这些训练数据约 3,000 亿个词元的开源模型相当。100 万个词元的结果来自两层、16 个词的人造任务;注意力模型在 16,384 个词元以上是没有测,不是测了失败。Mamba 论文发表在 COLM 2024。Mamba-2 的对偶说的是一类没有 softmax、带衰减掩码的注意力,不是说它和 Transformer 一样。混合模型里注意力占多少,看怎么数:约占全部层的 7 % 到 12.5 %。
常见问题 · 5
- 状态空间模型和注意力有什么不同?
状态空间模型换了个办法:把读过的内容压进一个大小固定的状态,每读一个词元更新一次。
01能做到什么 ↑- Mamba-2.8B 的状态有多大?
Mamba-2.8B 的状态一段话一共 6,553,600 个数,16 位时 13.1 MB,读第 1 个词元和读第 100 万个词元时一样大。
03固定大小的状态 ↑- Mamba 的“选择性”指什么?
Mamba 的改动在于:Δ、B、C 不再是固定的参数,而是从当前的词元算出来,各是一个小的线性投影。
06由词元决定 ↑- Mamba 里的 Δ 起什么作用?
论文这样解释 Δ:Δ 大,状态被重置,注意力放在当前的输入上;Δ 小,状态保持,当前的输入被忽略。
06由词元决定 ↑- Jamba 怎样搭配注意力和 Mamba?
AI21 的 Jamba(2024)每 8 层有 1 层注意力,一共 520 亿参数,每个词元用 120 亿。
10混合着用 ↑
资料来源
- Gu、Dao(2023):Mamba: Linear-Time Sequence Modeling with Selective State Spaces(arXiv 版)
- 同一篇论文,COLM 2024(OpenReview)
- Gu、Goel、Ré(2022):Efficiently Modeling Long Sequences with Structured State Spaces,ICLR 2022
- Mamba 的官方代码:mamba_ssm/modules/mamba_simple.py
- state-spaces/mamba-2.8b 的模型配置(Hugging Face)
- EleutherAI/pythia-2.8b 的模型配置(Hugging Face)
- Biderman 等(2023):Pythia: A Suite for Analyzing Large Language Models Across Training and Scaling
- Dao、Gu(2024):Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality,ICML 2024
- state-spaces/mamba2-2.7b 的模型配置(Hugging Face)
- Jelassi、Brandfonbrener、Kakade、Malach(2024):Repeat After Me: Transformers are Better than State Space Models at Copying,ICML 2024
- Waleffe 等(2024):An Empirical Study of Mamba-based Language Models(NVIDIA)
- Lieber 等(2024):Jamba: A Hybrid Transformer-Mamba Language Model(AI21)
- ai21labs/Jamba-v0.1 的模型配置(Hugging Face)
- NVIDIA(2025):Nemotron-H: A Family of Accurate and Efficient Hybrid Mamba-Transformer Models
- nvidia/Nemotron-H-8B-Base-8K 的模型配置(Hugging Face)
数据
The machine is a model of one selective state-space layer as Gu and Dao describe it in “Mamba: Linear-Time Sequence Modeling with Selective State Spaces” (COLM 2024): a state of 8 channels × 16 numbers (16 is Mamba’s default state size), A = −1 … −16 (Mamba’s initialisation), h ← exp(ΔA)·h + Δ·B·x and y = C·h. The values of Δ, B and C on the tape are made by the page from each token, not learned; every count the page shows from the machine comes from its own arithmetic, not from measurements. The text on the tape: four Tang quatrains (Chinese page) and the openings of public-domain books by Lewis Carroll, Charles Darwin, Mary Shelley and Henry David Thoreau (English page), one character or one word to a token. Material presets, parts and the softbox studio of the site’s model kit are ported from AirsupHQ/machine-skill (MIT, © 2026 Air Supply Technologies Inc.).
本页的文字、图片和模型采用 CC BY-NC 4.0 许可:可以免费用于教学和其他非商业用途,可以修改,请注明出自 world.lapla.si。上面列出的第三方素材仍按各自的许可。
引用这幅图版
拉普拉斯的迷你世界,图版 F56《Mamba 与状态空间模型》,https://world.lapla.si/zh/mamba/,CC BY-NC 4.0,2026-10-28 更新。
沿这个问题继续
 图版 F55KV 缓存与分页注意力语言模型一次写一个词元,每写一个都要用到前面每个词元的键和值;把它们存着不重算,就是 KV 缓存。它随每个词元、每个请求变大。早先的系统按一段话可能的最大长度先占好一整块连续的显存,大半空着。分页注意力(vLLM)把缓存分成一样大的块,像操作系统的内存页:用块表记下每段话的块放在哪里,写满一块再拿一块,几段话还能共用相同的块。
 图版 F13Transformer 的注意力一个两层、八个头的小 Transformer,在你的浏览器里逐字读一句话,猜下一个字母。每条丝线是一次“注意”,亮度就是它的权重。
 图版 F51FlashAttention 与显存按标准做法,Transformer 的注意力在 GPU 上慢,多半不是因为算得多,而是要把一张 N × N 的分数矩阵写进显存再读回来。FlashAttention 把计算切成小块,放在芯片上的共享内存里算完,用边走边算的 softmax 得到同一个结果,这张矩阵从不进显存。
 图版 F26词元与缩放定律大语言模型读的是词元,不是字。模型越大、读的词元越多,误差按一条幂律下降。台上是在浏览器里运行的字节对编码,和一组真实训练过的小模型。