AlphaEvolve 与矩阵乘法
能一层层套用的做法里,4 × 4 矩阵相乘一直要 49 次乘法;2025 年,一个改程序、自动打分的循环,找到了 48 次(复数系数)。
向下滚动
49 变成 48
两个 4 × 4 的矩阵相乘,照定义要做 64 次乘法。1969 年起,能一层层套用到更大矩阵上的做法,在实数和复数上最少用 49 次。2025 年 5 月,Google DeepMind 公布:AlphaEvolve 找到了一种 48 次的做法,系数是复数。
这些系数都是精确的,每一项都能核对。台上前排的七块、后排的八块、立方体和这块纪录牌,讲的是这一次乘法从哪里省出来,又是怎样被找到的。
4 × 4 · 1969 年起 49 次 · 2025 年 48 次,复数系数
八次乘法
先看 2 × 2。结果 C 的每个元素,是 A 的一行和 B 的一列对应相乘再相加:C₁₁ = A₁₁B₁₁ + A₁₂B₂₁。四个元素,每个两次乘法,一共 8 次乘法、4 次加法。
后排的八块,就是这八次乘法,一块一次。n × n 的矩阵照这个办法要做 n³ 次乘法:4 × 4 是 64 次,1000 × 1000 是十亿次。
2 × 2 照定义:8 次乘法 · 4 次加法 · n × n:n³ 次乘法
七次就够
1969 年,Strassen 发表了一种只用 7 次乘法的做法。先算七个乘积,比如 M₁ = (A₁₁ + A₂₂)(B₁₁ + B₂₂):每个乘积的两边,各是 A 和 B 的元素相加或相减;再把这七个乘积加加减减,拼出 C 的四个元素。
代价是加减法变多了:从 4 次变成 18 次。前排的七块,就是这七个乘积。1971 年已经证明:不用乘法交换律的做法里,2 × 2 至少要 7 次乘法。
7 次乘法 · 18 次加减法 · 2 × 2 至少要 7 次(1971 年证明)
一块立方体
还可以换一种写法。把 A 的四个元素排在一条边上,B 的四个排在另一条边上,C 的四个排在竖直方向:一共 4 × 4 × 4 = 64 格。如果 A 的某个元素乘 B 的某个元素要加进 C 的某个元素,那一格就是 1,其余都是 0。
2 × 2 相乘,正好有 8 格是 1,就是那 8 次乘法。把立方体按 C 切成四层:最下面一层是 C₁₁,亮着的两格就是 A₁₁B₁₁ 和 A₁₂B₂₁。
4 × 4 × 4 = 64 格 · 8 格是 1 · 每一层是 C 的一个元素
一次乘法,一块
每一次乘法,在立方体里对应一块:A 的哪些元素相加、B 的哪些元素相加、结果加进 C 的哪些元素,三组系数相乘,填出一块带正负号的格子。一种做法,就是几块加起来正好等于这块立方体;块数就是乘法的次数。
Strassen 的七块一共占 32 格,有正有负。把它们放进立方体,12 格里一正一负互相抵消,剩下的正好是那 8 格。找更少的乘法,就是找更少的块。
七块 · 32 格 · 12 格正负抵消 · 剩下 8 格
一层一层省下来
省下一次乘法为什么要紧?Strassen 的做法从不调换乘法的前后次序,所以元素也可以是矩阵块。4 × 4 的矩阵可以看成 2 × 2 个 2 × 2 的块:外面一层做 7 次块乘法,每次块乘法里面再做 7 次,一共 7 × 7 = 49 次。
写成立方体也是这样:4 × 4 相乘是 16 × 16 × 16 格。按块给元素排好次序,64 个 1 正好分成 8 组,每组 8 格,组里和组与组之间都是 2 × 2 的那个图样。后面的水晶块里刻的就是它。
矩阵越大,层数越多,省得越多:n = 2ᵏ 时照定义要 8ᵏ 次,Strassen 要 7ᵏ 次,大约是 n 的 2.81 次方。1024 × 1024 时,前者约 10.7 亿次,后者约 2.8 亿次,少了约四分之三。
如果元素是可以调换次序的数,Winograd 1968 年的办法算 4 × 4 只要 48 次乘法;但它要调换次序,元素换成矩阵块就不对了,不能这样一层层套用。49 是能套用的做法里的纪录。
n = 2ᵏ:照定义 8ᵏ = n³ · Strassen 7ᵏ ≈ n^2.81 · 1024 × 1024:约 10.7 亿次对约 2.8 亿次
47,换了一种算术
2022 年,DeepMind 的 AlphaTensor 把拆立方体写成一个单人游戏,用强化学习去玩。它为 4 × 4 找到了 47 块的拆法,但只在模 2 的算术里成立:那里只有 0 和 1,1 + 1 = 0。
换回普通的数,这种拆法不成立。在实数和复数上,4 × 4 能套用的做法,仍是 Strassen 两层的 49 次。
AlphaTensor,2022 · 4 × 4:模 2 算术 47 次 · 普通算术仍是 49 次
改程序,再打分
AlphaEvolve 不直接拆立方体,它改的是一个程序。人先写好一个能运行的初始程序和打分的函数;一个程序库存着试过的程序和它们的分数。每一轮,从库里挑出程序写进提示,Gemini 2.0 Flash 和 2.0 Pro 两个语言模型提出改动,写成一段段“找到这几行,换成那几行”。
改好的程序交给评估程序,真的运行,按打分函数给分。分数好的存回库里,下一轮再改。台上的动画只是示意:三个候选依次放进立方体,红格是加起来不对的地方,纪录牌上 2 × 2 那一栏跟着这一轮最好的分数,从 8 变成 7。
对矩阵乘法,被改的是一个用梯度下降找拆法的程序:怎样初始化、损失怎样算、用什么优化器。评估时用不同的随机种子运行它,看它在一组尺寸上最少用几块;系数都取整到整数或半整数,保证拆法精确。搜索的是程序,不是一步棋;下棋的那种搜索,见“AlphaGo:搜索加上直觉”这一页。
程序库 → 提示 → 语言模型提出改动 → 运行、打分 → 好的存回库里
48 块
4 × 4 相乘的立方体有 16 × 16 × 16 = 4096 格,其中 64 格是 1,就是水晶块里的那 64 格。AlphaEvolve 找到的拆法有 48 块,系数只取 0、±½、±½i、±½ ± ½i 这九个值。
系数是公开的。我们用精确的算术把 48 块逐格加了一遍,4096 格都和立方体相同。系数里有 i,所以这些乘法要按复数来算。
论文说它是第一个找到这种做法的方法;不过 2024 年已有人用数值方法报告过一个复数系数的 48 次做法。2025 年 6 月,又有人把 AlphaEvolve 的这一个换成了只用有理数的 48 次做法,只要能除以 2 就能用。48 是不是最少,还没有人知道。
4 × 4:4096 格,64 格是 1 · 48 块 · 系数 0、±½、±½i、±½ ± ½i · 逐格核对相同
要有分数可打
这个循环能转,靠的是每个候选都能由程序自动打分:拆法对不对、用了几块,一算就知道。论文自己说,它的主要局限,就是只能处理写得出自动评估的问题。
同一套方法也用在了别处:Google 数据中心的一个调度规则,平均找回了约 0.7% 本来会闲置的算力;训练 Gemini 用的一个矩阵乘法内核,换了分块的规则,平均快了 23%,整个训练时间少了约 1%。这些都是别的程序,和 48 无关。
乘法少,也不等于实际更快。两层 Strassen 算 4 × 4,乘法 49 次,加减法却有 198 次,照定义只要 48 次加法;还要搬更多数据,舍入误差的界也更松。论文和发布文章都没有说 48 让哪个实际程序变快。专门做矩阵乘法的硬件,见“TPU 与脉动阵列”这一页。
只用于能自动打分的问题 · 4 × 4 两层 Strassen:49 次乘法、198 次加减法 · 照定义:64 次乘法、48 次加法
拆开来看
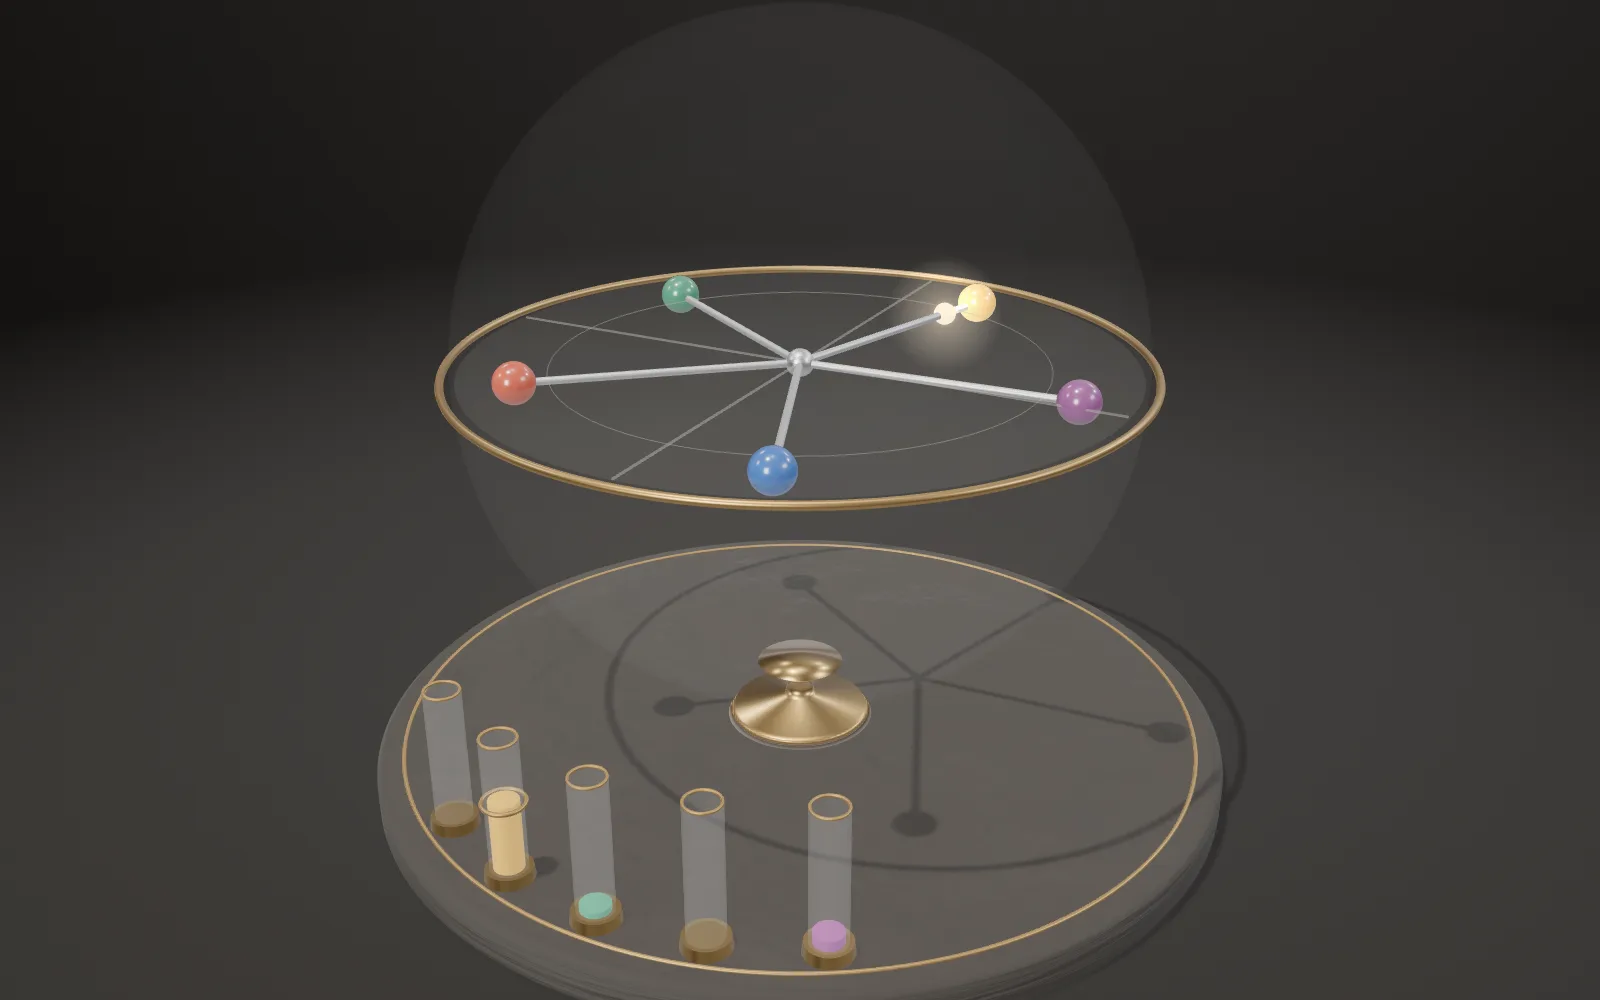
台上:2 × 2 乘法的立方体站在石阶上的黄铜底板上;前排石座上是 Strassen 的七块,后排高一级的是照定义的八块,两排间距相同,后排多出一格;右后方是纪录牌,立方体和纪录牌之间升起 4 × 4 乘法的水晶块。
乘法立方体 · 七块 · 八块 · 水晶块 · 纪录牌
实验台
两个 2 × 2 的矩阵,两种做法各算一遍:照定义 8 次乘法,Strassen 7 次,结果一样。“换一组数”会随机换两个矩阵,七块依次放进立方体,读数显示正在算的那个乘积。
再选一个矩阵大小,看要做多少次乘法:照定义 n³ 次;每层都用 Strassen,7ᵏ 次;4 × 4 的块用 48 次、和 7 次一起套用。这些次数只数乘法,由本页按公式算出,不是运行时间,也不一定是现在最好的纪录。
只数乘法 · 由本页按公式计算 · 不是运行时间
试一试在实验台上把矩阵大小调到 1024:照定义要多少次乘法?Strassen 每层都用要多少次?少了几成?
模型省略了什么
台上的立方体、小块、纪录牌和水晶块是本页对这些算术的模型,不是哪个实验室里的东西。立方体按 A 沿左右、B 沿前后、C 沿上下摆放;小块里的格子按同样的方向。水晶块里只刻了 64 格是 1 的位置,没有画出 48 块拆法。“改程序、打分”那一章的动画只是示意:真实的 AlphaEvolve 在许多台机器上同时运行评估,没有人一块一块往立方体里放;动画里的三个候选(一个错的、照定义的八块、Strassen 的七块)是为了说明打分,不是它的运行记录。
几个容易误会的地方
AlphaEvolve 不是自己想出数学:人写初始程序和打分函数,语言模型提出程序的改动,评估程序运行并打分,留下哪个由分数决定。“1969 年以来 49 次”只指不调换乘法次序、能一层层套用、在实数或复数上的做法:可以调换次序时,Winograd 1968 年的办法 4 × 4 只要 48 次;在模 2 的算术里,2022 年已有 47 次。2024 年已有人用数值方法报告过复数系数的 48 次做法;AlphaEvolve 的系数是精确的,2025 年 6 月起也有了只用有理数的 48 次做法。这些次数都只数乘法,乘法少不一定更快。2 × 2 的 7 次已证明是最少,4 × 4 最少要几次还不知道。
常见问题 · 5
- AlphaEvolve 在矩阵乘法上找到了什么?
1969 年起,能一层层套用到更大矩阵上的做法,在实数和复数上最少用 49 次。2025 年 5 月,Google DeepMind 公布:AlphaEvolve 找到了一种 48 次的做法,系数是复数。
0149 变成 48 ↑- Strassen 算法怎样只用 7 次乘法?
先算七个乘积,比如 M₁ = (A₁₁ + A₂₂)(B₁₁ + B₂₂):每个乘积的两边,各是 A 和 B 的元素相加或相减;再把这七个乘积加加减减,拼出 C 的四个元素。
03七次就够 ↑- 少一次乘法为什么重要?
Strassen 的做法从不调换乘法的前后次序,所以元素也可以是矩阵块。4 × 4 的矩阵可以看成 2 × 2 个 2 × 2 的块:外面一层做 7 次块乘法,每次块乘法里面再做 7 次,一共 7 × 7 = 49 次。
06一层一层省下来 ↑- AlphaEvolve 是怎样工作的?
AlphaEvolve 不直接拆立方体,它改的是一个程序。人先写好一个能运行的初始程序和打分的函数;一个程序库存着试过的程序和它们的分数。
08改程序,再打分 ↑- AlphaEvolve 能用在什么问题上?
这个循环能转,靠的是每个候选都能由程序自动打分:拆法对不对、用了几块,一算就知道。论文自己说,它的主要局限,就是只能处理写得出自动评估的问题。
10要有分数可打 ↑
资料来源
- A. Novikov 等(2025):AlphaEvolve: A coding agent for scientific and algorithmic discovery,arXiv:2506.13131(循环的四个部分;4 × 4 复数矩阵 48 次乘法;只能处理写得出自动评估的问题)
- Google DeepMind(2025 年 5 月 14 日):AlphaEvolve 的发布文章(0.7% 的算力、23% 的内核)
- google-deepmind/alphaevolve_results(48 块分解的系数和核对程序)
- V. Strassen(1969):Gaussian elimination is not optimal,Numerische Mathematik 13,354–356(七个乘积,7 次乘法、18 次加减法)
- J. E. Hopcroft、L. R. Kerr(1971):SIAM J. Appl. Math. 20,30–36(不用交换律时 2 × 2 至少要 7 次)
- M. Bläser(2013):Fast Matrix Multiplication,Theory of Computing Graduate Surveys 5(综述;2 × 2 的秩是 7,Strassen 能用于不可交换的元素)
- R. P. Brent(1970):Algorithms for matrix multiplication,Stanford STAN-CS-70-157(Winograd 的内积办法:(mp + m + p)n/2 次乘法,要求可交换)
- A. Fawzi 等(2022):Discovering faster matrix multiplication algorithms with reinforcement learning,Nature 610,47–53(乘法写成三维张量;模 2 算术里 4 × 4 用 47 次)
- I. E. Kaporin(2024):Comput. Math. Math. Phys. 64,1881–1891(数值方法求得的复数系数 4 × 4 的 48 次做法)
- J.-G. Dumas、C. Pernet、A. Sedoglavic(2025):arXiv:2506.13242(只用有理数的 48 次做法,能除以 2 的环里都成立)
- A. Sedoglavic:Fast matrix multiplication algorithms catalogue(各尺寸最好已知的乘法次数,2026 年 10 月)
- J. Huang、T. M. Smith、G. M. Henry、R. A. van de Geijn(2016):arXiv:1605.01078(把乘法换成加法,代价是更多的数据搬运、内存和稍弱的数值稳定性)
- Y. Moran、O. Schwartz、S. Yuan(2026):arXiv:2602.13171(快速矩阵乘法在实际中常常更慢;复数系数增加开销)
数据
AlphaEvolve and its results after A. Novikov, N. Vũ, M. Eisenberger, E. Dupont, P.-S. Huang, A. Z. Wagner, S. Shirobokov, B. Kozlovskii, F. J. R. Ruiz, A. Mehrabian, M. P. Kumar, A. See, S. Chaudhuri, G. Holland, A. Davies, S. Nowozin, P. Kohli and M. Balog, “AlphaEvolve: A coding agent for scientific and algorithmic discovery” (Google DeepMind, 2025; arXiv:2506.13131), and Google DeepMind’s announcement of 14 May 2025. The rank-48 decomposition of the 4 × 4 product is the one published in google-deepmind/alphaevolve_results (CC BY 4.0); this page checks it with exact arithmetic (docs/plates/alphaevolve/computed.py). Strassen’s seven products after V. Strassen, “Gaussian elimination is not optimal” (Numerische Mathematik 13, 1969); 7 as the fewest after J. E. Hopcroft and L. R. Kerr (SIAM J. Appl. Math. 20, 1971) and M. Bläser’s survey (Theory of Computing, 2013); Winograd’s commutative method after R. P. Brent (Stanford, 1970); the tensor view and the 47 in arithmetic mod 2 after A. Fawzi et al. (Nature 610, 2022); the earlier complex 48 after I. E. Kaporin (Comput. Math. Math. Phys. 64, 2024); the rational 48 after J.-G. Dumas, C. Pernet and A. Sedoglavic (arXiv:2506.13242); best-known counts after A. Sedoglavic’s fast matrix multiplication catalogue; costs in practice after J. Huang et al. (arXiv:1605.01078) and Y. Moran, O. Schwartz and S. Yuan (arXiv:2602.13171). The cube, the blocks, the record plate and the crystal are this page’s model of the arithmetic, not objects from any laboratory. Material presets and the model kit as on the site’s other model plates (public/looks/CREDITS.md).
本页的文字、图片和模型采用 CC BY-NC 4.0 许可:可以免费用于教学和其他非商业用途,可以修改,请注明出自 world.lapla.si。上面列出的第三方素材仍按各自的许可。
引用这幅图版
拉普拉斯的迷你世界,图版 F62《AlphaEvolve 与矩阵乘法》,https://world.lapla.si/zh/alphaevolve/,CC BY-NC 4.0,2026-11-04 更新。
沿这个问题继续
 图版 F20AlphaGo:搜索加上直觉一张榧木棋盘,摆着 2016 年李世石对 AlphaGo 第二局第 37 手之后的局面;旁边一台 7×7 的研究盘,真实的树搜索在上面长成一棵黄铜的树。
 图版 F53TPU 与脉动阵列Google 的 TPU 把神经网络里最费时的矩阵乘法交给一块脉动阵列:权重先装进格子里不动,输入从左边一拍一拍流过来,部分和往下传。一个数从缓冲区读出一次,就在阵列里用上很多次。