AlphaGo:搜索加上直觉
2016 年 3 月,首尔。程序 AlphaGo 和九段棋手李世石下了五局,赢了四局。围棋的变化多到算不完,此前最强的程序只有业余高手的水平。AlphaGo 把两样东西接在一起:神经网络判断哪里值得下、谁占上风,树搜索只沿着这些地方往深处算。台上的棋盘摆着第二局第 37 手之后的局面;右边的研究盘上,一个小得多的同类搜索正在真实地运行。
向下滚动
为什么难
棋盘有 19 × 19 = 361 个交叉点。一盘棋大约下 150 手,每一手平均有大约 250 种下法。照这样往下数,可能的棋局约有 250¹⁵⁰ 种。
合法的局面也被数过:约 2.08 × 10¹⁷⁰ 个。逐一算过去,什么计算机都做不到。
国际象棋程序的办法是:手写一个给局面打分的公式,再往下搜很多步。1997 年,深蓝这样赢了卡斯帕罗夫。围棋没有这样的公式:一块棋是死是活、外势值多少,很难写成规则。2006 年起,程序改用随机把棋下完来估计局面,进步很快,但到 2015 年仍只有业余高手的水平。
361 个交叉点 · 每手约 250 种下法 · 一盘约 150 手 · 合法局面约 2.08 × 10¹⁷⁰
两个网络
策略网络回答:高手会下在哪里?AlphaGo 的策略网络有 13 层,从网上棋局里学了 3,000 万个局面,猜中人类下一手的比例是 57%,此前最好的是 44%。
价值网络回答:现在谁会赢?它看一眼局面,只给出一个数:轮到的一方获胜的可能有多大。
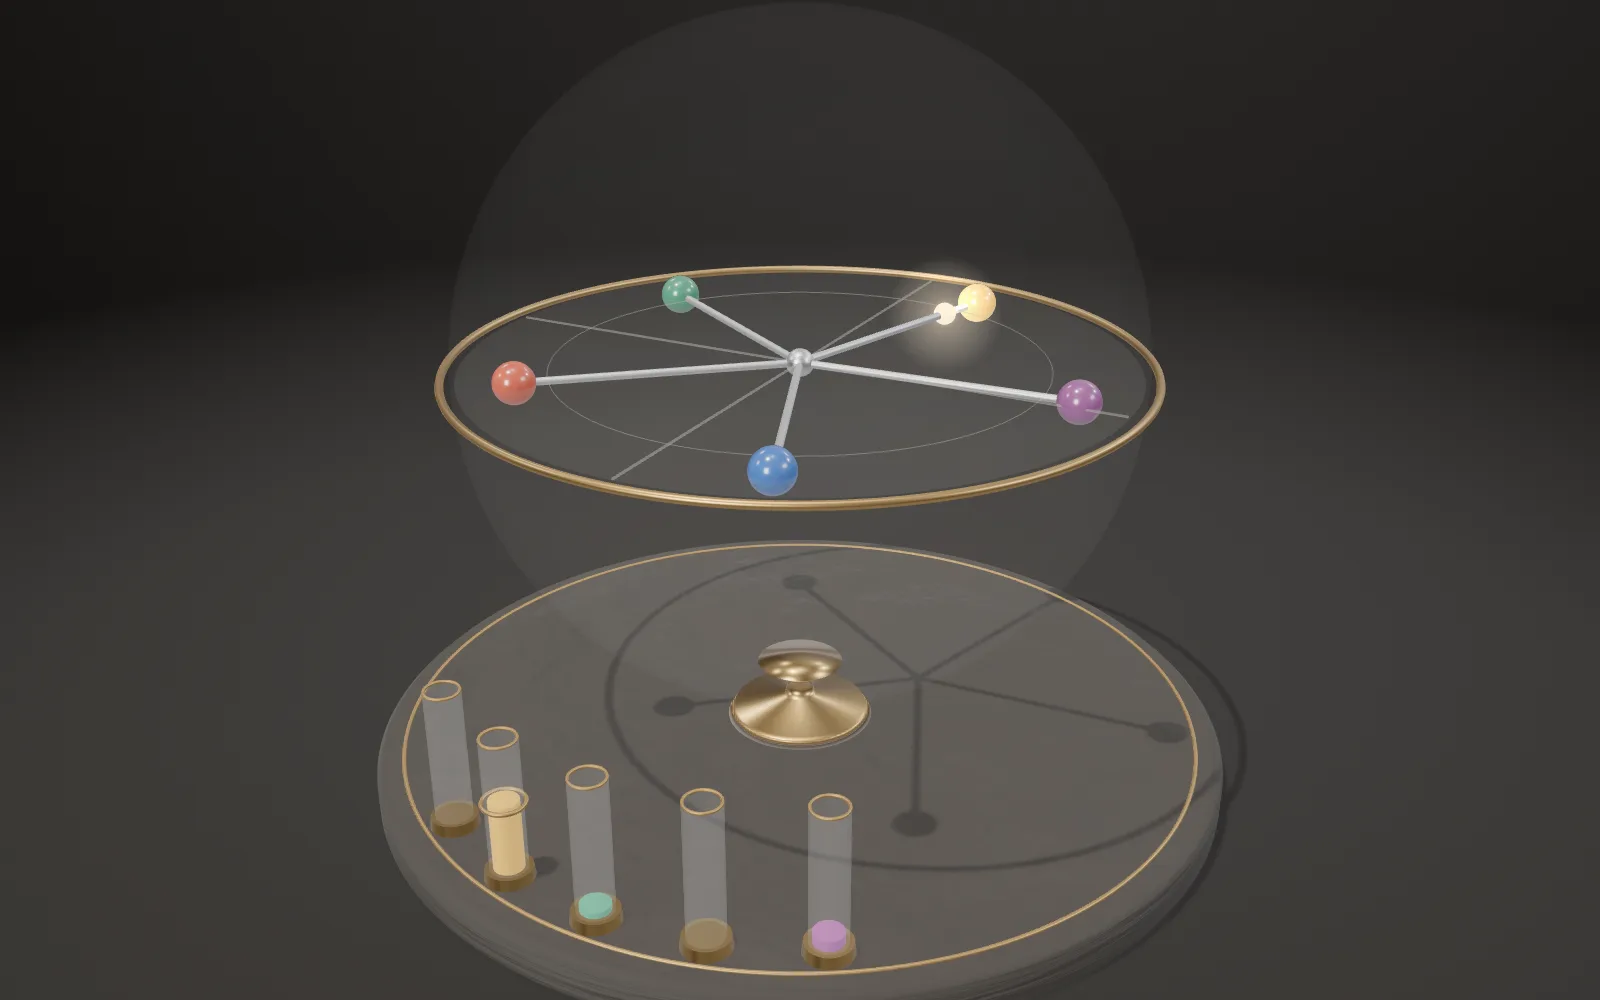
研究盘上是同样的两样东西,来自本页在 7 × 7 棋盘上训练的一个小网络:交叉点上的铜针越高,网络越倾向于下在那里;表盘读的是黑方的胜率。
研究盘:小网络的先验(铜针)与价值(表盘),本页计算
一棵搜索树
网络会看走眼,所以 AlphaGo 还要算。它做的是蒙特卡洛树搜索:一次又一次地从当前局面出发,沿着树往下走,走到尽头就添上一个新局面,估计它的好坏,再把结果沿路送回去。
往下走时,每个分叉挑一手:它到目前为止的平均结果 Q,加上一个奖励 U。U 在网络先验高、又还没怎么算过的手上更大,算得越多,U 越小。
研究盘上的黄铜树是本页这台搜索真实长出来的。每根枝是一手棋,从下这一手的交叉点长出;枝越粗,搜索经过它越多。这个局面里,网络最看好 E5(43%),A5 只排第四(8%)。头 18 次模拟访问最多的是 E5,接着是 E6,从第 85 次起是 A5。
Q + U,U = c · P · √ΣN ⁄ (1 + N) · 研究盘:一次模拟加一个新局面
选哪一手
搜索停下时,AlphaGo 下被访问最多的那一手。访问多,说明这一手被反复检验过,而且一直站得住。
分布式的 AlphaGo 用 1,202 个 CPU 和 176 个 GPU。可是和樊麾对局时,它评估过的局面比深蓝对卡斯帕罗夫时少几千倍:深蓝每秒平均搜约 1.26 亿个局面,AlphaGo 靠网络把搜索集中到了少数几手上。
研究盘上,800 次模拟之后,A5 占了 74% 的访问,网络最看好的 E5 占 19%。先验决定先看哪里,最后下哪一手由访问次数决定。
研究盘:800 次模拟后各点的访问次数 · A5 74% · E5 19%,本页计算
自己跟自己下
学人类只是起点。AlphaGo 让策略网络和它自己较早的版本下棋,赢棋的走法加强,输棋的走法减弱,这叫强化学习。练过之后,这个网络不用任何搜索,对原来的网络能赢八成以上。
价值网络也是从自我对弈里学的:3,000 万个局面,每个取自不同的一盘棋,免得它把整盘棋背下来。
研究盘的小网络也是这样来的:从随机的权重开始,用本页的规则和搜索自我对弈,每一代用新下的棋再训练一遍。60 代、12,000 盘之后,每手 128 次模拟时,它引导的搜索和随机走子的搜索下 60 局,赢 50 局;每手 512 次时赢 37 局。
研究盘的小网络:自我对弈的盘数与它对随机走子搜索的胜率,本页训练
第 37 手
2016 年 3 月 10 日,第二局。AlphaGo 执黑,第 37 手下在 P10:在白 36 头上肩冲,离右边第五路。按 AlphaGo 自己的数据,人类下出这一手的可能约为万分之一,它还是选了这一手。
AlphaGo 下了 211 手,李世石认输。
万分之一说的是“人会不会这样下”,不是“这一手好不好”。先验低的手,只要搜索证明它好,照样会被选中。
第二局 · 黑 37 · P10 · 人类下出的可能约 1 ⁄ 10,000(AlphaGo 的估计)
第 78 手
2016 年 3 月 13 日,第四局,李世石执白。第 78 手,他在中央 L11 挖进黑棋的缝隙。按 AlphaGo 的估计,人类下出这一手的可能同样约为万分之一。
AlphaGo 的第 79 手应错了。它的价值网络在第 79 手时仍估计自己有约七成胜算,到第 87 手前后才骤然跌落。李世石下到第 180 手,AlphaGo 认输。这是五局里人类唯一的胜局。
搜索只在它认为值得的地方算得深。先验很低的妙手,可能分不到足够的访问而被看漏。
第四局 · 白 78 · L11 · 第 79 手时价值约 70%,第 87 手前后骤降
从零开始
2017 年的 AlphaGo Zero 不看任何人类棋谱。它从随机落子开始,只靠自我对弈学习;只有一个网络,同时给出策略和价值;输入只有盘上的黑子和白子;搜索里不再随机把棋下完。
每一手的搜索结果都成了老师:策略学着接近搜索的访问比例 π,价值学着接近这盘棋最后的胜负 z。损失是 (z − v)² − πᵀ log p + c‖θ‖²。
自我对弈 3 天、490 万盘后,它以 100 比 0 赢了和李世石下棋的那个版本。
(z − v)² − πᵀ log p + c‖θ‖² · 3 天 · 490 万盘 · 100 : 0
AlphaZero 与 MuZero
2018 年的 AlphaZero 用同一个算法学会了国际象棋、将棋和围棋,换的只是规则。国际象棋里,它和 Stockfish 下 1,000 局,赢 155 局,输 6 局,其余和棋;它每秒只搜约 6 万个局面,Stockfish 搜约 6,000 万。
2020 年的 MuZero 连规则都不给。它自己学一个模型:从一个局面、一步动作,预测下一个内部状态、得到的回报、策略和价值,然后在学到的内部状态里做同样的树搜索。
它在围棋、国际象棋和将棋上达到 AlphaZero 的水平,在 57 款雅达利游戏上刷新了纪录。
AlphaZero(2018):国际象棋 · 将棋 · 围棋 · MuZero(2020):自己学会的模型
改变与未变
围棋没有被“解决”。没有人知道 19 路棋盘上双方都下得完美会是什么结果。被完全算清的只有小棋盘,例如 5 × 5。
比人强的程序也有盲点。2023 年,一个专门训练出来的对手找到了顶尖开源程序 KataGo 的漏洞,对超人水平设置下的 KataGo 胜率超过 97%。一位业余棋手学会这个打法后,对一个顶尖程序 15 局赢了 14 局。
人在变。一项研究用程序给 1950 到 2021 年的 580 万手职业着法打分:2016 年以后,人类的决策明显变好,新的下法也更多了。
19 路围棋未被解决 · 5 × 5 已被解出
实验台
研究盘上的搜索在后台真实地运行。滑杆是模拟的次数;“引导”选网络(AlphaGo Zero 的做法)或随机把棋下完(AlphaGo 之前的做法);还可以换一个局面。读数是每个点的访问次数和搜索对这一步的胜率估计。
试一试在实验台上把“引导”换成随机下完,同样 200 次模拟,访问次数还那么集中吗?
模型省略了什么
研究盘是 7 × 7,规则用数子法(盘上的子加上只挨着一方的空点)、贴 9 目,只判单劫。它的网络是一个两层的小感知机,在本页的规则下自我对弈训练(docs/plates/alphago/train.mjs),比 AlphaGo Zero 的 40 层残差网络小几千倍,水平也低得多。树上画出根上试过的每一手;模拟超过 300 次时,更深处只访问过一次的叶子省略不画,读数里的节点数照样算上它们。“随机下完”用的是不填自己眼的随机走子。大棋盘上的局面是真实棋谱,但大棋盘上没有任何网络或搜索的数:AlphaGo 当时的输出只公开了很少几个,例如第 37 手的万分之一。
几个常见的误解
AlphaGo 不是穷举:和樊麾对局时,它评估的局面比深蓝少几千倍,靠网络把搜索集中到少数几手上。围棋也没有被解决:没有人知道完美对局的结果,最强的程序仍有被人找到的漏洞。胜率是网络和搜索的估计,不是算清了的结果。第 37 手的“万分之一”是 AlphaGo 估计人类会下这一手的可能,不是这手棋的好坏。
常见问题 · 4
- 围棋为什么难?
棋盘有 19 × 19 = 361 个交叉点。一盘棋大约下 150 手,每一手平均有大约 250 种下法。
01为什么难 ↑- AlphaGo 怎样选一手棋?
搜索停下时,AlphaGo 下被访问最多的那一手。访问多,说明这一手被反复检验过,而且一直站得住。
04选哪一手 ↑- 第 37 手的“万分之一”是什么意思?
万分之一说的是“人会不会这样下”,不是“这一手好不好”。先验低的手,只要搜索证明它好,照样会被选中。
06第 37 手 ↑- 围棋被人工智能解决了吗?
围棋没有被“解决”。没有人知道 19 路棋盘上双方都下得完美会是什么结果。
10改变与未变 ↑
资料来源
- Silver 等(2016):Mastering the game of Go with deep neural networks and tree search,Nature 529:484–489
- Silver 等(2017):Mastering the game of Go without human knowledge,Nature 550:354–359
- Silver 等(2018):A general reinforcement learning algorithm that masters chess, shogi, and Go through self-play,Science 362:1140–1144
- Schrittwieser 等(2020):Mastering Atari, Go, chess and shogi by planning with a learned model,Nature 588:604–609
- Hassabis(2016-03-08,至 03-15 更新):AlphaGo’s ultimate challenge(赛程、规则、第四局的第 78 和 79 手)
- Hassabis(2016-03-16):What we learned in Seoul with AlphaGo(第 37 手、第 78 手的万分之一)
- NPR(2016-03-13):After 3 Losses, Master Go Player Scores A Win Against Computer(Hassabis 关于第 79、87 手价值网络的推文)
- 棋谱:AlphaGo 对李世石第二、四局(CWI 收藏,与 Go Game Guru 2016 年的棋谱逐手核对)
- Tromp:Number of legal Go positions
- van der Werf、van den Herik、Uiterwijk(2003):Solving Go on small boards,ICGA Journal 26(2)
- Wang 等(2023):Adversarial Policies Beat Superhuman Go AIs,ICML
- Shin、Kim、van Opheusden、Griffiths(2023):Superhuman artificial intelligence can improve human decision-making by increasing novelty,PNAS 120:e2214840120
- Coulom(2006):Efficient selectivity and backup operators in Monte-Carlo tree search
- Kocsis、Szepesvári(2006):Bandit based Monte-Carlo planning
- Auer、Cesa-Bianchi、Fischer(2002):Finite-time analysis of the multiarmed bandit problem
- Campbell、Hoane、Hsu(2002):Deep Blue,Artificial Intelligence 134:57–83
数据
The game records are AlphaGo vs Lee Sedol, games 2 and 4 (Seoul, March 2016), from Andries Brouwer’s collection at CWI, checked move for move against Go Game Guru’s records of 2016 and the diagrams in Wikipedia. The 7 × 7 study board, its rules, its search and its small network are the site’s own: src/topics/alphago/go.js, mcts.js and net.js, trained by self-play with docs/plates/alphago/train.mjs.
本页的文字、图片和模型采用 CC BY-NC 4.0 许可:可以免费用于教学和其他非商业用途,可以修改,请注明出自 world.lapla.si。上面列出的第三方素材仍按各自的许可。
引用这幅图版
拉普拉斯的迷你世界,图版 F20《AlphaGo:搜索加上直觉》,https://world.lapla.si/zh/alphago/,CC BY-NC 4.0,2026-10-18 更新。
沿这个问题继续
 图版 F19AlphaFold:从序列算出蛋白质的形状一条大麦蛋白的青铜丝带模型:84 个氨基酸,按 AlphaFold 的预测折好;旁边一块瓷板是它的距离图,里面可以套上晶体测出的真实结构。
 图版 F18神经网络怎样学习一块按真实误差铣出来的铝制地形,一颗按真实梯度往下走的钢球,一架玻璃和黄铜做的小网络:正向的光把数送到输出,反向的光把每根杆该拧多少送回来。
 图版 F13Transformer 的注意力一个两层、八个头的小 Transformer,在你的浏览器里逐字读一句话,猜下一个字母。每条丝线是一次“注意”,亮度就是它的权重。
 图版 46先背答案,再学会规律一个小神经网络学 24 小时制的钟点加法。练习题它很快全做对了,靠的是死记;过了很久,它才忽然答对从没见过的题。它的里面,长出了几只钟。