视觉语言动作模型
一张画面、一句话进去,一串手臂动作出来。
向下滚动
能做到什么
2023 年,Google DeepMind 的 RT-2 把一个读过网上图文的大模型改成了能开机器人的模型:输入是摄像头画面和一句指令,输出是手臂的动作。在没见过的物体、背景和环境里,它的平均成功率是 62 %,上一代 RT-1 是 32 %。
2024 年的 OpenVLA 有 70 亿参数,用 97 万段机器人示范训练,权重公开。同年 Physical Intelligence 的 π0 能叠衣服、收拾餐桌、搭纸盒,这些任务一做就是 5 到 20 分钟。2025 年的 π0.5 在训练时没去过的人家里收拾厨房和卧室;Google DeepMind 的 Gemini Robotics 经过专门训练,在六个灵巧任务(包括折纸狐狸)上平均成功 79 %;其中装饭盒要两分多钟,试了 20 次全部成功。
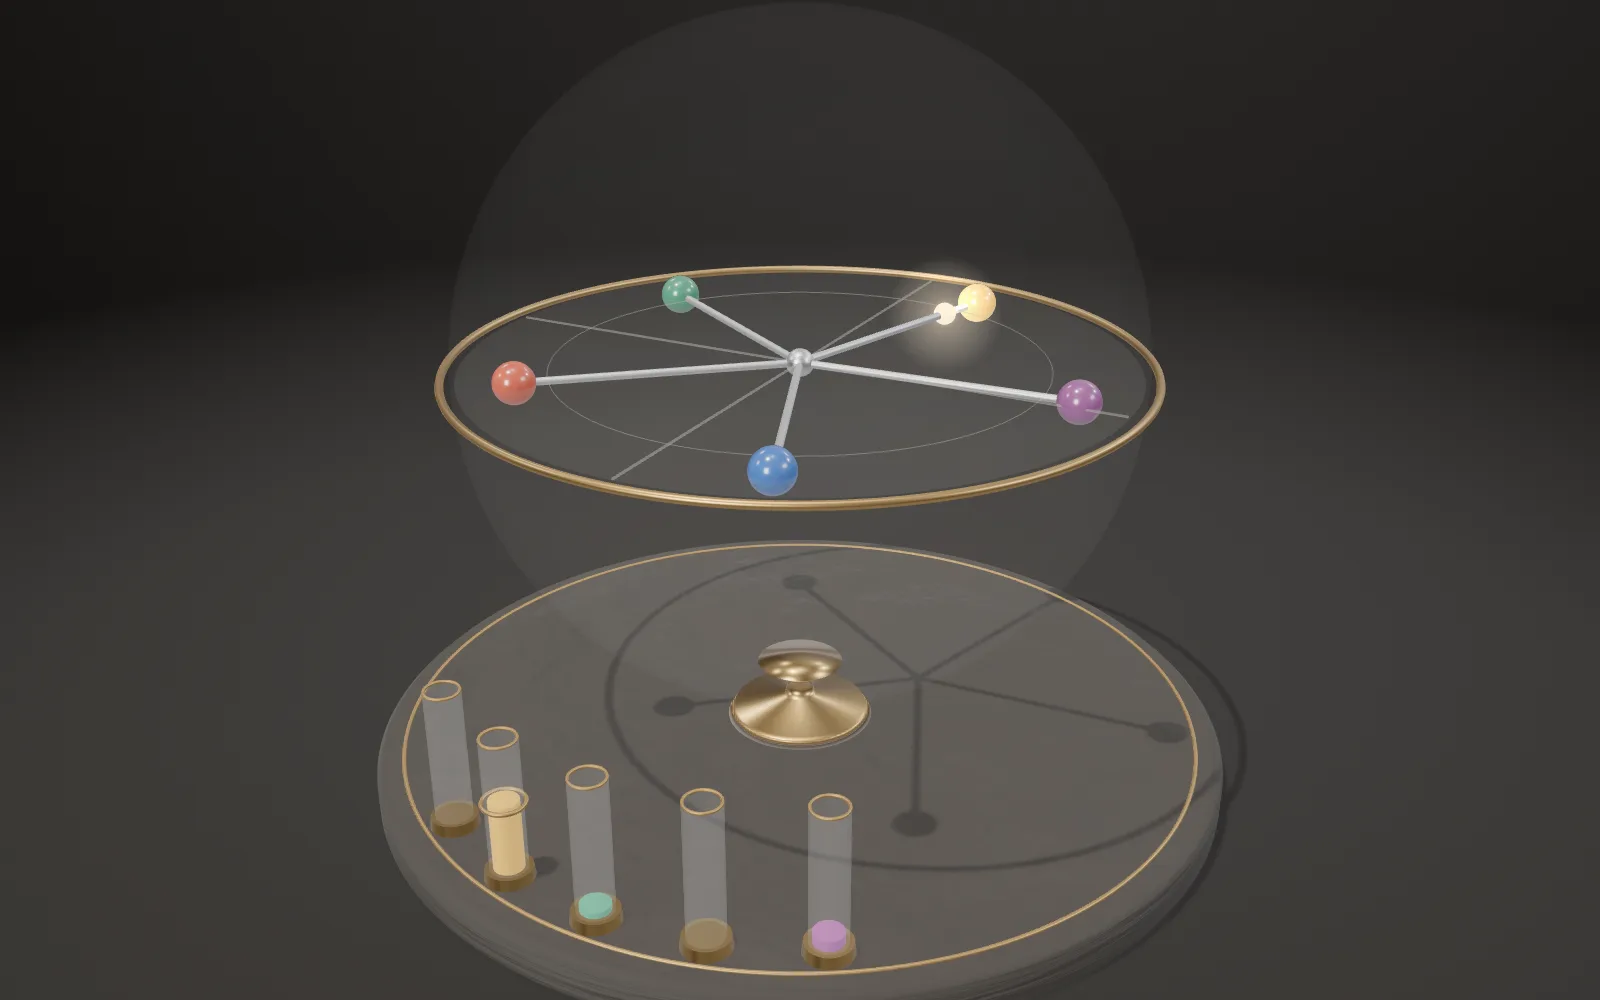
台上是一个机器人工作台的模型:一只五个关节的手臂,一台装在立柱上的深度相机,一个杯子、一块布、一块木块。右边的控制器代表模型本身:琥珀色的屏上是指令,斜面上的七把刻度尺是它刚写出的动作。手臂的路径是本页规划的,再按 RT-2 的格式写出来,不是训练出来的模型给的。
RT-2:没见过的场景 62 %(RT-1 32 %)· OpenVLA:70 亿参数,97 万段示范 · π0:叠衣服、收餐桌 · Gemini Robotics:装饭盒 20 / 20
从像素开始
模型先要看。摄像头的画面被切成许多小方块,每一块经过视觉编码器,变成一串数字,叫图像词元。OpenVLA 把每个小块同时送进 DINOv2 和 SigLIP 两个编码器,再把两边的结果拼在一起;两个编码器合起来约 6 亿参数。
画面并不大。OpenVLA 用 224 × 224 像素,试过 384 × 384,效果没有差别,训练却慢 3 倍。RT-1 一次看最近的 6 帧,每帧 300 × 300 像素;π0 每次看 2 到 3 个相机。
台上,立柱顶上的深度相机看着工作区;右上角是从它的位置看到的画面和切成的小方块(小方块的大小只是示意)。夹爪上还有一个小相机:π0.5 的手臂就在手腕上装着相机。
画面 → 小方块 → 视觉编码器 → 图像词元 · OpenVLA:224 × 224 像素,DINOv2 + SigLIP
指令也是词元
指令也切成词元,接在图像词元后面,一起送进一个大语言模型。这个模型原本是读网上的图文训练出来的:RT-2 用 PaLI-X 和 PaLM-E,OpenVLA 用 Llama 2,π0 用 PaliGemma。RT-2 提问的样子就像看图答题:“问:要[指令],机器人该做什么动作?答:”
为什么从这样的模型开始?网上的图文有几十亿条,机器人数据比不上:最大的机器人数据集也只有十万到一百万条示范。RT-2 把机器人数据和网上的图文混在一起接着训练;用 PaLI-X 时,机器人数据约占一半。同样 50 亿参数,只用机器人数据从头训练,在没见过的场景里成功率只有 9 %;混在一起训练是 44 %。
换来的是常识。RT-2 能做训练数据里没有的指令,比如“把苹果移到 3 上”“把东西移到二加一的和旁边”“把可乐罐移到戴眼镜的人那里”。但它学不会新的动作:能做的仍是机器人数据里出现过的动作,只是用到了新的地方。
图像词元 + 指令词元 → 语言模型 · RT-2,同样 50 亿参数:从头训练 9 %,混合训练 44 %
动作写成词元
动作怎样从语言模型里出来?RT-2 把动作也写成文字。一个动作有 7 个连续的量:手的末端在 x、y、z 上移动多少,绕三个轴转多少,夹爪张开多少。每个量的范围平均切成 256 格,写下它落在第几格;前面再加一个表示“结束”的词元,一个动作就是 8 个整数,比如“1 128 91 241 5 101 127 217”。
这 256 个数要占用词表里的 256 个词元。PaLI-X 本来每个 1,000 以内的整数都有自己的词元,直接拿来用;PaLM-E 和 OpenVLA 则把词表里最少用到的 256 个词元改成动作。OpenVLA 不取每个量的最小到最大,而是取训练数据里 1 % 到 99 % 的范围再切,免得几个极端的动作把格子撑宽。
台上斜面的 7 把尺子就是这 7 个量,每把 256 格。手臂每走一步,滑块就跳到这一步落在的格子上,纸带印出同样的 7 个数。一格是范围的 1/256,四舍五入的误差最多半格。这里每秒写 5 个动作;RT-2 的 550 亿参数版本每秒只写得出 1 到 3 个。
7 个量 × 256 格 + 结束 = 8 个词元 · 例:1 128 91 241 5 101 127 217
看一眼,动一步
机器人就这样一圈圈地工作:拍一张照,模型写出一个动作,手臂执行,再拍下一张。动作说的是手的末端该移动多少,底层的控制器再把它换算成各个关节的角度去跟随;π0.5 就是让简单的 PD 控制器跟随模型给出的目标位置。
这一圈要多快?RT-1 只有 3,500 万参数,每秒 3 步,留给模型的时间不到 100 毫秒。RT-2 的 550 亿参数版本放在云端的 TPU 上,通过网络调用,每秒 1 到 3 步;50 亿参数的版本约 5 步。OpenVLA 在一块 RTX 4090 上约每秒 6 步。
人做一个这样的动作要 2 到 4 秒,每秒 3 步还跟得上。叠衣服这样的灵巧动作就不够了:ALOHA 双臂平台每秒发 50 次指令。一项实验里,同一个遥操作任务,指令从每秒 50 次降到 5 次,人完成它的时间慢了 62 %。台上的手臂现在就是走一步、停下来等下一个动作。
拍照 → 模型 → 动作 → 关节 · RT-1:每秒 3 步 · RT-2 55B:1–3 步 · OpenVLA:约 6 步
一次说一串
办法是一次写出一串动作。2023 年的 ACT 每次预测接下来的 100 个动作,按每秒 50 个执行,也就是 2 秒;在它的实验里,一次只出 1 个动作时成功率 1 %,一次出 100 个时 44 %。一次写一串,任务就被分成更少的几段,小错误不容易一步步累积。
π0 每次写出 50 个动作,按每秒 50 个执行就是 1 秒。它在一块 RTX 4090 上算一次要 73 毫秒,这段时间手臂只走掉 3.65 个动作。实际上它每走 25 个、也就是每 0.5 秒,就看一眼新画面,再算一串。Gemini Robotics 的大模型在云端,从拍照到拿到一串动作约 250 毫秒;靠一次一串,手臂仍按每秒 50 个动作运行。
所以“50 赫兹”说的是动作的节奏,不是模型的。台上夹爪前面那串小珠子,就是模型刚写出的一串动作;手臂沿着它走,走到一半,新的一串接上来。
π0:一串 50 个动作,每秒 50 个 · 算一次 73 毫秒 · 每 0.5 秒重算 · Gemini Robotics:约 250 毫秒
从噪声里流出动作
一串连续的动作,若每个量的每一步都写成一个词元,词元就太多了:每秒 50 步、14 个量的动作,1 秒就是 700 个。相邻的词元又几乎一样,模型很容易学成“照抄上一个”。
π0 换了一种输出:在语言模型旁边加一个 3 亿参数的“动作专家”,用流匹配(扩散模型的一种)直接生成连续的动作。从一串随机噪声开始,模型每一步给出该往哪里推,推 10 步,噪声就变成一串平滑的动作;这 10 步在 RTX 4090 上共 27 毫秒。π0 一共 33 亿参数。
另一条路是先把动作压缩,再写成词元。FAST 先对每个量做离散余弦变换(JPEG 压缩图片用的也是它),再合并成更少的词元:同样那 1 秒的动作只要 53 个。用它训练省 5 倍的算力,但推理时要一个个写出来,一串约 750 毫秒,流匹配的 π0 不到 100 毫秒。
流匹配:噪声 → 10 步 → 50 个动作 · 动作专家 3 亿参数 · FAST:700 → 53 个词元
快慢两套
大模型懂得多,但慢;控制手臂要快。好几个系统把这两件事分开做。Gemini Robotics 的主干在云端,回答一次不到 160 毫秒;机器人上的本地解码器把它的输出变成一串串动作,补上这段延迟。
Figure 的 Helix 用一个 70 亿参数的视觉语言模型每秒想 7 到 9 次,一个 8,000 万参数的小网络每秒出 200 次动作,控制 35 个自由度。NVIDIA 的 GR00T N1 也分快慢:慢的部分每秒 10 次,快的部分每秒 120 次。
π0.5 把“想”也写成文字:每一步先说出接下来的小任务,比如“拿起砧板”,再给出一串 50 个动作。Gemini Robotics 1.5 也是先想、再动,并把想的过程显示出来。台上的屏慢慢换着小任务,手臂一直在动。
Helix:每秒想 7–9 次,动 200 次 · GR00T N1:10 / 120 次 · Gemini Robotics 主干:< 160 毫秒
数据从哪儿来
机器人数据要人一段段教出来。RT-1 的约 13 万段示范,是操作员拿着两个 VR 手柄、用 13 台机器人花了 17 个月录下的。Gemini Robotics 在一队 ALOHA 2 双臂机器人上录了 12 个月,几千小时。π0 用了约 1 万小时自己采集的数据,来自 7 种机器人构型、68 种任务。
一家的数据不够,大家就把数据拼起来。2023 年的 Open X-Embodiment 汇集了 21 个机构的 60 个数据集:22 种机器人,100 多万条轨迹,527 种技能。各家的动作统一写成手末端的 7 个量,坐标系却没有对齐,所以同一组数在不同的机器人上可能是很不一样的动作。
混入别家的数据有用。在只出现在另一种机器人数据里的技能上,加了这些数据训练的 RT-2-X 成功率是 75.8 %,原来的 RT-2 是 27.3 %,约 3 倍。OpenVLA 用其中的 97 万段,在 64 块 A100 上训练了 14 天。
Open X-Embodiment:22 种机器人 · 100 万+ 条轨迹 · 60 个数据集 · 21 个机构
没见过的东西
换一个没见过的杯子、换一块桌布、换一间屋子,模型还行不行?RT-2 的测试里,在没见过的物体、背景和环境上,RT-1 平均成功 32 %,RT-2 是 62 %;在见过的任务上两者差不多,都在 92 % 左右。
π0.5 在训练时没去过的三户真实人家里收拾厨房和卧室,每个任务试 10 次。训练数据来自约 100 个不同的家时,它的表现已经接近直接在测试的那几户人家里训练的模型。
这些数不能放在一起比。每篇论文用自己的机器人、自己的任务、自己的打分:有的只算成败,有的按完成了几步给分;每个任务往往只试 5 到 20 次。真实世界里还没有大家共用的测试场。
RT-2,没见过的场景:62 %(RT-1 32 %)· 见过的任务:RT-1 92 %,RT-2 91–93 %
还会出错
RT-2 的论文自己列出了做不好的事:抓物体的某个部位(比如把手),训练数据里没有的新动作(比如用毛巾擦东西),灵巧精细的动作(比如叠毛巾)。OpenVLA 在测试的任务上成功率一般不到 90 %。台上这一下就夹空了。
任务越长越难。RT-1 的论文写道,长任务的成功率随步数呈指数下降,所以每一步的成功率特别要紧。π0.5 有时会分心,一个抽屉反复开了又关;手臂挡住视线时,它也看不见要擦的污渍。
安全也不能全交给模型。Gemini Robotics 的报告说,这类模型要接在负责安全的底层控制器上面;他们还发布了 ASIMOV 数据集,检查模型懂不懂“不要把毛绒玩具放在热炉子上”这类常识。数据也贵:动辄上千小时的人工示范。
RT-2 做不好:把手、擦东西、叠毛巾 · OpenVLA:一般不到 90 % · 安全靠底层控制器
拆开来看
台子分成八件:手臂、夹爪和腕部相机、立柱上的深度相机、控制器(模型)、它斜面上的刻度尺、纸带、杯子和布、手臂底下的转接板。
手臂有五个转动关节:底座转向、肩、肘、腕的俯仰和手腕的旋转,末端是一只平行夹爪。本页用解析的逆运动学,把每一步的末端位置换算成关节角。
刻度尺每把 256 格,每 8 格一道短线,每 64 格一个数字。纸带每行是一个动作的 7 个词元。
手臂 · 夹爪 · 深度相机 · 控制器 · 刻度尺 · 纸带 · 杯子和布 · 转接板
实验台
实验台可以换指令,也可以改“每次推理出几个动作”和“推理一次要多久”。手臂按每秒 50 个动作执行;每次推理时它停下来等结果,拿到后把这一串走完,再拍下一张。
读数是:手臂停着等的时间占多少,每秒看几次新画面,以及最长有多久一直在动、却没看新画面。一次只出 1 个动作时,手臂大多在等;一次出 50 个时几乎不停,但每看一眼就要走 1 秒。
滑块和纸带上的词元仍按 RT-2 的格式写出;路径是本页规划的。
指令 · 每次几个动作 · 推理一次多久 · 读数:停着的时间、每秒看几次、最长没看多久
试一试把每次推理出的动作从 1 个加到 50 个,再把推理一次的时间调到 250 毫秒:手臂停着等的时间少了多少?它最长有多久没看新画面?
模型省略了什么
台上没有训练好的模型。手臂的路径由一个简单的规划器生成,再按 RT-2 的格式写成词元:每个量平均切成 256 格,范围是本页自己定的(真实模型的范围来自训练数据:RT-2 用每个量的上下界,OpenVLA 用 1 % 到 99 % 的分位数)。“控制器”是示意:RT-2 的大模型实际在云端运行,OpenVLA、π0 在一块 GPU 上。相机画面是从台上相机的位置渲染的,小方块的大小没有按任何一个模型取。手臂是一只五轴的示意手臂,不是哪一款真实的机器人;关节角由解析的逆运动学算出,夹爪朝下抓取。实验台假设推理时手臂停下来等(同步执行),没有画出边走边算的做法。
几个容易误会的地方
“50 赫兹”是动作的节奏,不是模型的:π0 每 0.5 秒才重新算一次。RT-2 的 62 % 对 32 % 是没见过的场景的平均,在见过的任务上没有提高。不同论文的成功率不能放在一起比:机器人、任务、打分和试的次数都不同。Open X-Embodiment 里 RT-1-X 的“高 50 %”是相对的提高,而且只在几个小数据集上;在大数据集上它反而更差。这类模型学到的是在新场景里用已有的动作,不会凭空学会新动作。FAST 让训练更快,推理反而更慢。各家宣称的“第一个”都是自己说的。
常见问题 · 4
- 机器人模型为什么从视觉语言大模型开始?
网上的图文有几十亿条,机器人数据比不上:最大的机器人数据集也只有十万到一百万条示范。
03指令也是词元 ↑- RT-2 怎样把机器人的动作写成词元?
RT-2 把动作也写成文字。一个动作有 7 个连续的量:手的末端在 x、y、z 上移动多少,绕三个轴转多少,夹爪张开多少。
04动作写成词元 ↑- π0 说的“50 赫兹”是什么意思?
π0 每次写出 50 个动作,按每秒 50 个执行就是 1 秒。它在一块 RTX 4090 上算一次要 73 毫秒,这段时间手臂只走掉 3.65 个动作。
06一次说一串 ↑- 视觉语言动作模型还做不好什么?
RT-2 的论文自己列出了做不好的事:抓物体的某个部位(比如把手),训练数据里没有的新动作(比如用毛巾擦东西),灵巧精细的动作(比如叠毛巾)。
11还会出错 ↑
资料来源
- Brohan 等(2022):RT-1: Robotics Transformer for Real-World Control at Scale
- Brohan 等(2023):RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control
- Google DeepMind(2023-07-28):RT-2: New model translates vision and language into action
- Open X-Embodiment Collaboration(2023):Open X-Embodiment: Robotic Learning Datasets and RT-X Models
- Kim 等(2024):OpenVLA: An Open-Source Vision-Language-Action Model
- Zhao 等(2023):Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware(ALOHA、ACT)
- Black 等(2024):π0: A Vision-Language-Action Flow Model for General Robot Control
- Pertsch 等(2025):FAST: Efficient Action Tokenization for Vision-Language-Action Models
- Physical Intelligence(2025):π0.5: a Vision-Language-Action Model with Open-World Generalization
- Gemini Robotics Team, Google DeepMind(2025):Gemini Robotics: Bringing AI into the Physical World
- Google DeepMind(2025-09-25):Gemini Robotics 1.5 brings AI agents into the physical world
- NVIDIA(2025):GR00T N1: An Open Foundation Model for Generalist Humanoid Robots
- Figure AI(2025-02-20):Helix: A Vision-Language-Action Model for Generalist Humanoid Control
数据
The arm, its tasks and the action tokens on the panel and the tape are the page’s own: a planned gripper path written in the format RT-2 uses (seven dimensions, 256 equal bins each), not the output of a trained model (src/topics/vla/science.js). The camera’s view is rendered from the camera on the mast; its grid of patches is a picture, not any model’s patch size. Material presets, parts and the softbox studio of the site’s model kit are ported from AirsupHQ/machine-skill (MIT, © 2026 Air Supply Technologies Inc.).
本页的文字、图片和模型采用 CC BY-NC 4.0 许可:可以免费用于教学和其他非商业用途,可以修改,请注明出自 world.lapla.si。上面列出的第三方素材仍按各自的许可。
引用这幅图版
拉普拉斯的迷你世界,图版 F44《视觉语言动作模型》,https://world.lapla.si/zh/vla/,CC BY-NC 4.0,2026-10-24 更新。
沿这个问题继续
 图版 F13Transformer 的注意力一个两层、八个头的小 Transformer,在你的浏览器里逐字读一句话,猜下一个字母。每条丝线是一次“注意”,亮度就是它的权重。
 图版 44从噪声里长出来的图许多会画画的 AI,都从一团随机的噪点开始:一步一步,把噪声擦掉。一个小网络在你的浏览器里做同样的事,让一团乱点慢慢凝成一个结。
 图版 F41视频扩散模型一段视频是一块有时间的方块。生成视频的模型先把它压缩、切成小块,再从一团噪声开始,一步步去噪,所有帧一起变清楚。
 图版 F10谐波减速器机器人关节里的谐波减速器:一个椭圆把薄钢杯压弯,转一圈,杯子只退两个齿。一级减速 100 倍,几乎没有间隙。