高斯泼溅
几百张照片,变成几百万个半透明的彩色椭球。画一帧不用问神经网络,只要排序、叠加。
向下滚动
照片进去,实时出来
从一组照片重建一个场景,再从任意角度画出来:神经辐射场(NeRF)在 2020 年做到了照片般的效果,但画一帧要几秒到几十秒。2023 年发表在 SIGGRAPH 上的 3D 高斯泼溅换了一种表示:场景是一大堆三维高斯,每个像一团半透明的彩色椭球。作者报告它能以每秒 30 帧以上的速度渲染 1080p 的画面,画质与当时最好的方法相当。
在 Mip-NeRF 360 数据集的九个场景上,高斯泼溅在一块 A6000 显卡上平均训练 41 分 33 秒,渲染每秒 134 帧(按各数据集原本的分辨率)。作者在 4 块 A100 上把 Mip-NeRF 360 训练了 12 小时,折合单块显卡 48 小时;它每秒渲染 0.06 帧。画质上,Mip-NeRF 360 的平均峰值信噪比略高,27.69 对 27.21 dB(Mip-NeRF 360 的画质数字取自它自己的论文),高斯泼溅在另外两项指标 SSIM 和 LPIPS 上更好。作者的说法是“相当,有时略好”。
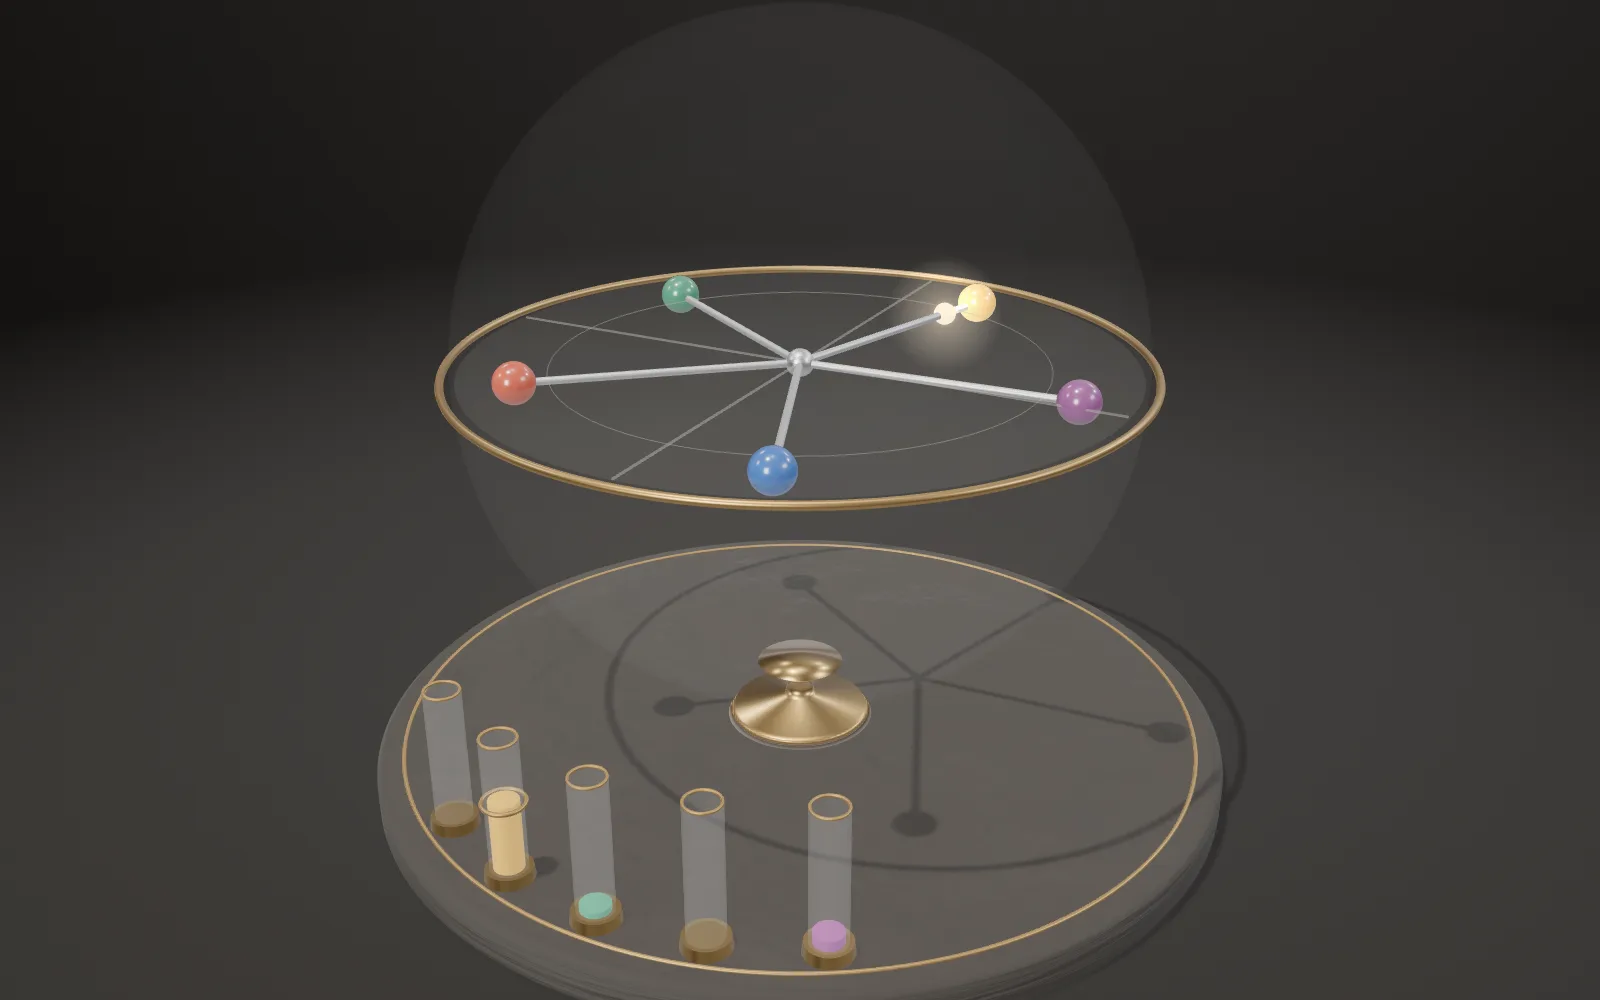
台上是一个转台:一盆盆景,周围 24 台相机。盆景和它的盆此刻由高斯画成,在浏览器里实时渲染,HUD 里是它们的数量和这一页的帧率。这些高斯是页面按模型表面铺的,颜色取自相机拍的照片,没有经过训练;训练在后面的两章里,规模小得多。
Mip-NeRF 360 数据集 · 高斯泼溅(A6000):训练 41 分 33 秒,134 帧/秒 · Mip-NeRF 360:48 小时(折合单卡),0.06 帧/秒
先拍照片
输入是一个静止场景的一组照片,从四周拍。Mip-NeRF 360 的数据集有九个场景,五个在室外、四个在室内,相机绕着中间的物体转一圈;每个场景拍了 100 到 330 张,其中“盆景”有 292 张。按惯例每 8 张留 1 张作检验,不参加训练。
照片要多,角度要全:只有一台相机看到的地方,无法判断它有多远。场景也必须静止,拍摄时动了的东西对不上(会动的场景是后来的工作,见“后来”一章)。
台上 24 台相机,下面一圈 16 台,后面高处 8 台,都对准盆景。它们依次拍照,HUD 里是正在拍的那一张。后面的玩具训练用的就是这 24 张,每张缩到 64 × 64 像素。
每个场景 100–330 张,“盆景” 292 张 · 每 8 张留 1 张检验 · 台上 24 张
相机在哪里
光有照片还不够,还要知道每张照片是在哪里、朝哪个方向拍的。这一步叫运动恢复结构(structure from motion):在不同照片里找到同一个特征点,解出每台相机的位置和朝向,也顺带算出这些点在三维中的位置。论文引用的是 COLMAP 的运动恢复结构(Schönberger 和 Frahm,2016);Mip-NeRF 360 数据集的相机位置就是用 COLMAP 算出来的。
这些稀疏的点是免费的副产品,高斯泼溅就从它们开始:每个点变成一个小小的圆形高斯,大小取它到最近三个点的平均距离,不透明度先设为 0.1(官方代码)。只在一个大立方体里随机撒点也不至于完全失败,但画质明显变差(论文对照实验里三个场景平均 20.42 对 26.05 dB),主要差在背景,拍得少的地方漂浮物更多。
台上的 1,500 个点是代替品:页面从模型表面取点,加一点抖动,颜色取自照片。真正的运动恢复结构只在照片里能对上的纹理处得到点。线框是 24 台相机各自看到的范围。
相机位置 + 稀疏点 · 每个点一个高斯 · 台上 1,500 个点、24 台相机
一个高斯
每个高斯有一个中心位置、一个描述形状的协方差矩阵 Σ、一个不透明度和一组颜色系数。Σ 决定它是圆的、扁的还是细长的,朝向哪边。直接优化 Σ 不行,梯度下降很难保证它一直是合法的(半正定)矩阵;所以分开存三个缩放值 s 和一个表示旋转的四元数 q,再算 Σ = R S Sᵀ Rᵀ。
不透明度经过 S 形函数压在 0 和 1 之间,缩放取指数,四元数先归一化。高斯没有硬的边:它从中心向外按钟形曲线变淡,再乘上不透明度。一个高斯在官方格式里存 59 个有用的数:位置 3 个、缩放 3 个、旋转 4 个、不透明度 1 个、颜色 48 个。
放大的那个是盆上的一个高斯:圆盘是它在自己平面里的密度,细线圈在两个标准差处,外面一层淡淡的壳是它在三个方向上的范围;HUD 里是它的参数。指针下对那个像素贡献最大的高斯,会换上来放大。
Σ = R S Sᵀ Rᵀ · 位置 3 + 缩放 3 + 旋转 4 + 不透明度 1 + 颜色 48 = 59
换个角度,颜色不同
颜色用球谐函数表示:同一个高斯从不同方向看,颜色可以不同,釉面的高光就靠这一项。论文用了 4 个频带(0 到 3 阶),每个颜色通道 16 个系数,三个通道共 48 个。
训练时先只学 0 阶,也就是不随方向变的底色,之后每 1000 步加一阶。不这样做,拍摄角度有缺口时底色会学错。论文的对照实验里(三个场景平均),去掉球谐、每个高斯只有一种颜色,峰值信噪比从 26.05 降到 25.35 dB。
台上只留了前两个频带,每个通道 4 个系数:底色,加上随方向线性变化的一项,由看到它的那些照片用最小二乘拟合。相机绕着盆来回转,HUD 里是盆上一个高斯此刻相对底色的亮度。
4 个频带 · 每通道 16 个系数,共 48 个 · 每 1000 步加一阶 · 台上 2 个频带
排好次序,层层叠上
画一帧时,每个三维高斯先投影成屏幕上的二维高斯:Σ′ = J W Σ Wᵀ Jᵀ,W 是相机的旋转,J 是透视投影在这一点的线性近似(出自 2001 年的 EWA 泼溅)。屏幕分成 16 × 16 像素的块,每个高斯记到它碰到的每一块里,以“块号 + 深度”为键,在 GPU 上做一次基数排序。
然后每块里的每个像素按深度从前往后叠:C = Σ cᵢ αᵢ Πⱼ<ᵢ (1 − αⱼ)。αᵢ 是这个高斯在该像素的值乘上它的不透明度,最多 0.99,小于 1/255 的跳过;累积的不透明度快要超过 0.9999 时停下。排序是按块、按中心的深度,不是逐像素精确排序,所以在一些情形下混合只是近似的;高斯接近一个像素大小时,误差可以忽略。
红线是一台相机的一个像素看出去的光线。它遇到的高斯被标红,HUD 里从前往后列出:每个的 α、叠到它之前还剩的透光率 T,和它给这个像素添的一份 α·T。台上用 CPU 排序,GPU 从后往前用“覆盖”运算叠,结果与从前往后相同。
C = Σ cᵢ αᵢ Tᵢ · 16 × 16 像素一块 · 一次 GPU 基数排序 · α ≤ 0.99
剖开来看
把台上的高斯剖开,里面是空的:页面只把它们铺在表面上。训练出来的场景里,高斯也大多聚在表面附近:起点是在表面上找到的点,新的高斯只在画面和照片还对不上的地方复制或拆分出来。但没有什么把它们限制在表面上,有的会飘在空中,就是“漂浮物”。论文摘要说,这种表示保留了连续体积表示便于优化的性质,又避免在空的空间里做不必要的计算。
各向异性的高斯可以是扁的或细长的:能沿表面铺开,在垂直方向很薄。论文做过对照,把每个高斯限制成圆球,画质明显下降,三个场景的平均峰值信噪比从 26.05 降到 25.23 dB:各向异性的高斯更能贴合表面。
台上的剖面从前往后推到盆景中间。针叶、树干和盆壁都只是一层壳。
台上:只在表面 · 限制成圆球:25.23 dB,各向异性:26.05 dB(论文对照实验,三个场景平均)
和照片比,往回改
训练时每一步挑一张照片,从那台相机的位置画出所有高斯,和照片比。误差是 L1(逐像素差的绝对值)和 D-SSIM(结构相似性的差)的加权和,λ = 0.2。整个光栅化过程可以求导:误差的梯度顺着混合、投影一路传回每个高斯的位置、缩放、旋转、不透明度和颜色(梯度怎样往回传,见图版「反向传播」)。作者为这些参数手写了导数,没有依赖自动求导。
优化器是 Adam,位置的学习率随步数指数衰减。论文训练 30,000 步,三个数据集在 A6000 上平均 27 到 42 分钟;7,000 步时已经不错。这里没有神经网络:被训练的就是这些高斯本身。
台上的玩具就是这个循环,在浏览器里实时运行:24 张 64 × 64 像素的照片,1,500 个起点,2,000 步,只用 L1 误差。24 张照片上的平均 L1 误差从 0.120 降到 0.017。HUD 左边是一张照片,右边是同一台相机此刻画出的样子。
L = (1 − λ)L1 + λ·D-SSIM,λ = 0.2 · Adam · 30,000 步 · 台上 2,000 步,L1 0.120 → 0.017
克隆、拆分、剪掉
起点只有稀疏的点,不够盖住整个场景。训练中每 100 步做一次自适应密度控制:一个高斯在屏幕上的位置梯度,在看到它的视角上平均,超过 0.0002 的,说明这一带还没重建好。小的高斯复制一个同样大的,补上缺少细节的地方;大的拆成两个,缩放除以 1.6,位置从原来的高斯里抽样。
几乎透明的高斯被删掉(官方代码的门槛是不透明度低于 0.005)。每 3000 步把所有不透明度压到接近零(官方代码只做到第 15,000 步),让优化重新决定哪些该留。论文说,优化会卡在相机附近的“漂浮物”上,让高斯的数量无端增加;这一步能抑制这种增长。密度控制在第 500 到 15,000 步之间进行(官方代码);论文里的真实场景最后有 100 万到 500 万个高斯(合成场景是 20 万到 50 万个)。
台上每 50 步做一次,门槛按玩具的照片尺寸调过,第 1,000 步重置一次不透明度。新复制的高斯短暂泛琥珀色,拆出来的泛红色。玩具从 1,500 个点长到 2,917 个高斯:复制 687 次,拆分 1,270 次,删掉 540 个。
每 100 步 · 门槛 0.0002 · 拆分时缩放 ÷ 1.6 · 每 3000 步重置不透明度 · 台上 1,500 → 2,917
为什么快
NeRF 把场景存在一个多层感知机里:输入一个位置和一个方向,输出那里的密度和颜色。画一个像素,要沿着它的光线取点,一个个去问网络:粗网络均匀地取 64 个点,细网络在重要的地方再取 128 个,连同前 64 个一共问 192 个,每条光线 256 次查询。论文里一张图要 1.5 亿到 2 亿次查询,在一块 V100 上约 30 秒。
高斯泼溅不问网络。场景是一张明明白白的清单,每个高斯的位置、形状、颜色都直接写着。画一帧就是投影、排序、叠加,由作者为显卡写的光栅化程序并行完成,而且只算有东西的地方。代价是存得多,见下一章。
红线上的 192 个小点,是 NeRF 在这一条光线上要取的样点;同一条光线上,台上的高斯只有 HUD 里的那几个。
NeRF:每条光线 64 + 192 次查询,一张图约 30 秒(V100)· 高斯泼溅:投影、排序、叠加
代价
存得多:在高斯泼溅论文的表里,Mip-NeRF 360 数据集上训练好的高斯平均 734 MB,Mip-NeRF 360 的网络只有 8.6 MB。官方格式里每个高斯 62 个 32 位浮点数(其中 3 个法向量写的是零),248 字节,一百万个约 248 MB。训练大场景时,显存峰值可以超过 20 GB。
看得少的地方会出错:作者写道,场景没有拍好的区域会有瑕疵,会出现拉长的、“斑块状”的高斯;优化造出大的高斯时,视角一变偶尔会“跳”,多见于颜色随视角变化的地方。论文没有加任何正则化。它还需要足够多的照片、准确的相机位置和静止的场景。
从下往上看盆景:叶片下面几乎没有相机拍到,那里的高斯稀稀拉拉,甚至是空的。HUD 里是台上的高斯按官方格式存下来的大小。
734 MB 对 8.6 MB · 每个高斯 248 字节 · 训练大场景时显存可超过 20 GB
后来
会动的场景:让每个高斯随时间移动和旋转,颜色、不透明度和大小保持不变,就能同时得到新视角和三维跟踪(Luiten 等,2024);4D 高斯泼溅用一个小网络预测高斯的形变,在 RTX 3090 上渲染 800 × 800 的合成场景每秒 82 帧。压缩:用码本和量化,真实场景的存储平均缩小 26 倍、最多 31 倍,渲染也更快。
前馈:不再为每个场景单独优化,而是训练一个网络,从一对已知相机位置的照片直接预测一组高斯(pixelSplat;MVSplat 参数少十倍,快一倍以上)。表面:把高斯压成二维的圆盘,得到更准的几何(2D 高斯泼溅)。抗锯齿:Mip-Splatting 减轻了拉近拉远时的伪影,是 CVPR 2024 的两篇最佳学生论文之一。2026 年,Khronos 组织正式批准了 glTF 2.0 存储高斯泼溅的扩展 KHR_gaussian_splatting(2 月发布候选版,9 月在规范仓库里标为已批准)。
台上的盆景仍是 2023 年论文里的那种表示:一团静止的三维高斯,各自带着随方向变化的颜色。
会动的场景 · 压缩 26 倍 · 从两张照片预测 · 二维圆盘 · 抗锯齿 · glTF 扩展
拆开来看
一台拍摄台:炭黑色的底座和刻度盘;可以转的铝制转盘,上面是红木几架、盆景和它的高斯;下面一圈 16 台相机,后面高处 8 台,它们拍的照片训练出台上的玩具。每一件都可以单独托出来看。
实验台
可以把画面在“照片般”和“颗粒”之间切换,放大或缩小所有高斯,关掉随方向变化的颜色,藏起相机,换成玩具训练并回看它的任一步,或者只用 6 张、12 张照片重新训练。
试一试在实验台上用 6 张照片重新训练,再用 24 张:训练完的高斯各有多少个?从低处看盆景的叶片下面,两次有什么不同?
模型省略了什么
台上没有真实的拍摄。盆景、照片和高斯都是页面做的:照片是 three.js 渲染的模型,不是相机拍的;“运动恢复结构的点”是从模型表面取的,不是匹配特征得来的;相机的位置是已知的。大部分章节里台上的高斯(台式电脑上四万多个)是页面按模型表面铺好、再从 24 张照片拟合颜色的,没有经过优化,颜色只有两个频带的球谐;看不到的面上的高斯被丢掉。训练两章里的玩具是真正的优化,但小得多:24 张 64 × 64 像素的照片、1,500 个起点、2,000 步、只用 L1 误差、8 × 8 像素的块;密度控制每 50 步一次,门槛和学习率按玩具调过,第 1,000 步重置一次不透明度。真实的场景是上百张百万像素的照片、几百万个高斯和 30,000 步。
一个常见的误解
常有人以为高斯泼溅是 AI “想象”出来的三维,或者反过来,以为里面没有机器学习。都不对。2023 年的原始方法不含神经网络,场景是一组显式的高斯;但这些高斯是用梯度下降(Adam)对照照片训练出来的,和训练神经网络的办法一样。它也不会凭空补全:没拍到的地方,只能空着或出错。还有人把高斯叫作“粒子”,论文里没有这个说法;每个高斯是一团没有硬边、有方向、颜色随视角变化的半透明分布。
常见问题 · 4
- 高斯泼溅为什么比 NeRF 快?
高斯泼溅不问网络。场景是一张明明白白的清单,每个高斯的位置、形状、颜色都直接写着。
10为什么快 ↑- 一个三维高斯由哪些参数组成?
每个高斯有一个中心位置、一个描述形状的协方差矩阵 Σ、一个不透明度和一组颜色系数。
04一个高斯 ↑- 为什么要先算出相机的位置?
光有照片还不够,还要知道每张照片是在哪里、朝哪个方向拍的。
03相机在哪里 ↑- 高斯泼溅是怎样训练的?
训练时每一步挑一张照片,从那台相机的位置画出所有高斯,和照片比。
08和照片比,往回改 ↑
资料来源
- Kerbl、Kopanas、Leimkühler、Drettakis(2023):3D Gaussian Splatting for Real-Time Radiance Field Rendering,ACM Transactions on Graphics 42(4),第 139 篇,SIGGRAPH 2023;arXiv:2308.04079(≥30 帧/秒 1080p、表 1、表 3 对照实验、Σ = R S Sᵀ Rᵀ、4 个频带、分块光栅化、自适应密度控制、局限)
- 同上,ACM 版 doi:10.1145/3592433
- 官方代码 graphdeco-inria/gaussian-splatting 与 diff-gaussian-rasterization(初始不透明度 0.1、删除门槛 0.005、第 500–15,000 步、.ply 每个高斯 62 个浮点数;仅限非商业研究使用)
- Barron 等(2022):Mip-NeRF 360: Unbounded Anti-Aliased Neural Radiance Fields,CVPR 2022,arXiv:2111.12077(九个场景、每个 100–330 张、COLMAP、每 8 张留 1 张)
- Mip-NeRF 360 数据集(“盆景”292 张,按发布的文件数)
- Mildenhall 等(2020):NeRF: Representing Scenes as Neural Radiance Fields for View Synthesis,ECCV 2020,arXiv:2003.08934(64 + 128 个样点、每条光线 256 次查询、每张图约 30 秒)
- Schönberger、Frahm(2016):Structure-from-Motion Revisited,CVPR 2016(COLMAP)
- Zwicker、Pfister、van Baar、Gross(2001):EWA Volume Splatting,IEEE Visualization 2001
- Luiten、Kopanas、Leibe、Ramanan(2024):Dynamic 3D Gaussians: Tracking by Persistent Dynamic View Synthesis,3DV 2024,arXiv:2308.09713
- Wu 等(2024):4D Gaussian Splatting for Real-Time Dynamic Scene Rendering,CVPR 2024,arXiv:2310.08528(800 × 800 合成场景,RTX 3090,82 帧/秒)
- Niedermayr、Stumpfegger、Westermann(2024):Compressed 3D Gaussian Splatting for Accelerated Novel View Synthesis,CVPR 2024,arXiv:2401.02436(平均 26 倍、最多 31 倍)
- Charatan、Li、Tagliasacchi、Sitzmann(2024):pixelSplat: 3D Gaussian Splats from Image Pairs for Scalable Generalizable 3D Reconstruction,CVPR 2024,arXiv:2312.12337
- Chen 等(2024):MVSplat: Efficient 3D Gaussian Splatting from Sparse Multi-View Images,ECCV 2024,arXiv:2403.14627(参数少 10 倍,快 2 倍以上)
- Huang 等(2024):2D Gaussian Splatting for Geometrically Accurate Radiance Fields,SIGGRAPH 2024,arXiv:2403.17888
- Yu 等(2024):Mip-Splatting: Alias-free 3D Gaussian Splatting,CVPR 2024,arXiv:2311.16493
- CVPR 2024 获奖论文(Mip-Splatting:最佳学生论文)
- Khronos Group:glTF 扩展 KHR_gaussian_splatting(状态:已由 Khronos 批准)
数据
The bonsai, its 24 photographs, the starting points, the Gaussians laid on the model and the toy optimisation are the page’s own, made and computed in the browser (src/topics/splatting/; the photographs and points in public/splatting/ were rendered from the same model). Nothing on the bench comes from a real capture. Leaf atlas: ambientCG LeafSet024 (CC0). Material presets, parts and the softbox studio of the site’s model kit are ported from AirsupHQ/machine-skill (MIT, © 2026 Air Supply Technologies Inc.).
本页的文字、图片和模型采用 CC BY-NC 4.0 许可:可以免费用于教学和其他非商业用途,可以修改,请注明出自 world.lapla.si。上面列出的第三方素材仍按各自的许可。
引用这幅图版
拉普拉斯的迷你世界,图版 F37《高斯泼溅》,https://world.lapla.si/zh/splatting/,CC BY-NC 4.0,2026-10-22 更新。
沿这个问题继续
 图版 F18神经网络怎样学习一块按真实误差铣出来的铝制地形,一颗按真实梯度往下走的钢球,一架玻璃和黄铜做的小网络:正向的光把数送到输出,反向的光把每根杆该拧多少送回来。
 图版 C02单反相机取景时,镜头后的一面镜子把光送进五棱镜;按下快门,镜子抬起,两道布帘依次掠过胶片。
 图版 F11激光雷达车顶上的激光雷达给光计时:一个脉冲来回 6.67 纳秒就是 1 米。128 束激光转一圈,四周的街道变成几十万个带坐标的点。
 图版 F13Transformer 的注意力一个两层、八个头的小 Transformer,在你的浏览器里逐字读一句话,猜下一个字母。每条丝线是一次“注意”,亮度就是它的权重。