追踪模型内部的步骤
问“Dallas 所在州的首府”,模型答 Austin;归因图显示,中间先到了 Texas。画的是替代模型,只看清一部分。
向下滚动
Dallas 和 Austin 之间
把“Fact: the capital of the state containing Dallas is”(事实:Dallas 所在州的首府是)交给语言模型 Claude 3.5 Haiku,它接着写 Austin,概率 98%。要答对,看起来要走两步:Dallas 在 Texas;Texas 的首府是 Austin。
它真的在内部走了这两步吗?也可能它在训练的文字里见过差不多的句子,记住了答案。从外面看,两种办法写出来的都是 Austin。
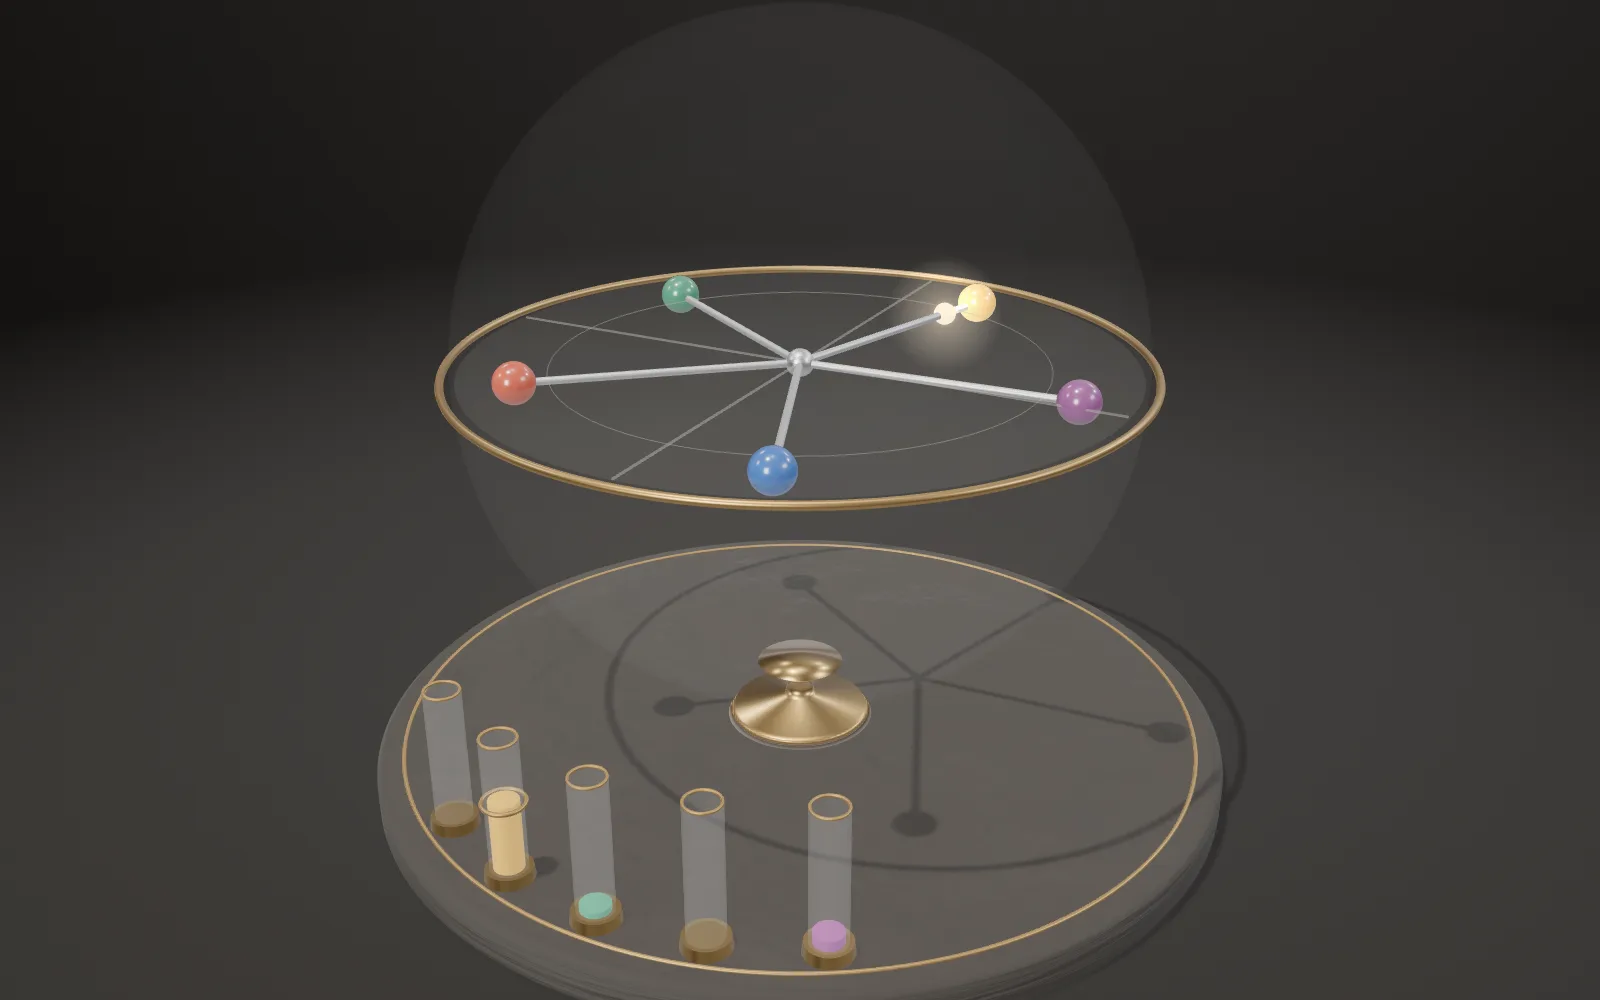
台上是一台人工电话交换台:左边一排是提示里的词,右边一排是模型可能写的下一个词,亮着的是 Austin。中间这块板,是要看清的地方。
提示:Fact: the capital of the state containing Dallas is · 下一个词:Austin,98%
换成读得懂的零件
模型里的神经元大多一身多职,一个神经元会对许多不相干的东西有反应,直接读很难。研究者先训练一个“跨层转码器”:一层层的“特征”,每个特征从模型的某一层读入,写到这一层和后面所有层的 MLP 输出里;训练的目标是用尽量少同时活跃的特征,重建原来 MLP 的输出。特征是什么,见“稀疏自编码器”这一页。
把模型的 MLP 换成这些特征,就得到一个替代模型。给 Claude 3.5 Haiku 用的这一套有 3000 万个特征。它并不完全像原模型:在一个 18 层的小模型上,最大的一套约一半时候和原模型选同一个下一个词(挑的是原模型答对、但把握不到 80% 的词)。
所以看一句话时,研究者再做一个局部替代模型:注意力的模式照搬原模型在这句上的结果,每一层差多少,就补一个“误差节点”。这样在这一句上,它的每个数都和原模型一样;作者也说,这不保证两者用的是同一种机制。特征板左上角标着 error 的那一行,就是一个误差节点:没有连线通向它。
特征:从一层读入,写到后面各层 · Haiku 的一套:3000 万个特征 · 18 层小模型:约一半时候选同一个词 · 误差节点:补上差的部分
把作用画成连线
在这一句上,研究者画一张归因图。节点有四种:提示里的词、每个位置上活跃的特征、误差节点、候选的下一个词(凑够 95% 的概率,最多 10 个)。一条连线是一个节点对另一个节点的直接作用,等于前者的激活乘一个权重;一个特征的输入,就是指向它的连线之和。
这样的图起初有上百万条连线。只留最重要的:按默认设置,节点约少到十分之一,能解释的部分约少两成;剩下的仍常有几百个节点、几万条连线。研究者再把意思相近的特征手工归成一组,叫“超节点”,起一个粗略的名字,比如 Texas、say a capital(说出一个首府)。
台上中间这块板只插了 6 组超节点:一盏灯是一组,一根跳线是一条连线,越粗表示作用越强(本页的示意,分三档);细而暗的几根,代表剪掉的那些。
节点:词 · 特征 · 误差 · 候选词 · 连线:激活 × 权重 · 剪枝:节点约少到十分之一,解释的部分约少两成 · 超节点:手工归组
先到 Texas
图里,Dallas 的特征(加上一点 state 的特征)激活了一组和 Texas 有关的特征;capital 这个词激活了“说出一个首府”的特征。Texas 和“说出一个首府”一起把 Austin 推高:一路直接连到输出 Austin,一路经过“说出 Austin”的特征。
图里还有一条捷径:从 Dallas 直接连到“说出 Austin”。两步和捷径同时存在。论文说,替代模型在这里确实做了多步推理,也提醒:这张图把真实的机制简化了很多。
台上,亮着的红色跳线是两步的那条路:Dallas → Texas → 说出 Austin → Austin,其余的暗下去;深红的是 capital 那一路;细的黑线里有那条捷径。
Dallas → Texas → 说出 Austin → Austin · capital → 说出一个首府 → Austin · 捷径:Dallas → 说出 Austin
把 Texas 调低
一张图只是假设。证据要回到原模型里找:把一组特征的激活压成原值的负几倍,或者把另一组加进去,看后面的特征和答案是不是照图预测的那样变。台上,扳下的键表示一次干预,红灯是被压低的那一组。
把 Texas 这一组压到 −2 倍,“说出 Austin”的特征只剩原来的 21%,Austin 的概率从 98% 掉到 6%。把“说出一个首府”压到 −2 倍,模型改说 Texas(76%)。
把 Texas 压下去,再加上从“Oakland 所在州的首府是”那句话里找到的 California 特征(+2 倍),答案变成 Sacramento(97%);换成 Georgia,答 Atlanta(78%)。换成 British Columbia、China、Byzantine Empire,要加到 +8 倍,答案是 Victoria、Beijing、Constantinople。
Texas −2×:Austin 98% → 6% · 说出一个首府 −2×:Texas 76% · Texas −2×、California +2×:Sacramento 97%
先想好韵脚
让模型写押韵的两行:“A rhyming couplet: / He saw a carrot and had to grab it,”(他看见一根胡萝卜,忍不住要抓住它)。它接着写:“His hunger was like a starving rabbit”(他饿得像一只饿坏的兔子)。
语言模型一次写一个词,可以边写边凑韵。图里是另一种情况:第二行还没开始,在换行符上已经有代表 rabbit 和 habit 的特征在起作用,它们由“押 it 韵”的特征引出;行尾写 rabbit,是它们推动的。作者把这叫作计划,指的就是这些能测量的效果。
改它们,行尾就跟着改。只看最后一个词:原来 rabbit 81%、habit 19%;把 rabbit 压到 −10 倍,habit 升到 95%。压低 rabbit 和 habit、在换行符上注入 green,整行重写 500 次,73% 以 green 结尾,比如 “freeing it from the garden’s green”。这种干预只在换行符上起作用。在随机挑的 25 首诗里注入 rabbit 或 green,七成行尾换成了注入的词;代表计划词的特征,他们只在约一半的诗里找到。
换行符上:rabbit、habit · rabbit −10×:habit 95% · 注入 green:73% 的行以 green 结尾 · 25 首诗:七成
说的和算的
问 36 + 59,模型答 95。图里它分两路同时算:一路只估大小,“36 左右加 60 左右”,得到“和在 92 左右”;一路只管个位,“个位 6 加个位 9”,查到“和的个位是 5”。两路合起来,得出 95。个位那一步像背熟的一位数加法表。
压低“个位是 6”的特征,它答 98:十位没变,个位成了 9 加 9 的个位。压低“个位是 9”,它答 91,而不是 92;作者提醒,这样推算要打个折扣。
再问它是怎么算的,它说:先算个位,6 + 9 = 15,进 1;再算十位,3 + 5 + 1 = 9,得 95。图里没有这样的进位。论文的解释是:模型学会解释,是模仿训练文字里的解释;学会做,是另一种过程;它对自己的这种能力没有“元认知”。这是这一道题上的结果。
估大小:~36 + ~60 → 和约 92 · 个位:_6 + _9 → 个位是 5 · 合起来:95 · 它自己说:先算个位再进位
看不见的地方
作者说,对他们试过的提示,归因图大约四分之一能给出满意的解释;论文里挑出来的是成功的例子,即便这些,也只看到模型机制的一小部分。
图画的是替代模型,不是原模型本身,所以它对原模型只是假设,要靠干预去验证。它不解释注意力为什么看向某个词;误差节点没有来路,也读不懂;它只画活跃的特征,“为什么没亮”看不到;提示长过约一百个词元,还没有用过。即使只有几十个词的提示,读懂一张图也要几个小时。
转码器本身也要算力:作者估算,给开放模型 Gemma 2 2B 训练 200 万个特征,约要 210 个 H100 小时。2025 年 5 月,画归因图的工具开源,可以在 Gemma-2-2B、Llama-3.2-1B 等开放模型上用。“神经网络学会规律时,里面长出了什么”,另见“先背答案,再学会规律”这一页。
约四分之一的提示:满意的解释 · 画的是替代模型 · 注意力的来由看不到 · 读一张图:几个小时
拆开来看
台上:木柜里三块插孔板,左边是提示里的词,中间是特征,右边是下一个词;每块板上是硬橡胶的插孔条、黄铜插孔、指示灯和打字的名条;跳线两头是插头;前面的键板上有备用的插头、监视灯和扳键。交换台只是比喻:真的交换台一次接通一条线,归因图里是许多条同时起作用、有强有弱、有正有负的连线。
木柜 · 提示词的插孔板 · 特征的插孔板 · 下一个词的插孔板 · 跳线 · 键板
实验台
这里是本页写的一个玩具网络,不是 Claude:几个有名字的单元,权重是手工定的。选一个城市,关掉州的特征或“说出一个首府”,或者把州换成另一个,看答案和连线怎样变。
跳线的粗细就是玩具里的“激活 × 权重”;关掉一个单元,就是把它的激活定为 0。
玩具网络 · 手工定的权重 · 不是 Claude
试一试在实验台上关掉“说出一个首府”:玩具网络改说了什么?再关掉州的特征呢?
模型省略了什么
台上的交换台是本页的模型。插孔板上只有论文简化图里的几组超节点;真实的图有几百个节点、几万条连线,还有误差节点。跳线的粗细和灯的亮度只分三档,是示意,不是测得的数值;HUD 里的百分比才是论文图里的数。归因图的连线有正有负,这里只画了正的。加法那一章把图里的几层合成了两层。实验台上的网络是玩具。
几个容易误会的地方
归因图不是模型的接线图:它画的是一个替代模型在一句话上的计算,连线的权重在原模型里并不存在,结论要靠干预去验证。“推理”“计划”是作者对一些能测量的效果的叫法(压低或注入一组特征,答案跟着变),不是说模型像人一样思考。图里两步推理和捷径同时存在,不能说模型完全没有记住答案。几个比例不要混:约四分之一的提示得到满意的解释;18 层小模型上,替代模型约一半时候和原模型选同一个词;约一半的诗里找到计划词的特征;25 首诗里注入,七成成功。模型对加法的解释和图不一样,论文没有说它在撒谎。
常见问题 · 5
- 模型答出 Austin 时,内部经过了什么?
图里,Dallas 的特征(加上一点 state 的特征)激活了一组和 Texas 有关的特征;capital 这个词激活了“说出一个首府”的特征。
04先到 Texas ↑- 归因图是怎样画出来的?
在这一句上,研究者画一张归因图。节点有四种:提示里的词、每个位置上活跃的特征、误差节点、候选的下一个词(凑够 95% 的概率,最多 10 个)。
03把作用画成连线 ↑- 怎样验证一张归因图?
一张图只是假设。证据要回到原模型里找:把一组特征的激活压成原值的负几倍,或者把另一组加进去,看后面的特征和答案是不是照图预测的那样变。
05把 Texas 调低 ↑- 语言模型写押韵诗时会先想好韵脚吗?
语言模型一次写一个词,可以边写边凑韵。图里是另一种情况:第二行还没开始,在换行符上已经有代表 rabbit 和 habit 的特征在起作用,它们由“押 it 韵”的特征引出;行尾写 rabbit,是它们推动的。
06先想好韵脚 ↑- 归因图能解释多少?
作者说,对他们试过的提示,归因图大约四分之一能给出满意的解释;论文里挑出来的是成功的例子,即便这些,也只看到模型机制的一小部分。
08看不见的地方 ↑
资料来源
- E. Ameisen 等(2025):Circuit Tracing: Revealing Computational Graphs in Language Models,Transformer Circuits Thread(跨层转码器、替代模型、归因图、剪枝、干预,局限一节)
- J. Lindsey 等(2025):On the Biology of a Large Language Model,Transformer Circuits Thread(Claude 3.5 Haiku 上的例子:两步推理、押韵的计划、加法;能解释多少)
- Anthropic(2025):Tracing the thoughts of a large language model(两篇论文的摘要)
- Anthropic(2025):Open-sourcing circuit tracing tools(开源工具和 Neuronpedia 前端)
- circuit-tracer(GitHub,MIT 许可):在开放模型上画归因图的库
- S. G. McMeen、K. B. Miller(1912):Telephony(人工交换台的插孔、插头、塞绳、键架;布景的依据)
数据
Attribution graphs, the replacement model and every example after E. Ameisen, J. Lindsey, A. Pearce, W. Gurnee, N. L. Turner, B. Chen, C. Citro et al., “Circuit Tracing: Revealing Computational Graphs in Language Models”, and J. Lindsey, W. Gurnee, E. Ameisen, B. Chen, A. Pearce, N. L. Turner, C. Citro et al., “On the Biology of a Large Language Model” (Transformer Circuits Thread, Anthropic, 27 March 2025). Probabilities and intervention strengths as printed in their figures. Open tools: circuit-tracer (M. Hanna and M. Piotrowski, MIT licence) and the Neuronpedia graph front end (Decode Research, Apache 2.0), released 29 May 2025. The switchboard, its typed strips and its cords are this page’s model, after period descriptions (S. G. McMeen and K. B. Miller, Telephony, 1912; K. B. Miller, American Telephone Practice, 1905); a metaphor, not a picture of the papers’ figures. The bench’s network is a toy written for this page. Material presets and the model kit as on the site’s other model plates (public/looks/CREDITS.md).
本页的文字、图片和模型采用 CC BY-NC 4.0 许可:可以免费用于教学和其他非商业用途,可以修改,请注明出自 world.lapla.si。上面列出的第三方素材仍按各自的许可。
引用这幅图版
拉普拉斯的迷你世界,图版 F65《追踪模型内部的步骤》,https://world.lapla.si/zh/circuits/,CC BY-NC 4.0,2026-11-05 更新。
沿这个问题继续
 图版 F31稀疏自编码器研究者认为,大模型一层里的数叠着比数本身多得多的东西。稀疏自编码器把它们拆成一条条线,好起名字、做实验。台上是缩小版:一个把六样东西挤进两个数的小模型,和读它的一本八条线的字典,全部在浏览器里计算。
 图版 46先背答案,再学会规律一个小神经网络学 24 小时制的钟点加法。练习题它很快全做对了,靠的是死记;过了很久,它才忽然答对从没见过的题。它的里面,长出了几只钟。